


来源:InTimeLab
原文链接:https://mp\.weixin\.qq\.com/s/ssgc7dZJDdZAwkUfJ3E7EA
近日,由InTimeLab、腾讯大语言模型部等单位合作完成的研究成果《StrucTab: A Structured Optimization Framework for Table Parsing》被 ECCV 2026 接收。论文从建模、优化、评测三个层面系统性重构了表格解析范式:提出显式结构推理模型 StrucTab、统一强化学习框架 Uni-TabRL,以及大规模真实场景基准 TableVerse-5K。仅 1B 参数的 StrucTab 在所有公开基准上取得 SOTA,平均 TEDS 反超 Gemini 2.5 Pro 7.13%、GPT-5 19.14%。代码与基准已开源。
表格解析:不只是"看图写 HTML"
表格解析旨在将表格图像转换为 HTML/Markdown 等结构化表示,需要模型同时感知复杂的空间布局与文本内容。近年来视觉语言模型(VLM)推动了端到端解析,但普遍存在一个根本性缺陷:只监督最终输出,跳过了理解复杂结构所必需的显式中间推理。

StrucTab 从三个层面突破现有 VLM 端到端范式的局限:(b) 建模——人类式序列推理;(c) 优化——基于分解式细粒度奖励的 Uni-TabRL;(d) 评测——大规模真实场景基准 TableVerse-5K。
现有端到端 VLM 把表格解析当成"扁平的一维图像到文本任务",仅靠模仿最终序列化输出,难以真正内化复杂表格的拓扑逻辑。一个自然的问题是:能否让模型显式地建模中间推理过程,而非黑盒式地从最终输出反推结构逻辑?
现有 RL 奖励的两难困境
强化学习(RL)是提升解析质量的有力手段,但现有奖励设计存在根本缺陷。
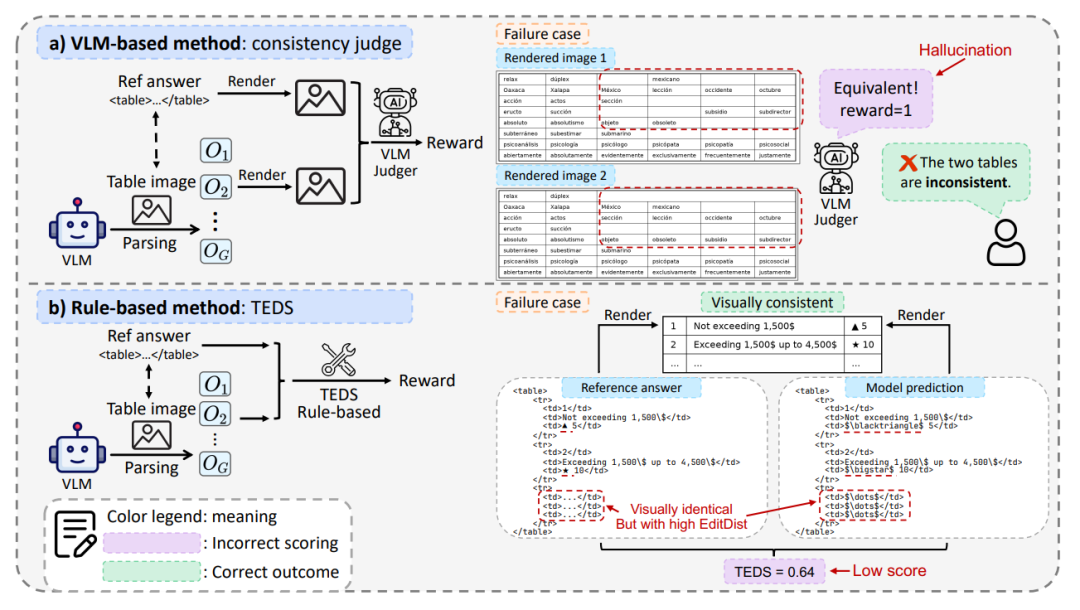
现有表格解析 RL 奖励设计的局限。上:基于 VLM 裁判的方法依赖 VLM 比较渲染结果,易因幻觉或错配引入噪声监督;下:基于规则的 TEDS 在视觉等价但存在多种合法表达时(尤其公式密集场景)会给出误导性打分。
VLM 裁判方法。
规则方法(TEDS)。
这些问题导致优化信号不稳定、含糊,使 RL 在表格解析上的潜力远未被释放。
建模层:人类式结构分解与序列推理
受人类"先看全局布局、再解析局部合并、最后重建内容"的认知过程启发,论文将表格解析重构为显式结构推理。

(a) 显式提供行列数、合并单元格等结构线索,能一致提升解析精度;(b) 纠正第一个结构错误可显著降低后续结构错误率,并提升下游生成置信度。这验证了中间结构信号在现有模型中被严重低估。
论文将解析分解为三个互补子任务,并通过课程式训练逐步统一:

StrucTab 结构化优化框架。上:课程训练将原子结构技能逐步整合为统一推理;下:Uni-TabRL 通过细粒度分解奖励实现稳定优化。
行列计数(Row-Column Counting)。
合并单元格分析(Merged-Cell Analysis)。
课程式序列推理。
优化层:Uni-TabRL 分解式细粒度奖励
针对现有奖励的噪声与含糊问题,Uni-TabRL 基于 GRPO,将整体奖励分解为三个互补组件,分别监督生成有效性、结构正确性与内容保真度。

Uni-TabRL 实现流水线。(a) 1D 探针结构奖励:将预测与参考表格线性化为单元格序列,以首个错误前的正确匹配比例作为奖励;(b) 表格图像渲染流水线:将 HTML 渲染为标准化图像用于去风格化。
有效性奖励(Validity)。
结构奖励(1D Probe)。
内容奖励(Anchor-Guided Destylization)。
评测层:TableVerse-5K 真实场景基准
现有基准多把表格解析当作辅助子任务,规模小、场景单一。论文构建了 TableVerse-5K——迄今规模最大、最多样、结构最复杂的真实场景表格解析基准。

TableVerse-5K 构建流程。数据涵盖学术论文、海报、报告等多来源,覆盖扫描、印刷拍摄、手写等场景;标注采用多 VLM 预标注(PaddleOCR-VL / HunyuanOCR / MinerU 2.5)+ 多阶段人工校验的混合策略。
相比 OmniDocBench(512)、CC-OCR(300)、OCRBench v2(700),TableVerse-5K 拥有 5000 张高质量标注表格,平均合并单元格数(5.10)与结构复杂度均显著更高,并同时覆盖扫描、拍摄、手写三类场景。
实验:1B 模型全面刷新 SOTA
StrucTab 在三个公开基准与 TableVerse-5K 上全面取得 SOTA。仅 1B 参数便大幅超越闭源大模型——平均 TEDS 反超 Gemini 2.5 Pro 7.13%、GPT-5 19.14%;相比现有 RL 表格解析器 FD-RL、TRivia-3B 分别领先 13.24%、7.92%;其中 Uni-TabRL 单独就在 SFT 基线上带来 2.92% TEDS 提升。

主实验结果。StrucTab(1B)在 OmniDocBench、CC-OCR、OCRBench v2、TableVerse-5K 上的 TEDS/TEDS-S 均取得最优,超越 GPT-5、Gemini 2.5 Pro、HunyuanOCR、MinerU 2.5 等强基线。
结构分解消融。 引入行列计数、合并单元格分析均一致提升性能,二者结合再进一步增益;将子任务整合为序列推理链(而非独立辅助目标)显著优于独立训练,且两阶段课程缺一不可。
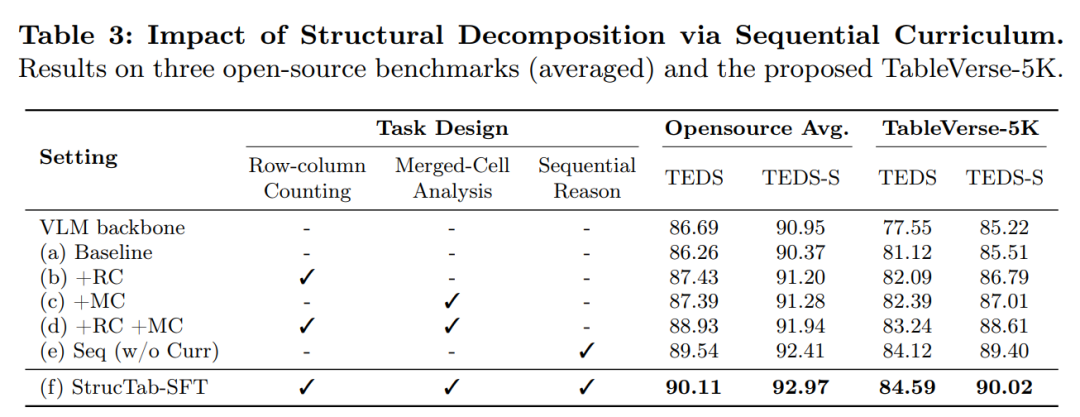
Table 3:结构分解与序列课程的影响。行列计数 + 合并分析 + 序列推理逐步叠加,性能持续提升。
Uni-TabRL 消融。 Anchor-Guided Destylization 优于 VLM 裁判(后者引入噪声),1D Probe 结构奖励优于 TEDS-S,二者组合取得最佳。
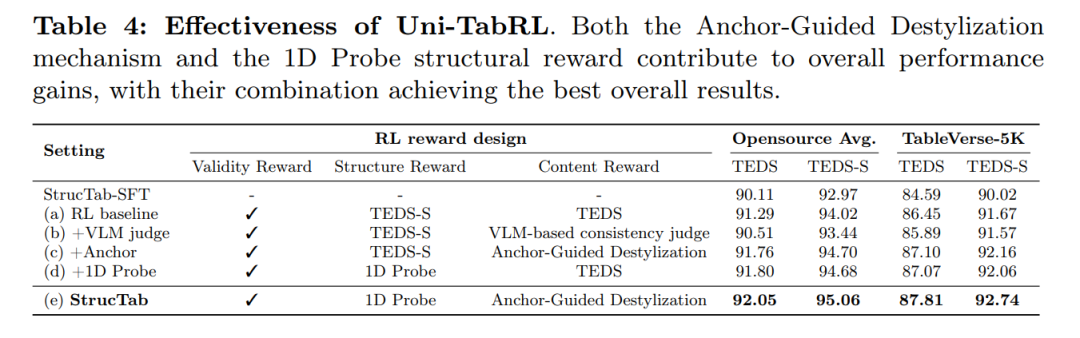
Table 4:Uni-TabRL 奖励设计消融。1D Probe 结构奖励与 Anchor-Guided Destylization 内容奖励的组合达到最优。
降低重复生成。 1D Probe 结构奖励有效缓解自回归解码中的退化重复(缺失 \ 导致的无限循环),将重复率从 backbone 的 1.88% 降至 1.02%。
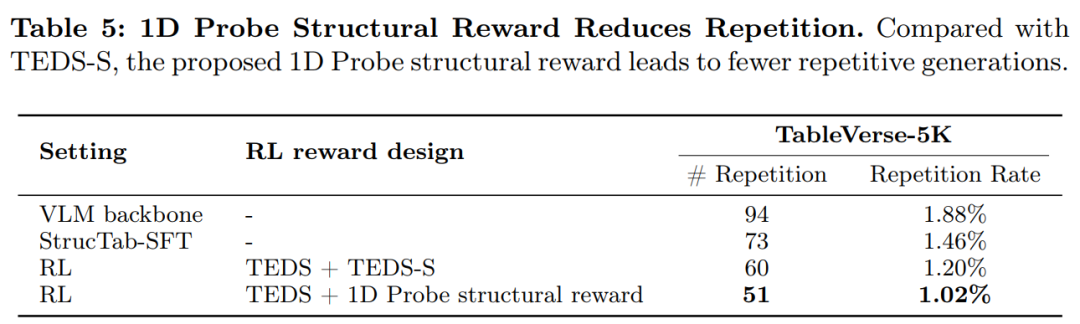
Table 5:1D Probe 结构奖励相比 TEDS-S 带来更少的重复生成,验证其对自回归学习的引导作用。
定性可视化。 相比 HunyuanOCR 的错误结构识别,StrucTab 通过显式的行列计数与合并单元格分析,得到正确的结构解析与高内容准确率。

结果可视化对比:StrucTab 先输出行列计数与合并单元格分析,再生成最终 HTML,结构与内容准确率显著优于直接端到端解析。
价值与展望
StrucTab 的核心洞察是:鲁棒的表格解析需要显式的结构化中间推理,以及稳定、细粒度的优化信号。 通过在建模、优化、评测三个层面的系统性设计——人类式结构分解 + Uni-TabRL 分解奖励 + TableVerse-5K 基准,仅 1B 参数的模型便能全面超越百倍参数的通用大模型,为真实场景下的表格解析提供了新范式。
? 代码与基准已开源: https://github\.com/VirtualLUOUCAS/StrucTab
论文信息
题目:
作者:
单位:
会议:
arXiv:
原文链接: https://www.leiphone.com/category/private/aV9XszepUnYQhCLs.html
