


来源:YoLo深度学习
文章链接:https://mp.weixin.qq.com/s/7s6QVAvRCW3Zy81PqZ0eRQ
恶劣天气检测 模态退化鲁棒
? 本期导读
背景引入:实验室里跑得很好的检测器,一到雾天、暗光、雨雪就掉链子——这不是新鲜事,但今年这条线的打法明显变了。以往多是为每种天气单独设计一套模块或单独训一个模型,推理时还得先判断天气;新一批工作开始追求用一个统一检测器覆盖多场景,并且显式建模“当前这个模态可不可信”。本期两篇正好代表这两种新打法。
-
为什么读:
C2FXNet(ACM MM 2026)要解决的是条件专用设计带来的泛化瓶颈:它用粗粒度场景推理加细粒度语义细化共同驱动一组场景专家,做到无需按场景分别训练。RA-SOD(ECCV 2026)则盯住了一个更隐蔽的问题:真实场景里每个模态的可靠性本身是不稳定的,RGB 在低照度、运动模糊、噪声下退化,热成像则受对比度压缩与传感器伪影困扰,而现有融合方法默认两个模态都可信。 -
核心看点:
① C2FXNet 用 GRU 做多步场景推理(MRR)+ 图像专属语义细化(FSR)+ 场景感知 MoE,在 RTTS 上以 6.7M 参数取得 63.70% mAP;② RA-SOD 提出可靠性条件表征、不确定性引导双流细化与逐像素模态竞争,在 VT1000 上把 Em 提到 0.951;③ 两者都不需要按场景单独训练,是一次性统一建模。 -
适合谁读:
做自动驾驶 / 无人机感知的工程师、关注恶劣天气与多模态鲁棒性的研究者、以及想了解 MoE 与不确定性建模如何落地检测的同学。
论文一 | C2FXNet: Coarse-to-Fine Scene Expert for Unified Object Detection across Adverse Weather
 C2FXNet: Coarse-to-Fine Scene Expert for Unified Object Detection across Adverse Weather
桂林电子科技大学与海南大学团队提出 C2FXNet:用 GRU 在压缩后的多尺度视觉线索与冻结的粗粒度场景原型上做多步推理,再用图像专属语义细化高层特征,最后由场景感知 MoE 动态组合专家。在雾天数据集 RTTS 上,它以 6.7M 参数取得 63.70% mAP,超过 YOLOv13s 的 60.62% 且参数更少。
论文标题C2FXNet: Coarse-to-Fine Scene Expert for Unified Object Detection across Adverse Weather
论文地址https://arxiv.org/abs/2609.25693
代码链接https://github.com/PolarisFTL/C2FXNet
论文机构桂林电子科技大学、海南大学
作者Tianle Fang、Zhenbing Liu、Chong Yin、Bolun Li、Haoxiang Lu
时间2026-09-22
录用情况ACM MM 2026
一、研究背景
恶劣天气下的检测难在两处:严重退化既削弱了视觉质量,又打乱了跨场景的语义特征表示。现有方法多采用条件专用设计——为雾、暗光、雨各做一套,或各训一个模型,这在统一检测器里既难部署又难泛化,推理时还得先知道当前是什么天气。
二、研究方法
作者用分层场景引导实现统一检测:粗粒度负责“这是什么场景”,细粒度负责“这张图有什么局部变化”,两者共同决定专家怎么组合。
① MRR:多步推理路由
-
场景推理:
用 GRU 在压缩后的多尺度视觉线索与冻结的粗粒度场景原型上做循环推理。 -
免场景标签:
推理过程不依赖显式的天气类别标注。
② FSR:精细场景细化
-
局部适配:
用图像专属语义线索调制高层特征,处理同一场景内的局部变化。
③ SMoE:场景感知专家混合
-
动态组合:
在 MRR 与 FSR 的联合引导下,动态加权组合场景专属专家,无需按场景分别训练。
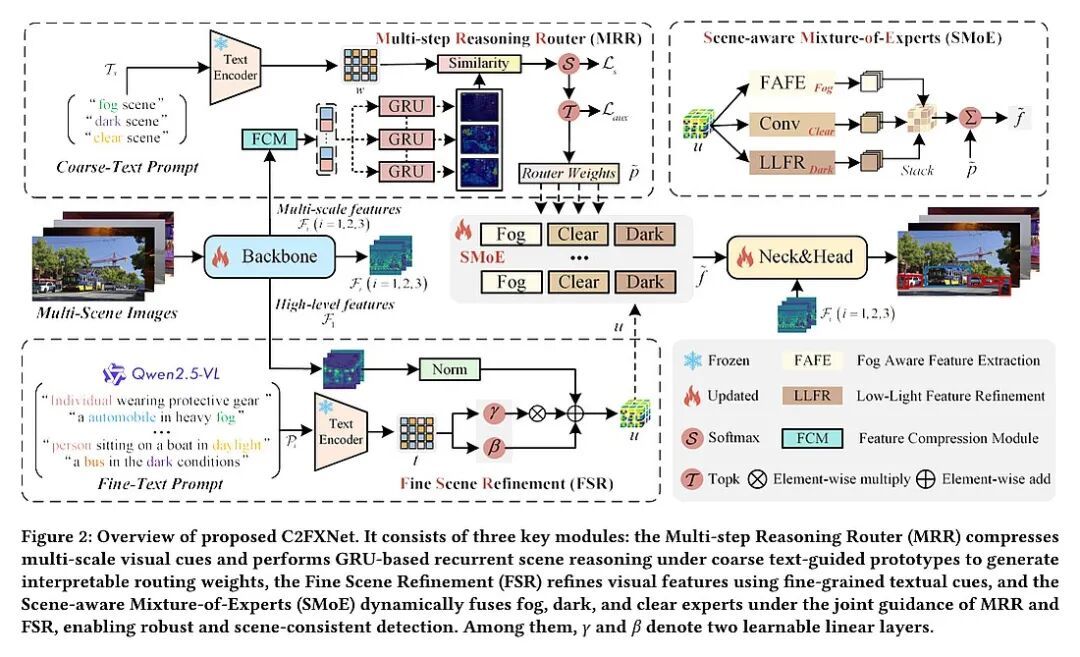 图1:C2FXNet 总体结构:MRR 负责多步场景推理,FSR 做细粒度语义调制,SMoE 动态组合场景专家(来源:arXiv 2609.25693 图 2)
三、实验结果
在 RTTS(雾)、ExDark(暗光)与作者新构建的 AWD 数据集上对比 TogetherNet、IA-YOLO、GDIP-YOLO、YOLOv9s / v10s / v11s / v12s / v13s、EEnvA-Mamba 等方法。RTTS 上 C2FXNet 以 6.7M 参数、22.0G FLOPs 取得 63.70% mAP,高于 YOLOv13s 的 60.62%(8.6M)与 EEnvA-Mamba 的 60.70%(6.9M),是参数效率与精度兼顾最优的一档;论文另在 VOC-Rain、VOC-Snow 上给出量化评估与消融。
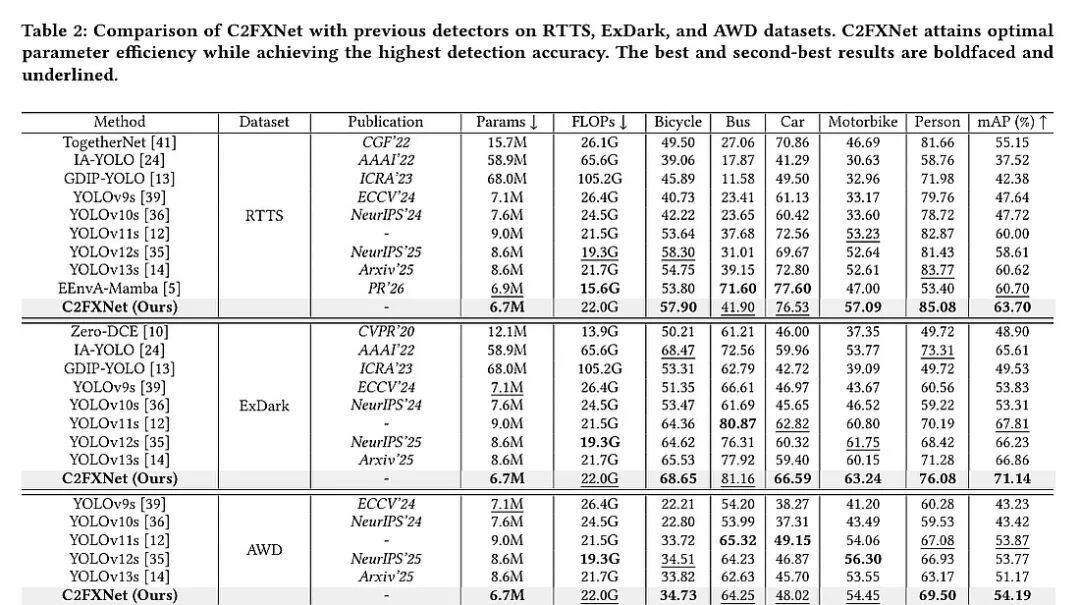 图2:C2FXNet 与已有检测器在 RTTS、ExDark、AWD 三个数据集上的对比(来源:arXiv 2609.25693 表 2)
四、研究贡献
指出条件专用设计是统一恶劣天气检测的主要泛化瓶颈 MRR:用 GRU 在冻结粗粒度场景原型上做多步循环推理,免去天气类别标注 FSR:用图像专属语义线索细化高层特征,处理场景内局部变化 SMoE:在粗-细双层引导下动态组合场景专家,实现无需按场景训练的统一检测 构建并公开 AWD 恶劣天气数据集,并开源代码
五、局限与未来
场景原型的类别(雾 / 暗光 / 清晰)仍是预先定义的离散集合,遇到训练中未覆盖的退化类型可能路由不准;FLOPs 为 22.0G,高于同为轻量路线的 EEnvA-Mamba(15.6G),在端侧部署上不占优;AWD 为新构建数据集,其标注质量与跨数据集可比性有待社区进一步验证。
论文二 | RA-SOD: Reliability-Aware RGB-T Salient Object Detection under Modality Degradation
 RA-SOD: Reliability-Aware RGB-T Salient Object Detection under Modality Degradation
哈尔滨工业大学与悉尼大学团队在 ECCV 2026 上提出 RA-SOD:显式建模每个模态的可靠性,并把它贯穿到特征学习与跨模态融合中。在 VT1000 上把 Em 提升到 0.951、Sm 到 0.932、MAE 降到 0.018,在 VT821 与 VT5000 上同样领先。
论文标题RA-SOD: Reliability-Aware RGB-T Salient Object Detection under Modality Degradation
论文地址https://arxiv.org/abs/2609.12622
代码链接https://github.com/zaoxienian/RA-SOD
论文机构哈尔滨工业大学(机器人技术与系统国家重点实验室)、悉尼大学(计算机学院)
作者Hongbo Gao、Zhengyu Li、Xueru Nie、Dihao Zhu、Lijun Zhao、Yunke Wang、Chang Xu
时间2026-09-11
录用情况ECCV 2026
一、研究背景
RGB-热成像(RGB-T)显著性检测靠可见光的纹理与热成像的热辐射互补,本应在恶劣环境下更稳。但真实场景里每个模态的可靠性天然不稳定:RGB 会遇到低照度、运动模糊与噪声,热成像则常出现对比度压缩与传感器伪影。这些不可靠证据一旦被融合机制照单全收,性能反而比单模态还差。
二、研究方法
作者把“模态可不可信”这一点显式建模出来,并让它参与表征学习、双流细化与最终融合三个环节。
① 可靠性条件表征
-
自适应补偿:
根据可靠性自适应地补偿退化模态的特征,同时保住结构线索。
② 不确定性引导双流细化
-
渐进校正:
用不确定性引导双流逐步校正跨模态表示,抑制不可靠证据。
③ 逐像素模态竞争
-
细粒度选模态:
按空间可靠性逐像素动态挑选该听哪个模态,实现细粒度融合。
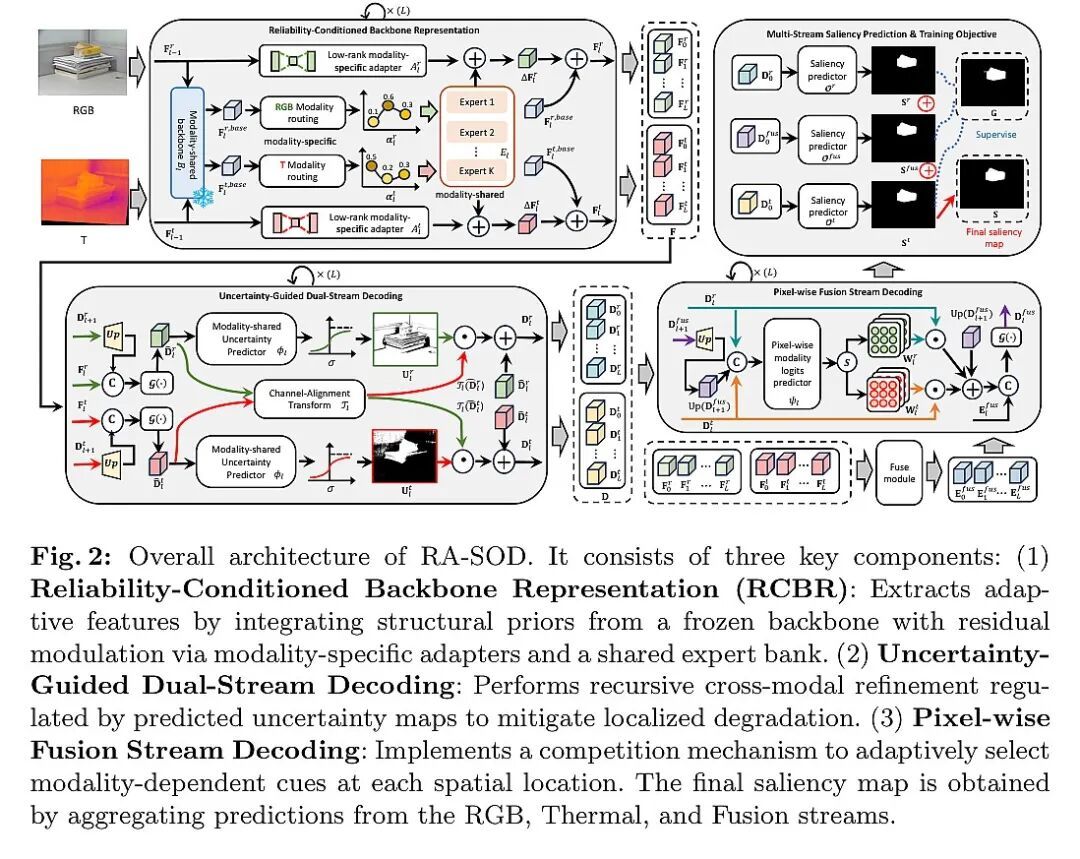 图1:RA-SOD 总体架构:RCBR 可靠性条件化表征、不确定性引导双流细化与逐像素模态竞争(来源:arXiv 2609.12622 图 2)
三、实验结果
在 VT821、VT1000、VT5000、VT-IMAG 四个基准上与 DCMF、CIR-Net、RAFNet、PopNet、HiDAnet、MIA、ECFFNet、OSRNet、LSNet 等方法比较。VT1000 上取得 Sm 0.932、Fβ 0.915、Fwβ 0.913、Em 0.951、MAE 0.018;VT821 上 Sm 0.892、Fβ 0.857、Em 0.925、MAE 0.031;VT5000 上 Sm 0.897、Fβ 0.870、Em 0.937、MAE 0.029。论文另给出合成退化下的平均比较、Transformer 骨干对比与复杂度 / 速度表。
 图2:与近期 SOTA 方法在 VT821、VT1000、VT5000 上的定量对比(来源:arXiv 2609.12622 表 1)
四、研究贡献
指出 RGB-T 感知中模态可靠性天然不稳定这一被忽视的前提 提出可靠性条件表征,自适应补偿退化模态同时保留结构线索 提出不确定性引导的双流细化,渐进校正跨模态表示 提出逐像素模态竞争机制,按空间可靠性做细粒度融合 在四个基准上一致优于现有 SOTA,并开源代码与模型
五、局限与未来
任务设定为显著性目标检测而非带框检测,迁移到通用检测 / 实例分割还需额外适配;可靠性的估计本身依赖训练分布,遇到训练中未见的退化类型(如极端过曝、传感器失效)可能失效;论文的速度与复杂度对比未在统一硬件口径下给出,跨方法可比性需谨慎解读。
