


来源:公众号“PaperAgent”
原文链接:https://mp\.weixin\.qq\.com/s/ECLRTHebLtIfjmZhbaJ4hA?scene=1&click\_id=24
来源:公众号“PaperAgent”
原文链接:https://mp\.weixin\.qq\.com/s/ECLRTHebLtIfjmZhbaJ4hA?scene=1&click\_id=24
想象一下:全球有超过7000种语言,而当你用波兰语、越南语、波斯语或印地语向 AI 系统提问时,它理解你的能力可能远不及英语用户的十分之一。
这不是模型能力的问题,而是结构性的资源分配失衡。
文本嵌入(Text Embedding)是现代 AI 的语义核心——它将文字转化为高维向量,支撑着搜索、问答、RAG 等一系列核心应用。然而,这个看似基础的组件,正在悄然制造三道壁垒:
壁垒一:计算门槛越来越高。 基于 Qwen3 等大语言模型训练嵌入模型,动辄需要数百亿参数规模的算力,绝大多数研究机构难以企及。
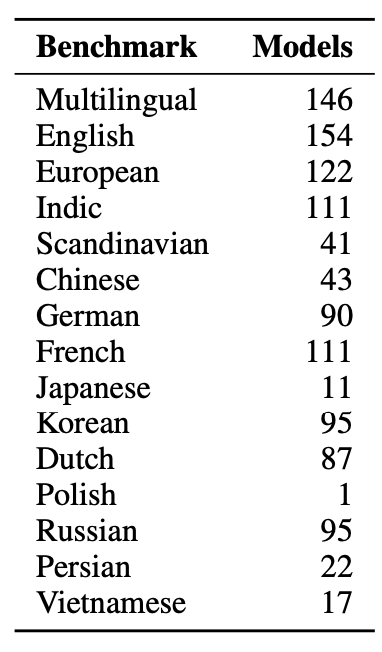
壁垒二:语言覆盖严重失衡。 看下面这张表——截至2026年2月,MTEB 波兰语榜单上有完整测评结果的模型只有1个,而英语和多语言榜单各有近150个。
壁垒三:研究黑箱化。 顶尖模型要么闭源 API,要么只开放权重不开放训练细节,可复现研究举步维艰。
来自蚂蚁集团与上海交通大学的研究者决定正面迎击这三个问题,提出了 ML-Embed 模型,并被 ICML 2026收录。
核心思路:把"套娃"思想延伸到三个维度
ML-Embed的方法论核心是 3D-ML(3-Dimensional Matryoshka Learning)——一个将俄罗斯套娃(Matryoshka)嵌套训练原则扩展到三个不同维度的统一训练框架。
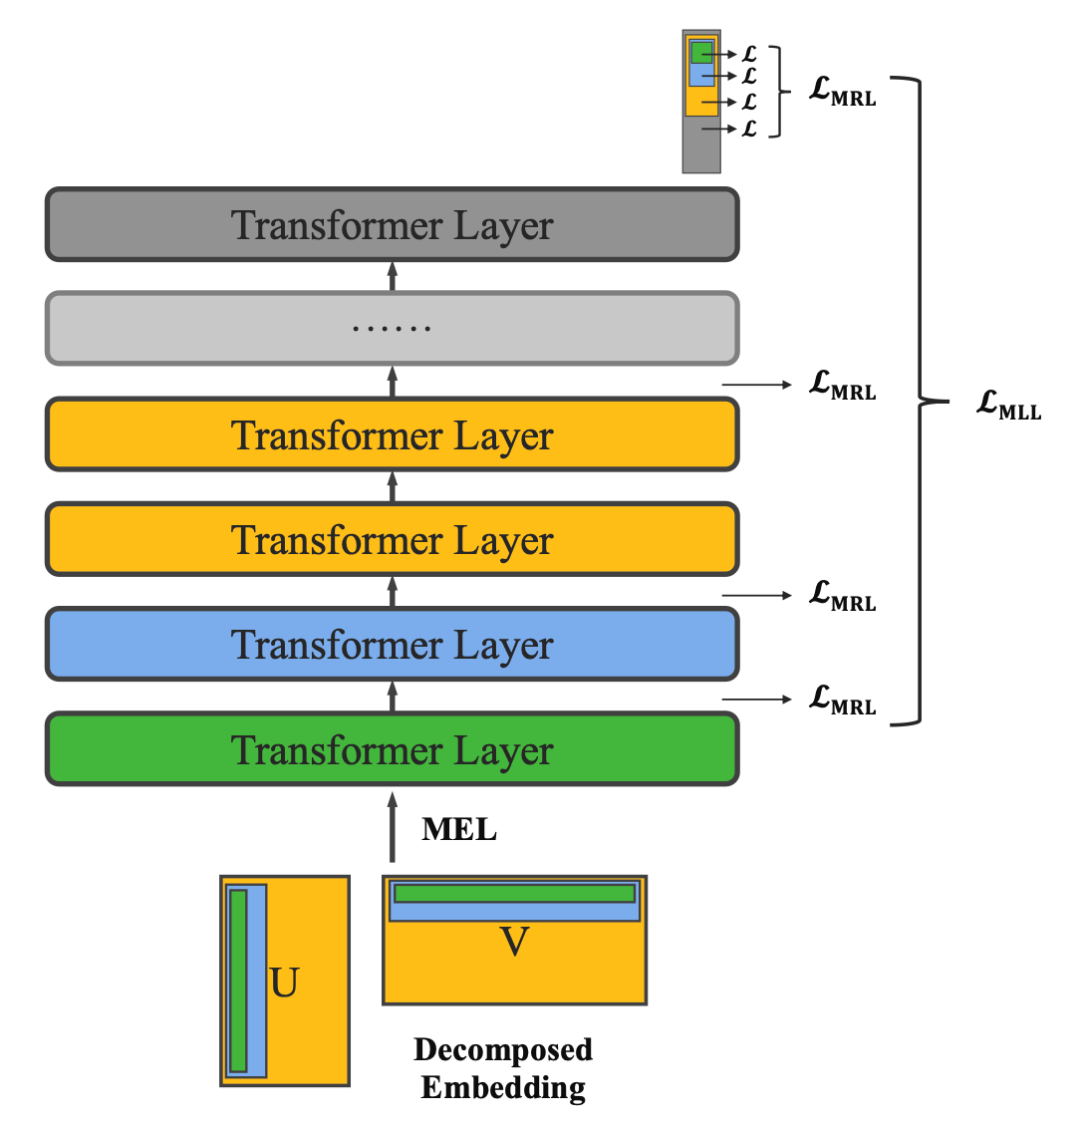
用一句话概括:3D-ML 让模型在训练、推理、存储的全生命周期中都可以按需缩小,而不损失核心能力。
这三个维度分别对应三种技术:
维度一:MEL——让嵌入层瘦身而不失忆
嵌入层(Embedding Layer)是多语言模型的词汇表接口,负责将词元映射为向量。问题是,它的参数量往往惊人——在基于 Qwen3-0.6B 的嵌入模型中,嵌入层参数占总参数的 1/4。
传统做法是完整训练这个庞大矩阵,或者用LoRA只更新增量。MEL(Matryoshka Embedding Learning) 走了第三条路:
对原始嵌入矩阵 进行SVD分解,截断为两个低秩矩阵 和 ,训练时只更新这两个小矩阵。
对原始嵌入矩阵 进行SVD分解,截断为两个低秩矩阵 和 ,训练时只更新这两个小矩阵。
更关键的是,每次前向传播时,MEL会动态采样一个子秩 ,强迫模型把最重要的信息压缩进前几个分解维度——这正是"套娃"的精髓:最核心的信息永远在最内层。
推理时有两种部署选项:
MEL 与 LoRA 的关键区别在于:它不仅减少了可训练参数,也减少了推理时的总参数量,是真正意义上的端到端压缩。
维度二:MLL——让层数变成旋钮而非固定值
MLL(Matryoshka Layer Learning) 的思路更直接:在训练时,同时对多个中间层施加损失,让浅层子模型也能独立胜任嵌入任务。
推理时,只需修改配置文件里的 num_hidden_layers 参数,即可得到不同深度的模型——不需要重新训练,不需要复杂剪枝,一个模型,N种深度。
对数间隔的层集合(如 {1, 2, 4, 8, 16, 32})确保了从浅到深的覆盖,每一层输出都经过最终层归一化处理,保持表征的一致性。
维度三:MRL——让向量维度按需截断
MRL(Matryoshka Representation Learning) 来自2022年 NeurIPS 的同名工作,核心思想是:训练时同时优化不同长度的向量前缀,让截断后的短向量也有效。
在3D-ML中,MRL并非孤立模块,而是与 MLL 深度集成:对每一个MLL层的输出,同时施加多个 MRL 维度的对比损失。
统一损失函数
三者的联合优化目标如下:
其中 是第 层在维度 下的表征函数。
数据:从英中中心到真正的全球覆盖
方法创新之外,ML-Embed 的另一大贡献是数据集本身。
研究者从121个公开数据源汇聚了 5000万训练样本,覆盖 282种自然语言(ISO-639-3编码)和 40余种编程语言。语言分布如下图所示,从英语、中文到西班牙语、阿拉伯语,再到低资源语言的长尾:
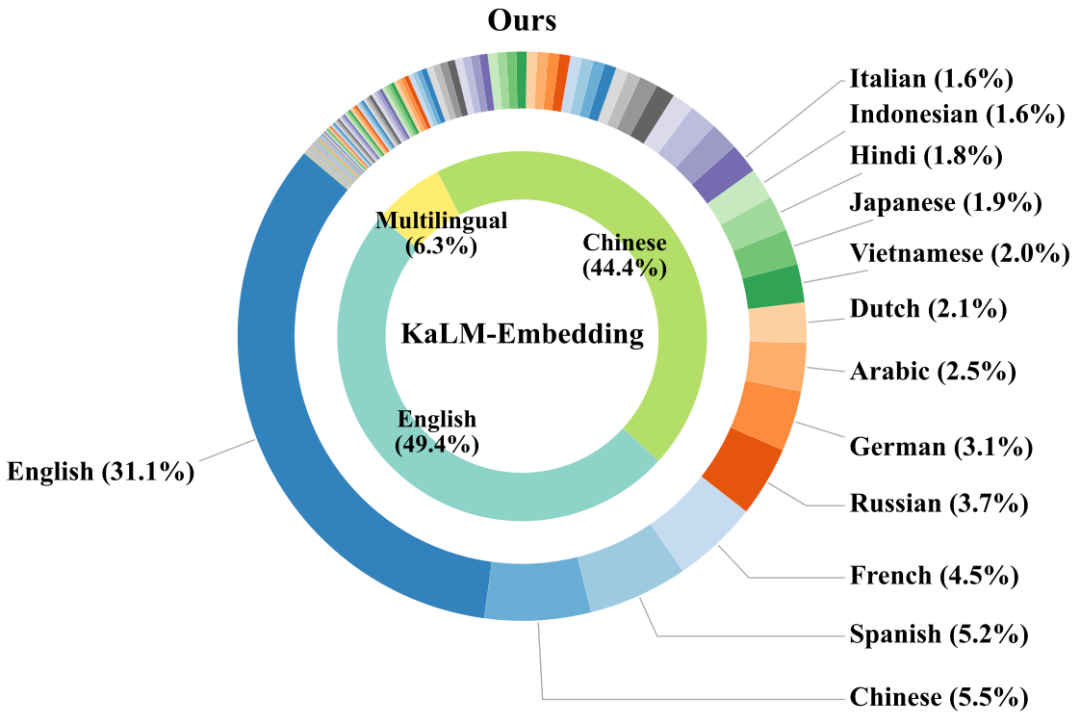
对比之下,目前最具代表性的开源数据集 KaLM-Embedding 的数据仅用英语/中文/多语言三个粗粒度标签标注,且绝大多数数据集中在英文(49.4%)和中文(44.4%)。ML-Embed 的数据分布则真正反映了世界语言的多样性。
训练采用 两阶段策略:
值得注意的是,ML-Embed 的总训练数据量仅为同类SOTA模型的约1/5:
实验结果:9项MTEB榜单SOTA,低资源语言大幅领先
在17个MTEB基准、共430个任务上的全面评测中,ML-Embed-8B 在其中9项刷新SOTA记录:
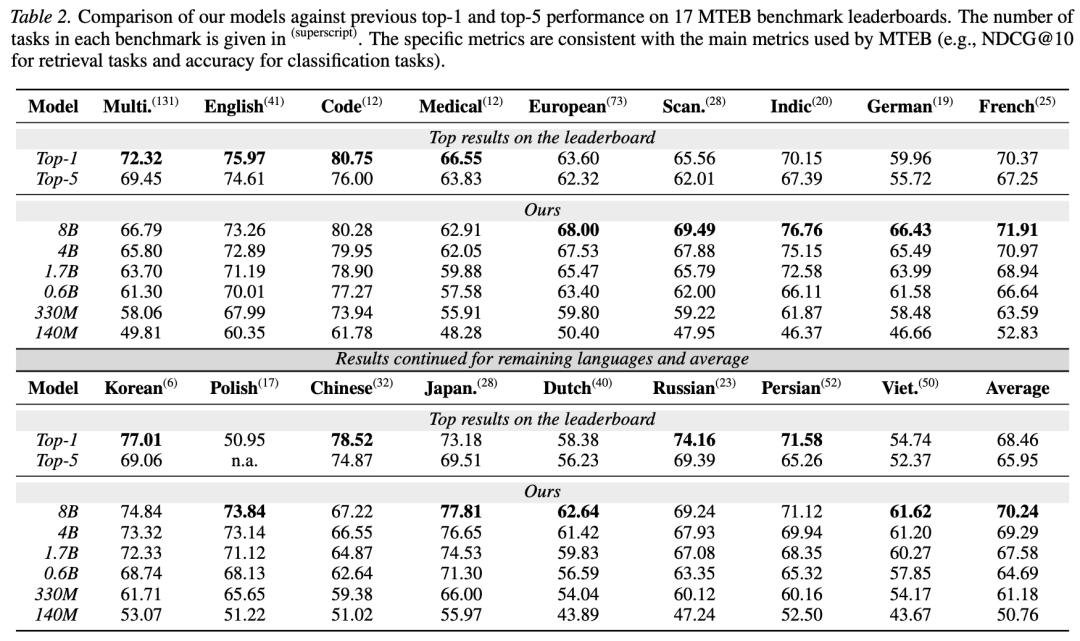
低资源语言上的进展尤为显著:
在英语和多语言综合榜单上,各规模模型也达到 Top-5 水平,且从 140M 到 8B 呈现出清晰稳定的规模扩展趋势。
消融实验:每个组件都在做什么贡献?
MLL + MEL 的协同效应
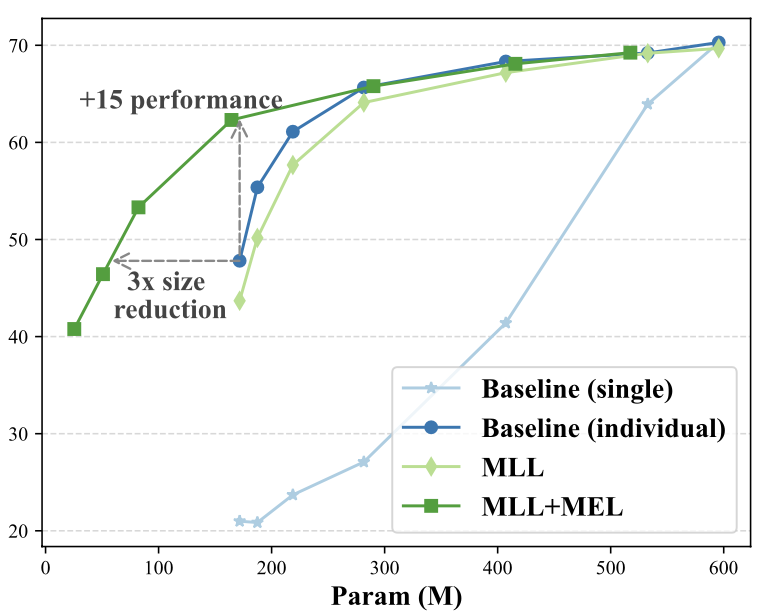
这张图揭示了一个非常有趣的现象:
具体数字:4层的 MLL+MEL 模型参数量约170M,与1层基线模型相当——但性能高出15分;在相同性能水平下,体积缩小3倍。
MEL 的鲁棒性:SVD 压缩的边界在哪里?
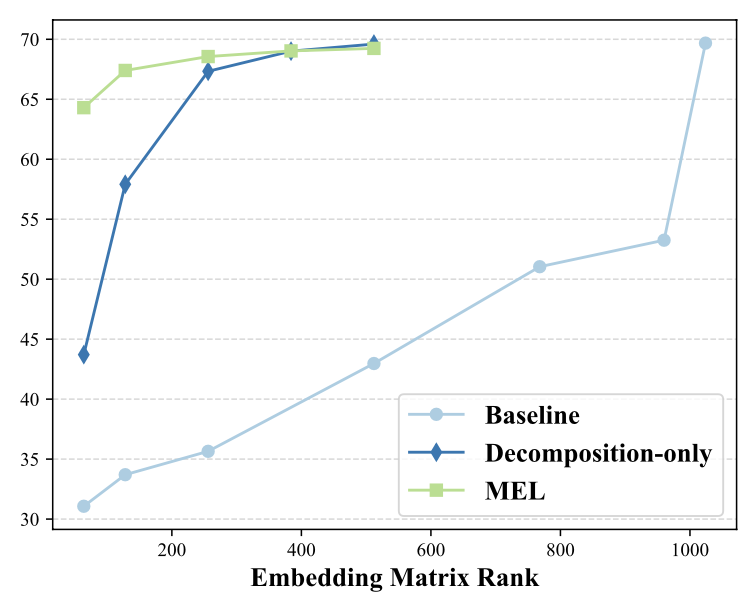
这个实验回答了一个关键问题:能否在推理时直接对嵌入矩阵做 SVD 分解来节省显存?
结论是鲜明的:
MEL 的套娃训练目标强迫模型将关键信息集中在低秩空间的前几个维度,这正是其鲁棒性的来源。
数据对比:更广不等于更弱
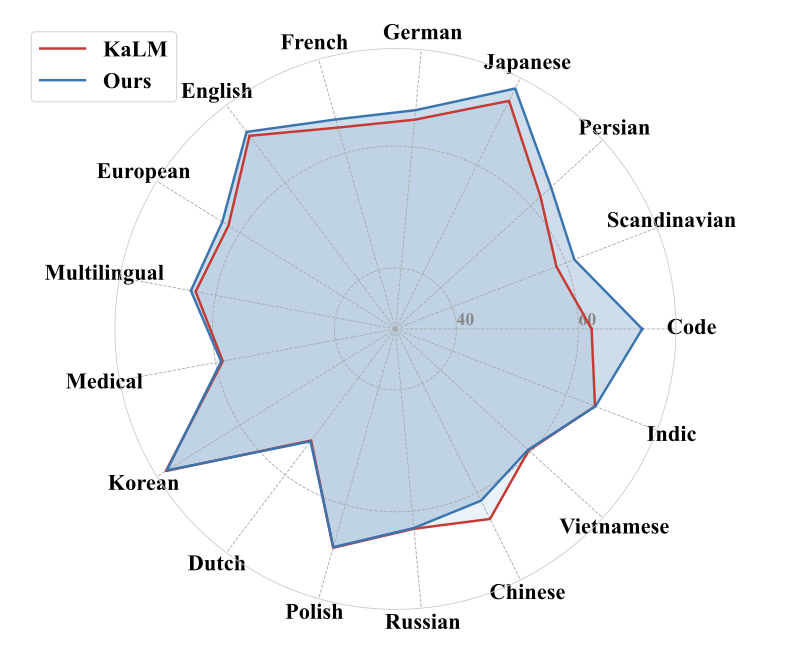
在相同底座、相同训练流程下,分别用 ML-Embed 数据和 KaLM-Embedding 数据训练 0.6B 模型:
这说明:语言多样性的提升,并不以牺牲主流语言性能为代价。
框架的泛化性:不只适用于 Qwen3
为验证 3D-ML 的普适性,研究者在 EuroBERT-210M 上额外进行了实验,对比三种设置:
3D-ML训练后剪枝的模型,相比直接结构剪枝,平均分高出12.67分,性能损失极小(相对于 210M 基线仅损失3.61分),验证了框架的广泛适用性。
开源与可复现性:打破透明度壁垒的承诺
与许多顶尖嵌入模型截然不同,ML-Embed做到了真正意义上的全量开源:
[
](https://vip.yanxishe.com/?from=leiphonearticle)
原文链接: https://www.leiphone.com/category/ai/A6qX7NslUDxioksz.html
