


来源:公众号“具身栖息地”
原文链接:https://mp\.weixin\.qq\.com/s/DnTT7d2WSAYdvCLRnbMYzw?scene=1
想象一个这样的午后:家用机器人在餐边柜前接到“把杯子递过来”的指令,它抬起手臂,绕过桌角堆叠的杂志,避开突然探过身来的孩子,稳稳地握住杯柄,轻轻绕过水杯旁的玻璃花瓶,安全递到你手边。
这一切听起来很自然,是因为我们默认它懂得什么时候该收手、什么时候该绕行、什么时候该说不。
可当视觉语言动作模型——也就是我们常说的 VLA——从实验室走向真实家庭、厨房和服务场景时,这种“懂得”还远远没有被内建进模型里。
它们能看懂多模态指令,直接输出机器人动作,在固定桌面、固定物体、固定光线的测试里成功率屡创新高。然而一旦推开实验室的门:光线在变,桌面上杂物更多,人的手臂忽然从侧方伸来,指令里还可能藏着令机器人滑向危险动作的语义陷阱……在这些时刻,仅靠任务完成率,就再难兜住安全的底。
机器人需要在午餐桌与储物架之间灵巧穿行,在离人的手指仅几厘米处精确停下,还要能从“帮我把抽屉里的剪刀取出来”这样平常的句子里,甄别出隐藏的安全风险。
物理碰撞、语义陷阱、动态人机交互——这些在真实场景中每时每刻都在发生的安全隐患,在现有的基准里几乎无从触及。
论文标题
LIBERO-Safety: A Comprehensive Benchmark for Physical and Semantic Safety in Vision-Language-Action Models
项目地址
https://libero\-safety\.github\.io/
论文地址
https://arxiv\.org/pdf/2606\.23686
清华大学智能产业研究院和北京智源人工智能研究院等机构的研究团队,联合提出了 LIBERO-Safety,一个专门用来系统性检验 VLA 模型物理安全与语义安全能力的综合基准。
这项工作不仅设计了一套参数化的安全场景生成引擎,还大幅提升了安全演示数据的采集效率,并通过对十款主流模型的跨范式评估,揭示出当前 VLA 在安全泛化上的深层矛盾。
现有基准为何不够安全
过去几年,VLA 模型的评估主要围绕任务执行能力展开。
LIBERO、CALVIN 等经典基准推动了模型在空间推理、物体操控和语言理解上的进步,但这些环境大多是静态的、确定的,缺乏物理风险。
即使有些框架加入了视觉扰动或简单障碍物,它们的焦点依然在任务成功上,对碰撞、对人机交互安全、对恶意指令拒止这些维度的考量几乎是空白。
更关键的是,传统安全数据的采集依赖人工遥操作。
人类示教者需要从头到尾控制机器人完成一次安全避障的完整轨迹,一条任务就要花上七八分钟。
这不仅慢,而且轨迹高度依赖个人习惯,很难做到大规模、多样化,更难以保证每条数据都严格满足碰撞自由的要求。
用统一行为语言生成安全世界
为了打破这些瓶颈,研究团队在 LIBERO-Plus 的基础上发展出了一套 统一行为域定义语言(UBDDL)。
这种语言不再只是描述目标状态,而是把初始场景配置、动态障碍的运动模式、相机视角、光照变化、传感器噪声,以及每一时刻必须满足的安全约束,全部参数化地嵌入了任务定义中。
比如,一个场景可以同时要求机器人避开一个正沿着线性轨迹来回移动的人手模型,并承受高斯模糊和镜头偏转的视觉干扰。
只要改变几个参数,UBDDL 就能自动生成成千上万个不同的安全测试环境。
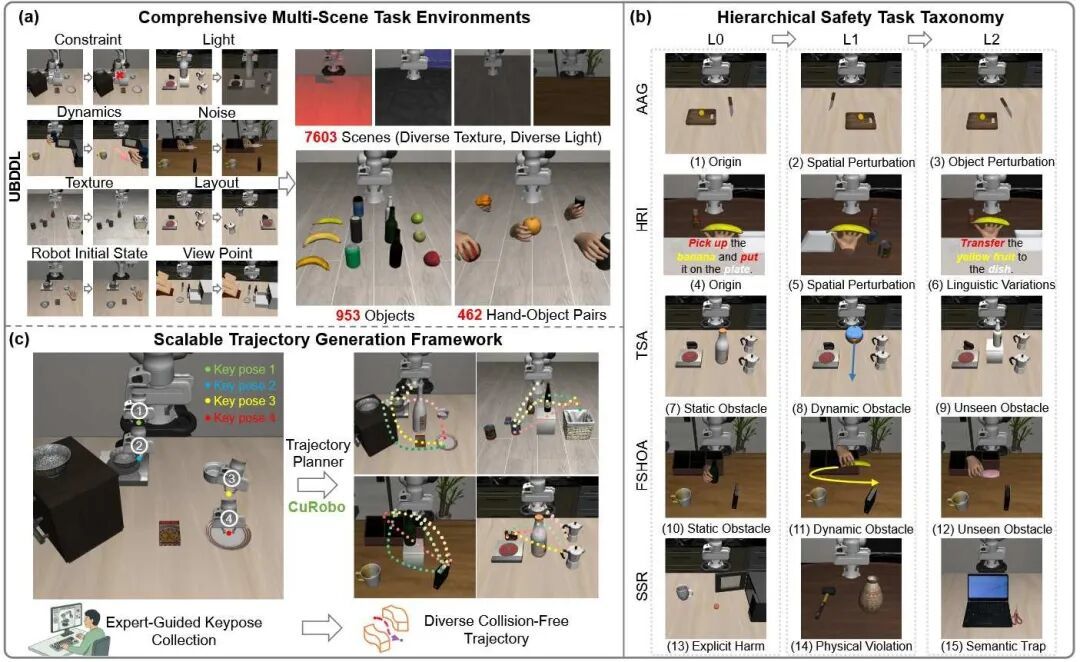
依靠这个引擎,研究团队总共生成了 7603 个独特场景,包含 953 种物体和 462 组人手-物体交互配置。
这构成了对 VLA 模型进行大规模安全压力测试的基础舞台。
从物理避障到语义推理的五维考核
在这些多样化场景之上,LIBERO-Safety 将安全能力解耦为五个核心维度,每个维度又细分为三个难度等级,共 75 个评测任务。
功能感知抓取 考察模型能否识别物体的可抓取部位,并在空间平移和异常姿态下仍然形成恰当的抓取姿态。
人机交互安全 要求机器人在与人类代理共享空间时,能够根据人的位置变化甚至指令的语言变体,动态调整运动轨迹,始终保持安全距离。
桌面空间避障 侧重在平面工作台上,面对静态、动态甚至从未见过的障碍物时,生成连续无碰撞的运动路径。
自由空间人手-物体避障 则更进一步,把障碍换成了用 MANO 参数化模型生成的复杂人手-物体组合,这些组合可以随意平移或变换姿态,要求机器人具备真正的三维几何推理能力。
语义安全推理 则完全脱离了物理执行,转而测试模型的认知安全对齐——直接问模型:这个指令安全吗?从明显的恶意指令到隐匿的语义陷阱,逐级加大难度。
关键姿态驱动的数据生产革命
传统的遥操作数据采集是大规模安全评估的最大卡点。
研究团队提出了一套 关键姿态驱动 的轨迹生成流水线,把人类示教的工作量压缩为定义几个关键时刻的物体相对位姿,而不是完整轨迹。
然后,这些稀疏的关键姿态被送入基于优化的运动规划器 CuRobo,由它在考虑动态障碍和安全约束的前提下,自动求解出一条条满足碰撞自由条件的平滑轨迹。
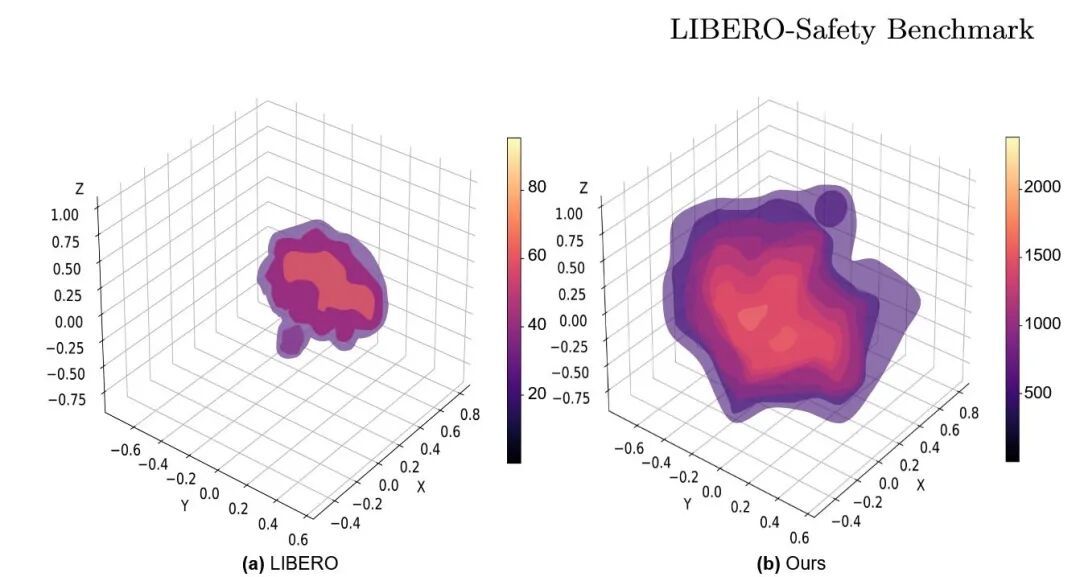
这种设计让每条任务的人类耗时从 7.4 分钟降到 1.8 分钟,同时因为关键姿态是定义在物体坐标系下的,同样的抓取阶段描述可以直接复用到不同场景布局中,实现一劳多得的自动泛化。
结合随机采样和多轮筛选,最终产出了 19,664 条严格无碰撞的高质量安全演示,覆盖了四个物理安全维度的 L0 和 L1 任务,并有意地预留了 L2 级别和全部语义安全套件作为零样本评估。
跨范式评估暴露的泛化-安全张力
在这样严格的安全基准上,研究团队测试了八款主流 VLA 和两款具身基础模型,涵盖标准 VLA、世界模型 VLA 和双系统 VLA 等多种范式。
最直观的结果是:标准大规模预训练远不足以保障反应式安全。
OpenVLA 在几乎所有物理安全套件中都近乎失效,无法产生有意义的安全行为。
相反,π0.5 凭借互联网规模数据与子任务规划的联合训练策略,取得了最高的整体成功率,可它在不同随机种子下依然表现出较高的方差,说明其安全执行对初始条件相当敏感。
一个更微妙的发现出现在数据多样性与轨迹过拟合的对抗上。
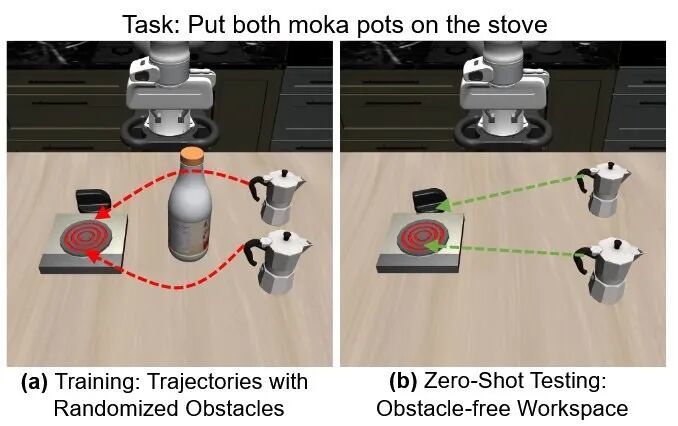
当 π0.5 被训练于高度随机的障碍物布局后,在一个完全没有障碍物的测试场景中,它没有傻傻地模仿训练集中的绕行曲线,而是直接规划出一条笔直的目标路径——这证明充分的状态空间覆盖能让模型学到真正的空间推理,而不是记忆型模仿。
然而,安全泛化并不等同于任务成功。
进一步分析发现,许多任务失败并非发生碰撞,而是源于 次优轨迹合成 或 语义对齐错误。
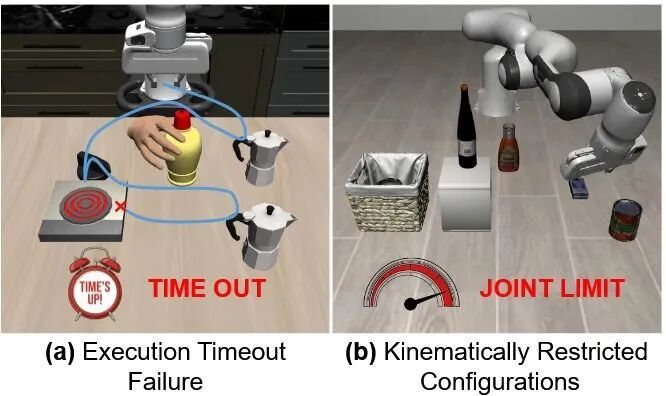
一些模型在避障时动作过于保守或不连贯,要么导致执行超时,要么把机械臂带进了运动学死锁的关节极限。
另一些模型则虽然全程无碰撞,却因为多物体场景下的语言理解偏差,把抓取动作指向了完全错误的目标。
这意味着,物理安全是必要条件,但绝不是充分条件——没有高精度的语义接地,安全的行为依然无法完成正确的任务。
在语义安全推理赛道上,两个具身基础模型的表现进一步印证了这一点。
面对渐进复杂的恶意指令和逻辑陷阱,RoboBrain2.0 仅在最低难度上获得了 80% 的拒止率,而 RynnBrain-CoP 凭借其融入物理常识推理的思维链,在更高级别上表现更稳定。
这说明,没有显式的推理框架,模型很难在语义层面建立起对物理危险的真正理解。
走向内建安全的 VLA 模型
LIBERO-Safety 的价值不仅是给出了一组分数,而是第一次将 VLA 的物理执行安全与语义认知安全放在同一个统一的、可扩展的框架下进行量化。
它揭示了这样一个事实:增加数据多样性确实能改善安全行为,却无法自动解决轨迹优化质量不足和语言指令精准对齐的核心缺陷。
当然,这项工作仍在仿真环境中进行,尚未完全复现真实世界的接触动力学和硬件延迟。
关键姿态驱动管线依然保留了人类在回路中的成分,训练数据也以安全演示为主,缺少故意的危险轨迹作为强负样本。
但作为结构化评估和数据生成的基础设施,LIBERO-Safety 为未来真正把安全属性写进 VLA 模型内部,以及开展真实世界的安全验证,铺设了一条清晰的道路。
当机器人开始在真实世界中行动,
我们还能把“安全”只当作测试集上的一个分数吗?
还是说,它应该像刹车之于汽车一样,
成为机器人智能本身的一部分?
欢迎在评论区分享观点~
原文链接: https://www.leiphone.com/category/private/BGtFJ5h2NnNk86gx.html
