


来源:机器学习与推荐算法
原文链接:https://mp.weixin.qq.com/s/PcF3gz-2NQ7m8DNeHxVbvQ
TLDR:来自悉尼科技大学(UTS)等团队的联邦推荐综述被 IJCAI 2026 接收。这是首个系统讨论"个性化 + 联邦 + 基础模型"三者交汇的综述,重新定义了"联邦推荐隐私":传统观点认为只要把数据锁在本地就够了,但作者们指出:梯度上传本身就在泄露用户最稳定的"人格"。论文提出个性化联邦基础模型(PFFM)框架,把隐私边界从"数据在哪里"推到"语义空间的几何上"。
论文:https://arxiv.org/abs/2506.11563方向:联邦学习 · 基础模型 · 推荐系统 · 隐私保护
你以为联邦学习把数据锁在本地就万事大吉?错。
过去两年,全球数据合规压力前所未有:
在这种压力下,联邦学习(FL)几乎成了推荐系统行业的"标配解药"——客户端本地训练,只把模型更新发回服务器,从此数据再也不出门。
但来自 UTS、吉林大学、北京交通大学与香港理工大学联合团队的最新综述指出:这只是隐私的一层假象。
"FRS 解决了数据本地化,但模型更新本身仍在泄露用户最深层的稳定特征。"
联邦推荐系统(FRS)的设定听起来很完美:每个用户在本地用自己的私密数据训练一个本地模型,服务器只负责把所有人的模型更新(比如梯度)平均一下,再分发给大家。
但梯度本身就是一种"人格画像"。
研究早已证明,攻击者只要拿到模型更新,就有可能反推出敏感属性。而对推荐系统而言,泄露的远不只是"今天看了什么",而是用户长期稳定的偏好结构,也就是这篇论文的关键概念:"人格(personality)"。
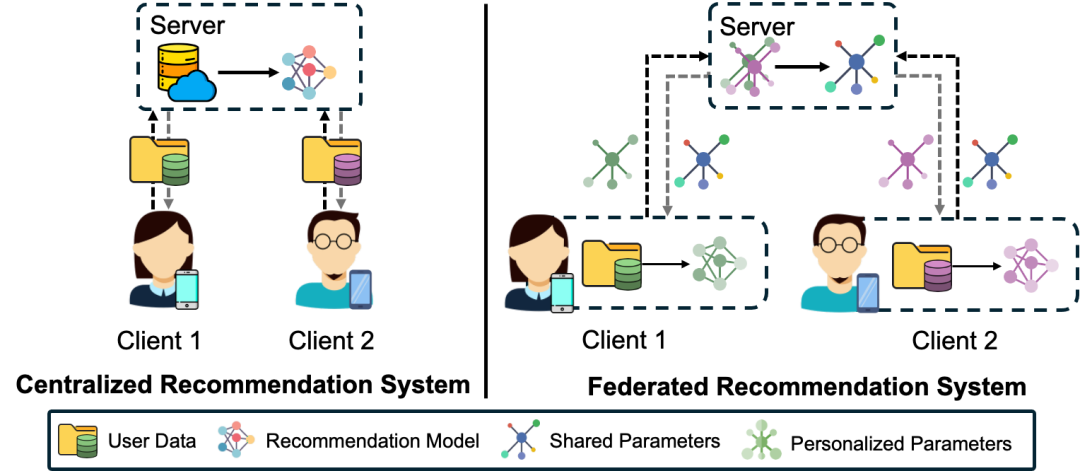
▲ 图 1:左侧的中心化推荐把所有用户数据上传到服务器,右侧的联邦推荐把模型留在客户端。但右侧仍然不安全——每次上传的梯度都在悄悄说话。
更糟的是,FRS 自身没有任何机制专门针对"人格泄露"做防御。它的隐私观念还停留在"把数据放在哪里",而没有意识到"模型表征长成什么样"才是真正的战场。
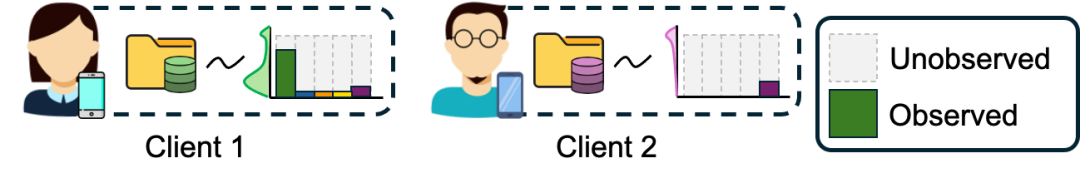
▲ 图 2:联邦推荐系统的核心数据挑战。每个客户端只能观察到很小一部分物品(数据稀疏),叠加用户行为分布的非独立同分布(non-IID),让局部个性化与全局模型聚合都变得棘手。
为什么仅仅"联邦"还不够?因为现代推荐系统还需要深层语义理解,这恰恰是基础模型(FM)的强项。
把 FM 接入联邦架构,就得到联邦基础模型(FFM)。FFM 用预训练语义先验来弥补客户端数据稀疏的问题。
但 FFM 仍然不够,原因很简单:
一个全局 FFM 怎么可能装得下数十亿用户的差异化人格?
于是有了个性化联邦基础模型(PFFM)——它必须主动学会保护人格(learn to preserve personality),把通用的世界知识与个体的隐私敏感特征架构性地解耦。
这是论文最具创新的概念部分。作者把用户的潜在表征空间按照几何结构拆成两层:
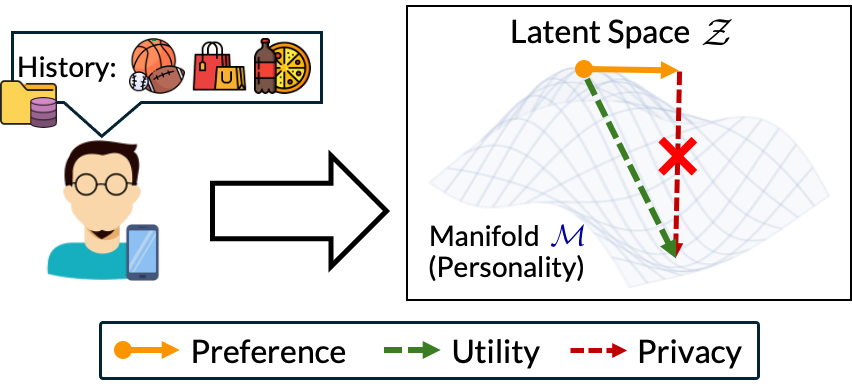
▲ 图 3(核心概念图):用户的人格构成稳定的"基流形",而每次的偏好向量(橙色箭头)都是从出发的扰动。
这一分解的关键:推荐任务只需要的方向(用来给候选物品打分),完全不需要本身的坐标!
于是作者把张成的子空间记作,称之为"敏感子空间(sensitive subspace)"。
新隐私目标:模型可以学好的方向(保证推荐效果),但梯度更新必须与正交(不让攻击者重构出)。
这就把传统联邦的"架构性隐私"(架构性把数据藏起来),重新定义为"几何性隐私"(geometric privacy)——一种可被数学验证的硬约束。
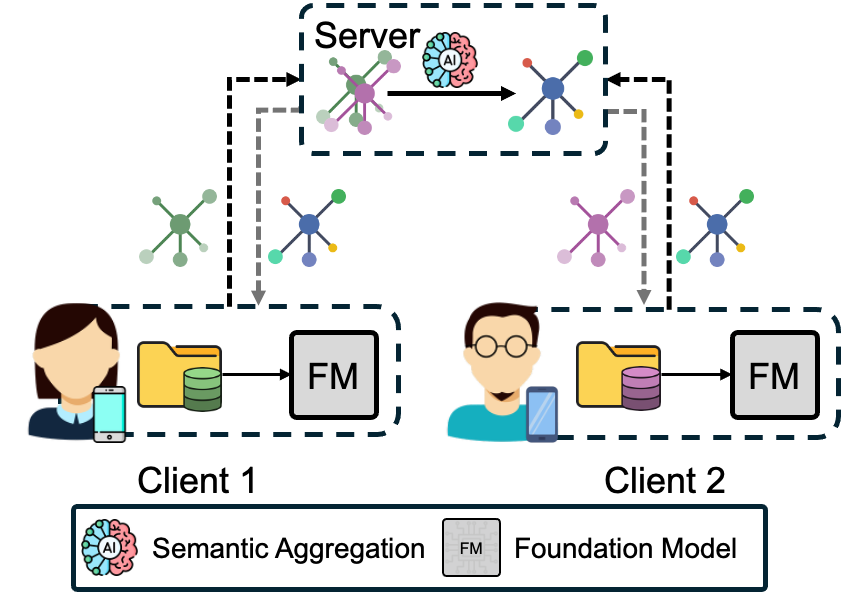
▲ 图 4:标准 FFM 把所有客户端的更新平均聚合,没有结构性区分。
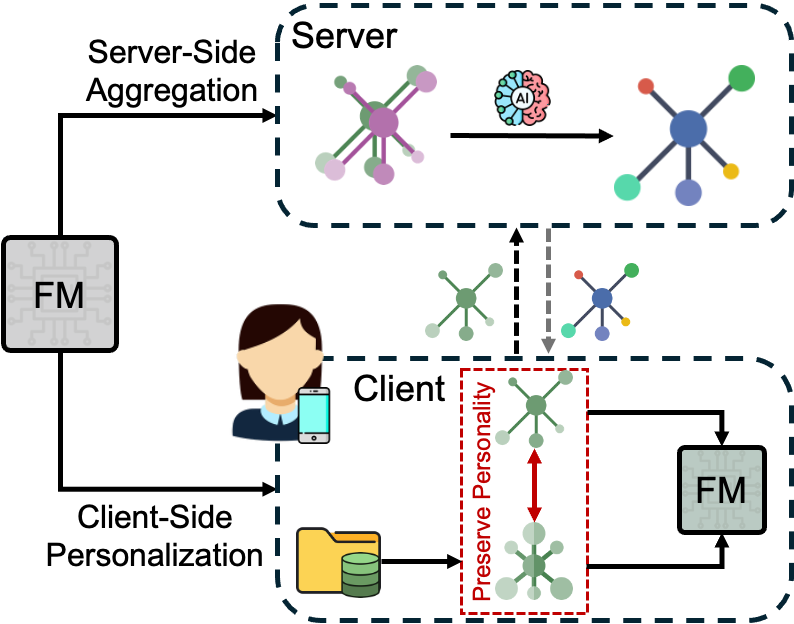
▲ 图 5:PFFM 把 FM 当做共享语义底座,并通过约束优化和语义感知聚合,把全局知识与个体人格主动解耦。
PFFM 的客户端目标函数不再是单纯最小化推荐误差,而是带一个正交约束的优化问题:
其中是推荐损失,约束式要求个性化参数与共享参数在敏感子空间上保持正交。
通俗讲:只要你的个性化更新与"人格方向"正交,无论攻击者怎么截获,都重构不出你的人格。
传统联邦学习的服务器只负责简单平均(比如 FedAvg)。PFFM 的服务器用预训练 FM 当语义判别器,主动审计每个客户端发来的梯度:
凡是与"敏感语义方向"高度相关的梯度分量,统统投影掉再聚合。
这相当于在算术平均之前先加了一道"语义筛",确保聚合后的全局模型只吸收可泛化的偏好模式,而不会无意中把某个用户的人格指纹"传染"给其他人。
论文把现有方法按照"与的隔离强度"系统归类为三类:
这个分类的妙处:它直接对应论文给出的几何隐私边界条件——前两类天然满足,第三类则需要服务器端的语义感知聚合才能弥补。
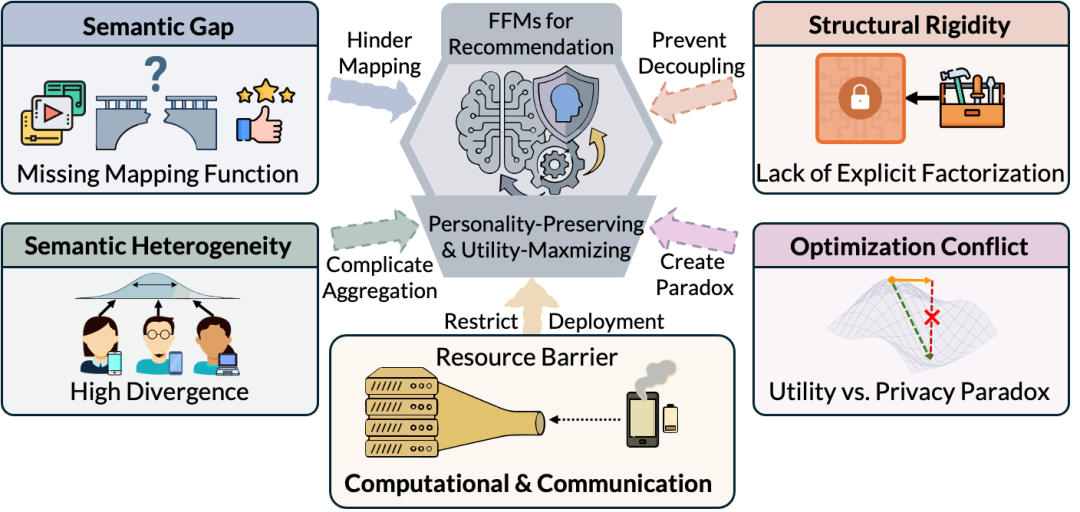
▲ 图 6:实现"个性化联邦基础模型"必须直面的 5 大根本难题。
论文识别了5 大尚未解决的根本难题:
第 4 条值得单独拎出来:
效用要求:梯度必须与人格强相关(这样推荐才准确)。
隐私要求:梯度必须与敏感子空间正交(这样才不泄露人格)。
但!这两条数学上根本不可能同时满足。
这是 PFFM 必须直面的结构性矛盾——传统的随机梯度下降在这个约束系统里,永远会在效用与隐私之间被迫取舍。
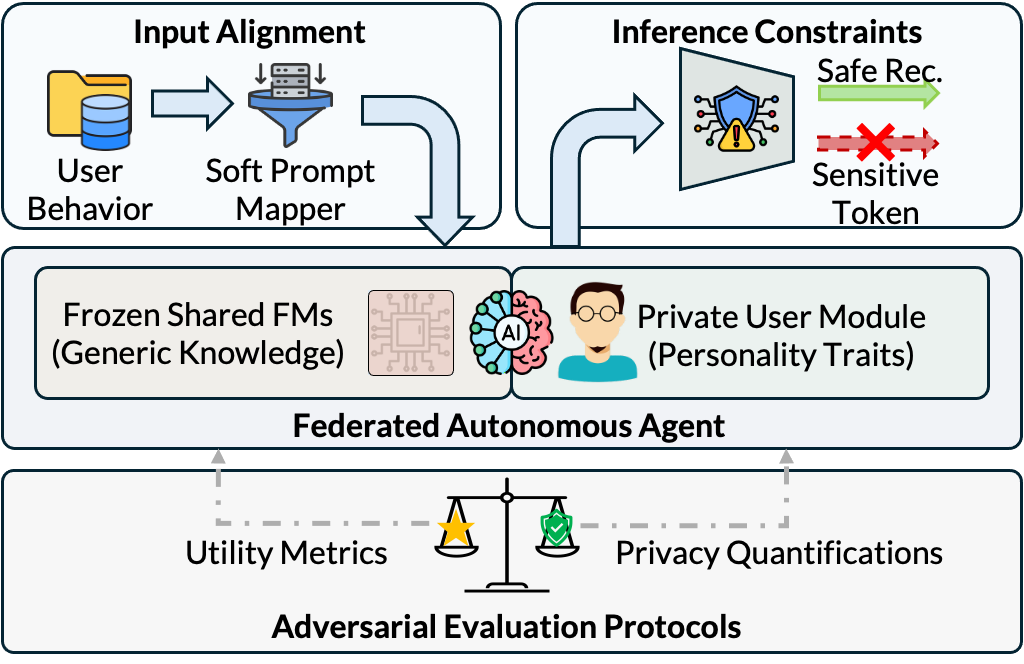
▲ 图 7:5 条具体研究方向,与图 6 的 5 大开放问题一一对应。
针对上述 5 个问题,论文给出 5 条具体研究方向:
第 4 条尤其值得关注:作者建议绕开"训练时"这个无解的优化矛盾,把防御直接放到解码阶段——用 logit 重加权、受约束核采样、解码端差分隐私等手段,让输出"可用但对人格统计不变"。这一思路与基于大语言模型的推荐系统的近期工作天然契合。
这篇综述的 4 个核心贡献:
值得思考的是:在 LLM 浪潮席卷推荐系统的当下,用户最珍贵的不再是单条点击记录,而是从海量交互中聚合出的、稳定的"人格"。当所有平台都在用基础模型更深入地"理解你"时,谁来保证这种理解不会被反向挖掘?
这篇综述给了一个新答案:把隐私边界画在语义几何上,而不是停留在数据物理位置上。
如果说传统联邦学习是"把保险柜钥匙交给你自己保管",那么 PFFM 是在保险柜里又多套了一层:"就算钥匙被偷,里面装的东西也读不出来。"
6 位作者,来自 3 个机构。
李志伟— 悉尼科技大学澳大利亚人工智能研究院博士生,本文第一作者。
龙国栋— 悉尼科技大学澳大利亚人工智能研究院副教授。
张春旭— 吉林大学人工智能高等研究院博士后研究员。
张洪磊— 北京交通大学计算机科学与技术学院讲师。
张成奇— 香港理工大学数据科学与人工智能系讲席教授、香港理工大学深圳研究院院长,IEEE 会士、澳大利亚计算机协会会士。
江静— 悉尼科技大学澳大利亚人工智能研究院副教授。
