


来源:具身智能论文日记
原文链接:https://mp\.weixin\.qq\.com/s/7t3K\-OGfBccG1hqG4evJBw
具身导航系统通常让三维感知模块先把场景改写成坐标、场景图或自然语言,再交给视觉语言模型决策。SoftNav 质疑的正是这一步:连续三维表征被压成文字后,几何、语义与空间关系是否已经损失?它用一个轻量投影器,把每个对象和探索前沿的三维实体表示直接变成 VLM 可读取的软 token。方法只训练约 1700 万参数和 1187 条样本,却在多个导航基准、跨任务迁移和真实四足机器人上给出了较完整的证据链。
来源:具身智能论文日记
原文链接:https://mp\.weixin\.qq\.com/s/7t3K\-OGfBccG1hqG4evJBw
具身导航系统通常让三维感知模块先把场景改写成坐标、场景图或自然语言,再交给视觉语言模型决策。SoftNav 质疑的正是这一步:连续三维表征被压成文字后,几何、语义与空间关系是否已经损失?它用一个轻量投影器,把每个对象和探索前沿的三维实体表示直接变成 VLM 可读取的软 token。方法只训练约 1700 万参数和 1187 条样本,却在多个导航基准、跨任务迁移和真实四足机器人上给出了较完整的证据链。
论文信息
https://arxiv\.org/abs/2607\.14586
导读
目标导航要求智能体在陌生环境中找到指定物体。对于“寻找马桶”“找到红色椅子”这类任务,系统既要理解语言目标,又要持续构建空间、识别对象,并决定下一处探索位置。
现有路线大致分为两类。一类擅长结构化三维感知,能够维护对象、点云、占据地图与探索前沿;另一类依赖 VLM 的视觉语义和常识推理。将两者组合时,常见做法是把三维结果改写成坐标串、场景图字符串或自然语言描述,再放进提示词。
问题在于,文字是一种强压缩。一个三维实体特征可能同时编码类别、外观、尺度、方向、邻接关系、置信度和场景上下文,变成几句描述后只能保留有限字段。SoftNav 将这种损失称为“表征鸿沟”,并通过受控消融检验:保持三维编码器和 VLM 不变,只改变三维信息进入 VLM 的方式,连续软 token 是否比文本序列更有效。
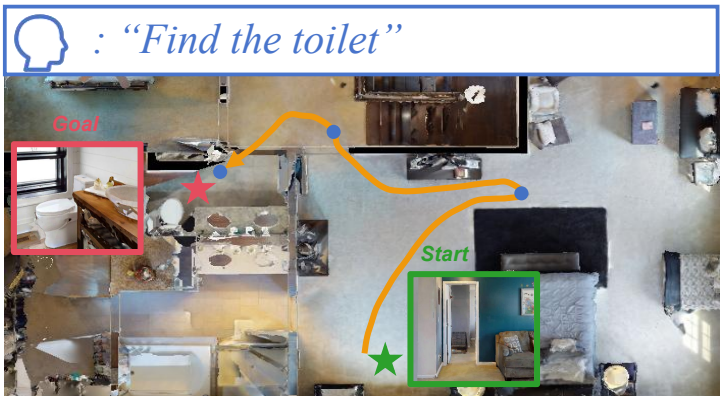
图 1:SoftNav 的目标导航示意。面对“寻找马桶”的指令,智能体从连续 RGB-D 观测中维护三维对象和探索前沿,再由注入 VLM 的软 token 引导前沿选择与移动。
图中最重要的不是终点,而是决策单位。SoftNav 不直接让 VLM 输出低层动作,而是让它在前沿候选中选择下一处探索目标。这样既保留 VLM 的语义推理能力,又利用地图前沿保证目标点可到达。
方法总览:视觉记忆与三维实体在隐藏空间会合
SoftNav 由两条并行信息流组成。视觉流使用冻结的 DINOv3,从每帧 RGB 图像提取特征,再压缩为 15 个视觉 token;系统保留最近 16 帧,形成 240 个 token 的滚动视觉记忆。
三维流使用冻结的 PQ3D。它从累积 RGB-D 观测中执行增量三维实例分割,维护对象库,并从占据地图中检测探索前沿。每个对象或前沿被编码成一个 768 维查询向量,向量中同时包含几何、语义和空间关系。
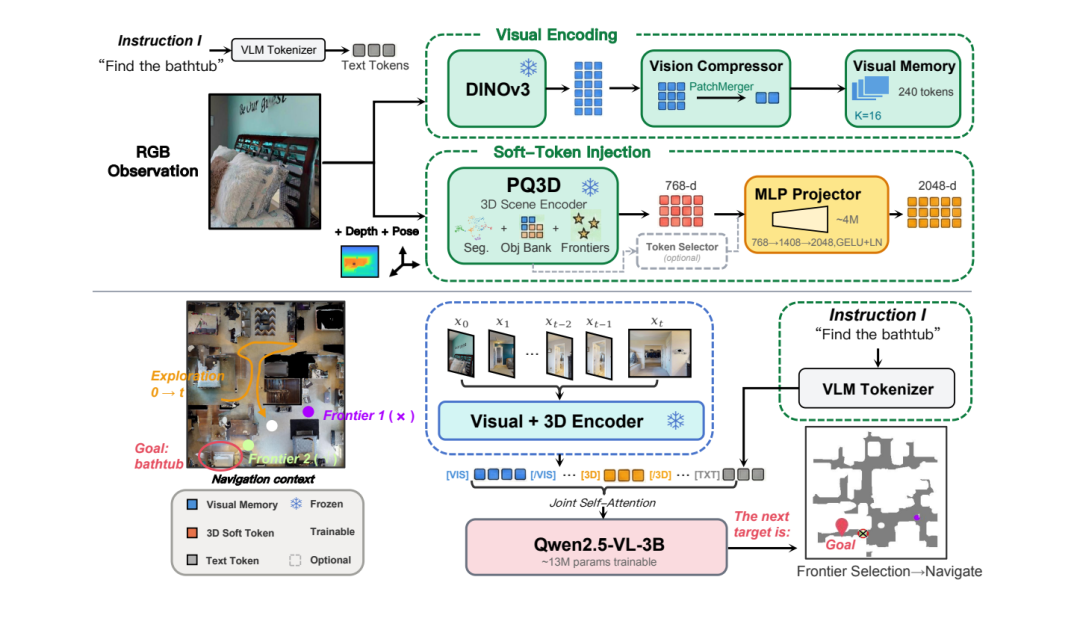
图 2:SoftNav 完整框架。上方视觉流形成多帧视觉记忆;下方 PQ3D 将对象与探索前沿编码为实体级三维查询;两层 MLP 把 768 维查询映射到 VLM 的 2048 维隐藏空间,VLM 联合视觉、三维软 token 与指令生成目标坐标,再吸附到可到达前沿。
SoftNav 的新增模块很小:一个两层 MLP 将 768 维 PQ3D 表示扩展到 2048 维,中间维度为 1408,并使用 GELU 与 LayerNorm。投影后的实体向量写入输入序列中的专用 token 位置,与视觉记忆和文本指令一同进入 Qwen2.5-VL-3B。
模型生成一个目标坐标,但系统不会直接执行该坐标,而是将其吸附到最近的合格探索前沿,并用距离比例约束避免选择过远候选。当前沿为空时,系统重新触发探索;局部移动则交给测地线跟随器。这个分工把大模型决策限制在结构化、可执行的候选空间中。
为什么只需要少量训练数据
训练阶段冻结 DINOv3、PQ3D 和 VLM 主干,只更新约 400 万参数的投影器以及约 1300 万参数的 LoRA。训练数据来自 MTU3D 成功轨迹中的前沿选择,共 1187 条监督样本,在单张 RTX 4090 上训练 6 个 epoch。
作者选择轻量 MLP 而非更复杂的交叉注意力,理由很实际:数据规模远小于三维编码器与 VLM 的预训练数据,复杂桥接层容易过拟合;同时 PQ3D 查询已经具备较完整的语义结构,剩余问题更接近维度与分布对齐,而不是重新学习三维语义。
知识迁移也不依赖教师与学生具有相同结构。教师系统选出的前沿坐标可以直接作为 VLM 的生成标签,因此三维模块化策略能够把导航经验迁移给生成式 VLM。
主结果:在开放词汇导航上同时提高成功与效率
论文首先在 HM3D-OVON 上评测。三个划分分别考察已见类别、同义词目标与未见目标,每个划分包含 120 个 episode。指标包括成功率 SR,以及同时考虑成功和路径长度的 SPL。
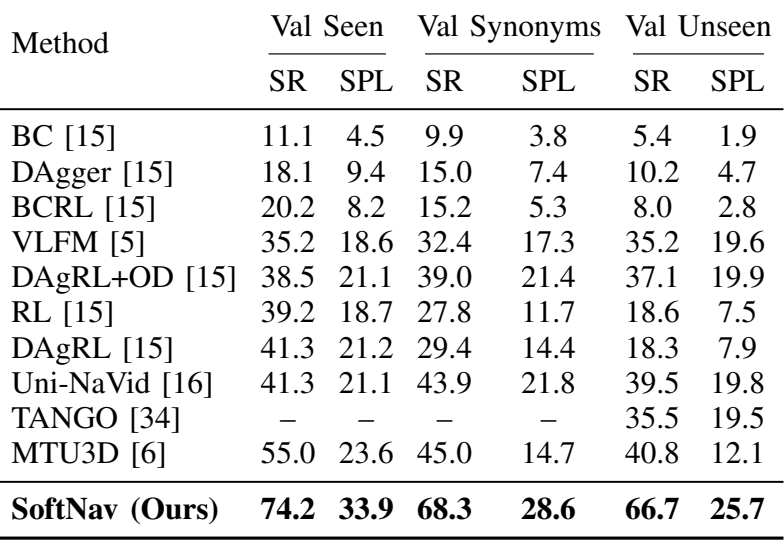
表 1:HM3D-OVON 主结果。SoftNav 在 Val Seen、Val Synonyms 和 Val Unseen 上分别达到 74.2%、68.3% 和 66.7% SR,SPL 分别为 33.9%、28.6% 和 25.7%。
相较采用同一 PQ3D 后端的 MTU3D,SoftNav 在三个划分上的 SR 分别提高 19.2、23.3 和 25.9 个百分点,且 SPL 同步提升。最大的成功率增益出现在未见目标划分,说明少量训练并没有把策略限制在训练目标词汇中。
不过跨方法主表包含不同训练范式,不能把全部提升都归因于软 token。真正支持因果判断的是后面的受控消融:相同 PQ3D、相同 VLM、相同训练数据,只替换三维信息传递方式。
零样本迁移:同一个策略跨越三类任务
SoftNav 的导航策略只在 OVON 上训练,随后不修改投影器和 LoRA,直接测试 GOAT-Bench 与 SG3D。前者包含类别、描述和图像等多模态目标,后者要求根据场景图关系连续完成多个子任务。
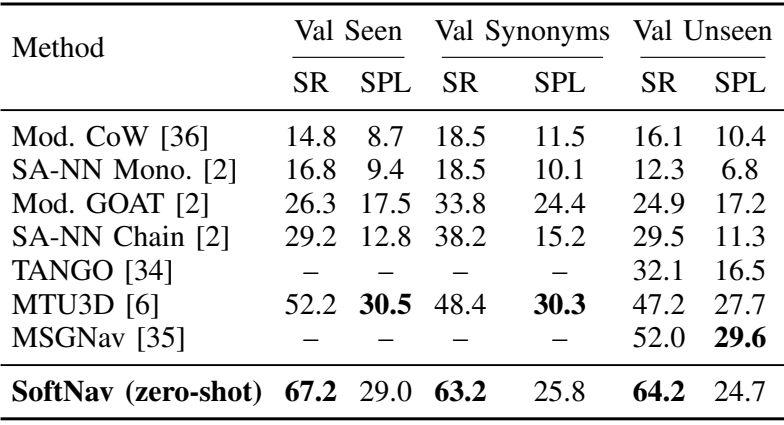
表 2:GOAT-Bench 零样本迁移。仅在 OVON 训练的 SoftNav 在三个划分上取得 67.2%、63.2% 和 64.2% SR,均高于表中对照;SPL 略低于最强基线。
GOAT-Bench 的结果揭示了一个重要取舍:SoftNav 找到目标的概率更高,但在新布局中路径不总是最短。例如未见划分 SR 达到 64.2%,而 SPL 为 24.7%,低于 MSGNav 的 29.6%。连续表示提升了语义覆盖,却还没有完全解决陌生空间中的高效路径规划。
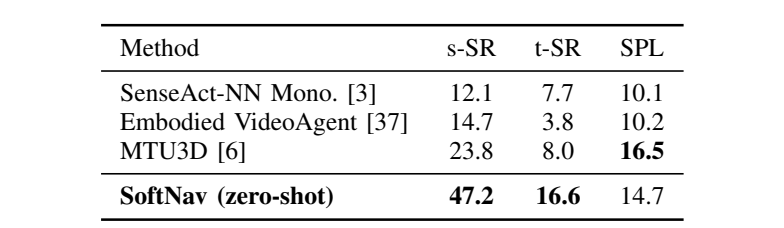
表 3:SG3D 零样本迁移。SoftNav 的子任务成功率为 47.2%,完整任务成功率为 16.6%,分别超过此前最佳结果 23.4 和 8.6 个百分点;SPL 为 14.7%。
SG3D 中成功率几乎翻倍,表明实体级三维 token 不只适用于单一物体类别,还能承载关系化目标所需的场景结构。但完整任务成功率仍只有 16.6%,说明多个子任务串联后,单步错误和定位失败会快速累积。
核心消融:损失来自文本通道,而不只是模型没训练够
作者设置了四种三维信息形式:坐标文本、带距离/方向/置信度的丰富文本、坐标文本加 LoRA,以及 SoftNav 的连续软 token。它们共享相同 PQ3D 和 VLM,因而能够更直接地判断表示方式的影响。
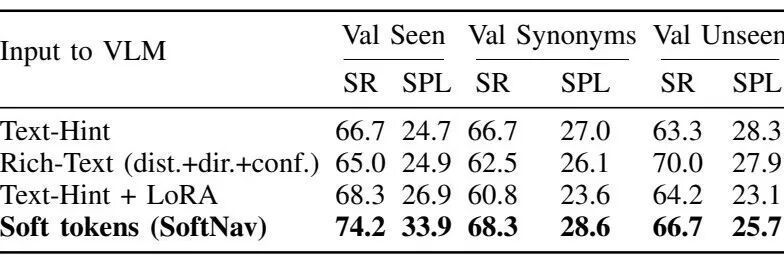
表 4:三维表示通道的受控消融。已见划分中,软 token 将 SR 从坐标文本的 66.7% 提高到 74.2%,SPL 从 24.7% 提高到 33.9%;仅对文本方案加入 LoRA,改善明显更小。
在已见划分上,软 token 的 SPL 提升 9.2 个百分点,配对 bootstrap 检验的 p 值小于 0.0001;SR 提升 7.5 个百分点,p 值为 0.028。给坐标文本加入同样的 LoRA,只带来 2.2 个百分点 SPL 和 1.6 个百分点 SR 提升,说明新增容量并不是主要来源。
更丰富的文字描述也没有稳定缩小差距:它在已见和同义词划分下降,却在未见划分取得更高 SR。作者据此谨慎地认为,VLM 对文本空间描述的利用具有较强分布依赖,而连续实体表示在不同划分间更一致。
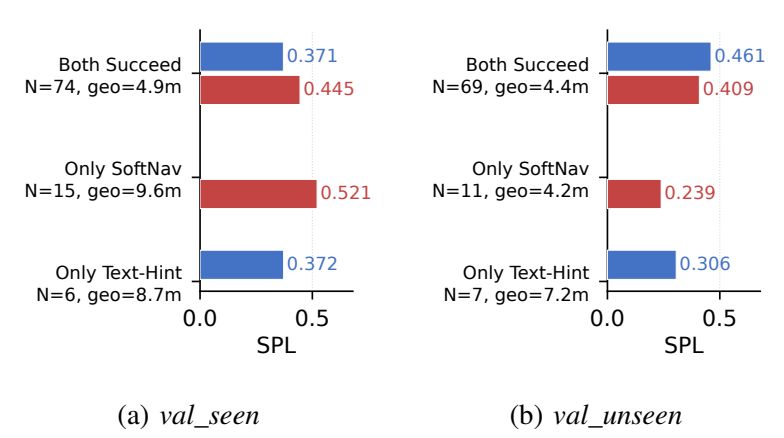
图 3:SoftNav 与坐标文本基线的逐 episode SPL。红色为 SoftNav,蓝色为 Text-Hint;左图为已见划分,右图为未见划分,点的分组区分共同成功与各自独占成功的 episode。
逐 episode 结果说明提升并非均匀发生。已见划分中,SoftNav 在共同成功的 74 个 episode 上路径更高效,还额外解决 15 个更长、更难的 episode。未见划分中,它额外解决 11 个 episode,但共同成功场景的路径更长,解释了“SR 上升、SPL 略降”的现象。
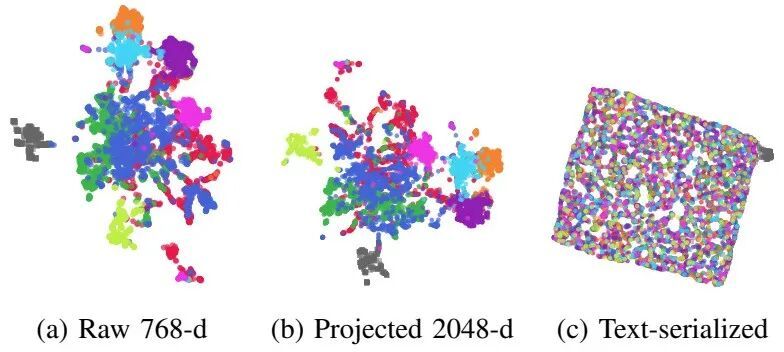
图 4:PQ3D 查询表示的 UMAP 可视化。左侧原始 768 维实体表示形成清晰聚类,中间投影到 2048 维后仍保留组织结构,右侧文本序列化后结构明显散失。
这张图给出直观补充:轻量投影器没有把 PQ3D 的结构打散,而是把它平移到 VLM 能读取的隐藏空间;文本序列化则把连续邻域关系切断。需要强调的是,UMAP 只是可视化证据,真正有统计支持的仍是同设置下的导航消融。
定性轨迹:成功之外,还要看为什么绕路
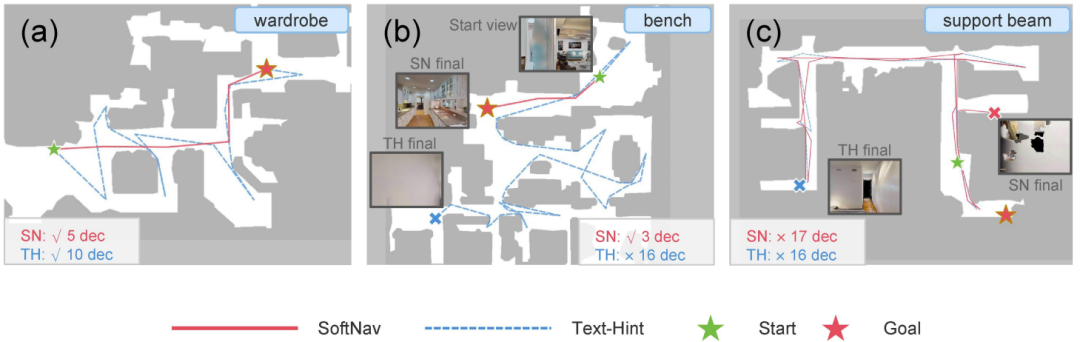
图 5:OVON 未见划分的三组代表性轨迹。第一组两者都成功,但 SoftNav 决策次数更少;第二组只有 SoftNav 找到目标;第三组目标被支撑梁严重遮挡,两种方法均失败。
第一组中,SoftNav 用 5 次决策完成,而文本基线需要 10 次。第二组中,SoftNav 3 次决策到达目标,文本方案向错误区域探索 16 次后耗尽步数。第三组则暴露共同上限:如果 PQ3D 没有可靠检测到被严重遮挡的目标,后续无论采用连续 token 还是文字都缺少有效证据。
这说明 SoftNav 改善的是“已有三维信息如何进入决策”,并不替代三维检测、建图和数据关联。上游感知漏检仍会成为系统瓶颈。
真实机器人:从 Habitat 到 Unitree Go2
作者将完全在 Habitat 中训练的策略部署到搭载 RealSense D435i 的 Unitree Go2。三维感知与规划在外部计算设备上运行,机器人自带控制器执行前沿航点。走廊、大厅和室外环境各测试 10 次。
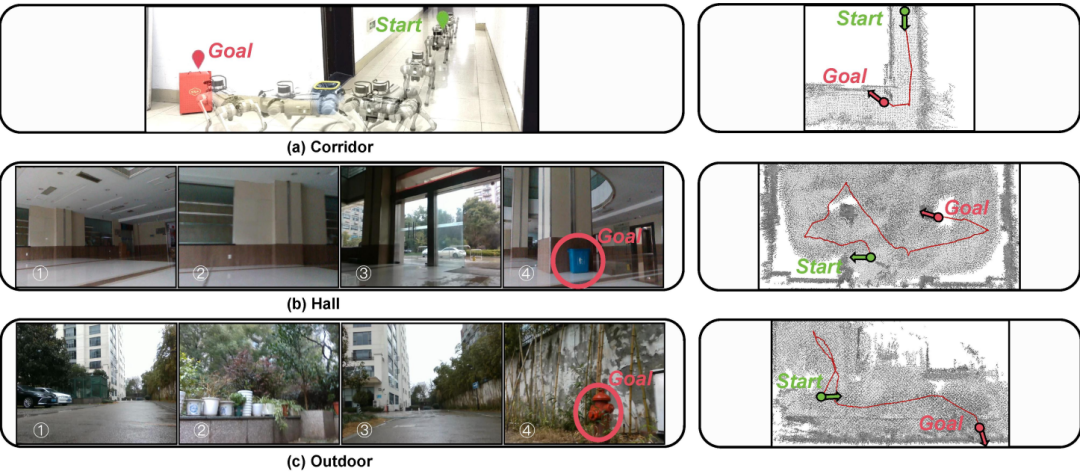
图 6:Unitree Go2 真实环境测试。走廊成功 8/10,大厅成功 6/10,室外成功 5/10;图中同时展示机器人观测、点云地图与导航轨迹。
总计 19/30 次成功,成功率 63.3%。室外环境不在室内训练分布中,仍完成一半任务,说明策略具备一定迁移能力。但实验规模较小,成功由人工判断,且计算并非完全机载,因此更适合作为可行性验证,而不是对复杂真实部署能力的充分证明。
Token 并非越少越好
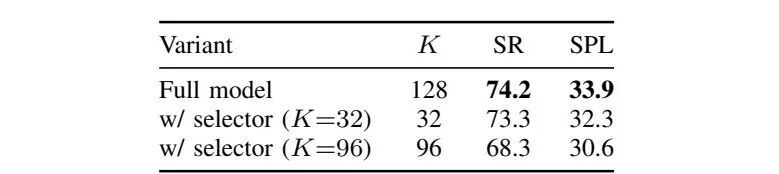
表 5:实体 token 选择消融。完整模型注入全部 128 个 token,SR/SPL 为 74.2%/33.9%;保留 32 或 96 个 token 均未带来提升。
直觉上,只保留与指令最相关的对象和前沿可以减少计算。但实验中,保留 32 个 token 得到 73.3% SR,保留 96 个反而降至 68.3%,都不如全部注入。一个解释是三维查询包含密集的场景上下文,硬筛选会删除对空间关系有用的实体;另一个解释是 1187 条样本不足以同时训练选择器、投影器和 LoRA。
边界与研究启发
SoftNav 的贡献不是发明新的三维编码器,也不是重新训练更大的 VLM,而是把注意力放在两个成熟模块之间的信息损失上。这个视角对具身智能很有启发:系统性能不只由每个模块的上限决定,也取决于模块之间传递的表示是否保真。
论文仍有几项清晰边界。首先,方法只与 PQ3D 结合,尚未证明换用其他三维编码器仍能保持同样收益。其次,训练样本少是优点,也限制了未见环境中的路径适应和 token 选择学习。再次,单步决策约需 1 秒,其中三维感知约 0.45 秒、VLM 推理约 0.49 秒;投影器只有 0.07 毫秒,计算瓶颈仍在两端主干。最后,真实测试规模、环境多样性和自主计算条件都还不足以覆盖长期部署。
未来值得关注的方向包括:用更高效的三维编码器和小型 VLM 缩短闭环延迟;让实体 token 带有显式时间状态,以处理动态目标和场景变化;从硬 Top-K 转向可微的稀疏路由;以及把表示对齐与不确定性估计结合,使 VLM 知道哪些三维实体可信、哪些只是临时候选。
总结
SoftNav 证明了一个看似细小、实则关键的判断:三维场景理解的结果,不一定要先翻译成文字才能交给 VLM。把对象和探索前沿的连续表示直接投影为软 token,可以保留更多几何与语义结构,并在少量训练数据下改善开放词汇导航。
它在 HM3D-OVON 上同时提高成功率和路径效率,单一策略还能零样本迁移到 GOAT-Bench、SG3D 与真实四足机器人。受控消融进一步表明,主要增益来自连续表示本身,而不是简单增加 LoRA 或补充更多文本字段。与此同时,路径效率、上游漏检、单步延迟和真实实验规模仍构成明确边界。
这项工作的价值,在于把具身系统的研究问题从“换一个更强模块”推进到“让模块之间真正传递完整信息”。
原文链接: https://www.leiphone.com/category/private/F5nh5C0a6u9hEGjb.html
