


来源:深蓝具身智能
原文链接:https://mp\.weixin\.qq\.com/s/KSF\-DndHNSau02ZYBMCT8Q
懂物理的3D世界模型,才有资格谈动态操控
——高速动态任务场景
不可否认,VLA与视频世界模型在静态或准静态任务上已取得显著进展。
而在真实产线、日常服务场景中的目标往往处于持续运动状态——传送带上的工件、旋转货架上的货品、投掷而来的球体……
这些动态物体的通用操作仍是机器人落地的真正分水岭。
一个直观的数据:香港理工大学近日收录在ECCV的一项研究工作,将VLA模型π0.5部署至8个高速动态任务,平均成功率仅8.3%,几乎等同于随机尝试。
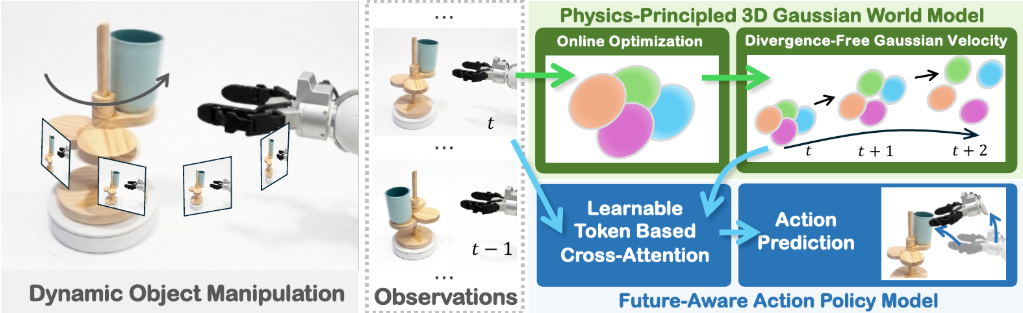
为此他们给出新的解法:一套将“物理原则3D高斯速度场世界模型”与“未来感知动作策略”紧耦合的框架。
VLA和世界模型为什么搞不定动态操控
现有三条路线的结构性短板
当前机器人操作的主流方案集中在三类,但它们面对动态目标各有致命缺陷:
VLA模型
OpenVLA、pi0.5等用统一框架处理视觉-语言-动作,在静态任务上确实能打,但底层逻辑是"看到画面→输出轨迹",缺少对未来运动状态的显式建模。
pi0.5在PhysMani-Bench高速任务上几乎全崩,它不是"抓不准",而是根本"来不及想目标下一步会在哪"。
视频世界模型
Cosmos、Sora等视频生成模型存在两点问题:一是预测仅限于2D图像空间,缺乏3D几何感知;二是一味追求画面逼真,却经常违反基本物理定律。
任务特化方案
打乒乓球、踢足球、传送带抓取等,每条管线只针对一个特定场景优化,换一个任务就得重写整个流程,谈不上通用框架。
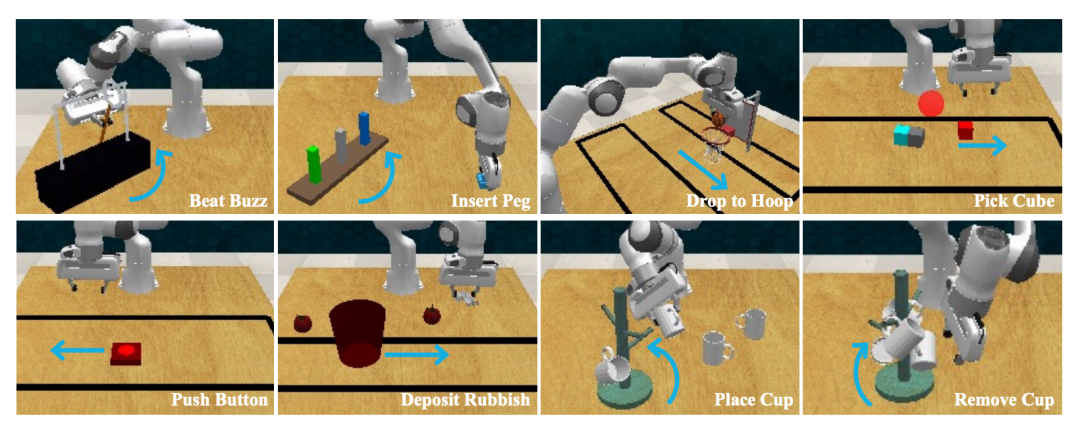
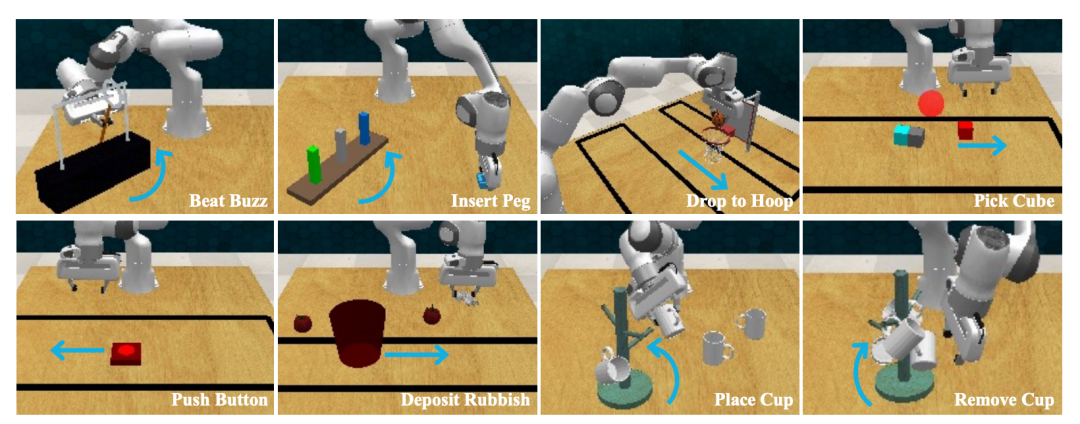
▲PhysMani-Bench 16项多样化动态任务示意,蓝色箭头标注运动目标的复杂轨迹©【深蓝具身智能】编译
PhysMani的切入方式
PhysMani不做视频预测,不做端到端VLA,而是把问题拆成两段:
先建一个能在线学习物理规律的3D世界模型,再让策略网络把这个模型的预测当成"额外输入"来做决策。
两类模型是解耦的、并行的。
世界模型持续追踪场景的3D几何和物理动态,策略模型拿到当前观测和未来动态预测后输出动作。
这种模块化设计有一个工程好处:哪部分不够好就改哪部分,不需要动全局架构。
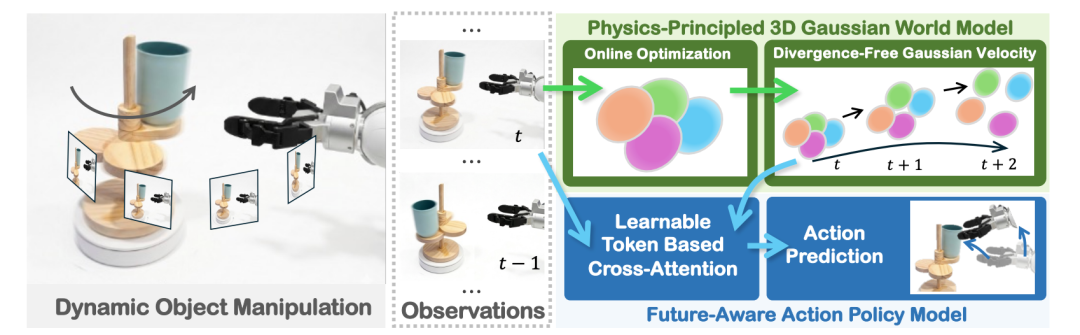
▲PhysMani整体框架总览——物理原则3D高斯世界模型(上)与未来感知动作策略模型(下)协同工作©【深蓝具身智能】编译
物理原则世界模型 + 未来感知策略
在线优化的散度自由高斯速度场
PhysMani的世界模型改造自港理工团队前序工作FreeGave(CVPR 2025)。
FreeGave首次提出了散度自由的高斯速度场,数学上保证每个高斯粒子的速度场无源无汇,等价于流体不可压缩约束,天然符合物理守恒规律。
但FreeGave的设计有个问题:依赖一个独立的形变网络做离线优化,推理一帧要607ms,根本跟不上动态操控的节奏。
PhysMani的核心改造是把整个流程拉进在线循环:
砍掉形变网络和形变辅助优化策略;
用一个轻量MLP()直接从高斯位置和时间戳学习六个基本速度分量(三个平动 + 三个转动);
每收到新一帧RGB-D,执行50轮梯度迭代更新速度场参数;
冻结速度网络后,额外做7轮微调补偿场景外观的微量变化;
最终单帧优化降到约200ms(RTX4090),且可以通过复用静态计算图大幅削减CUDA核启动开销。
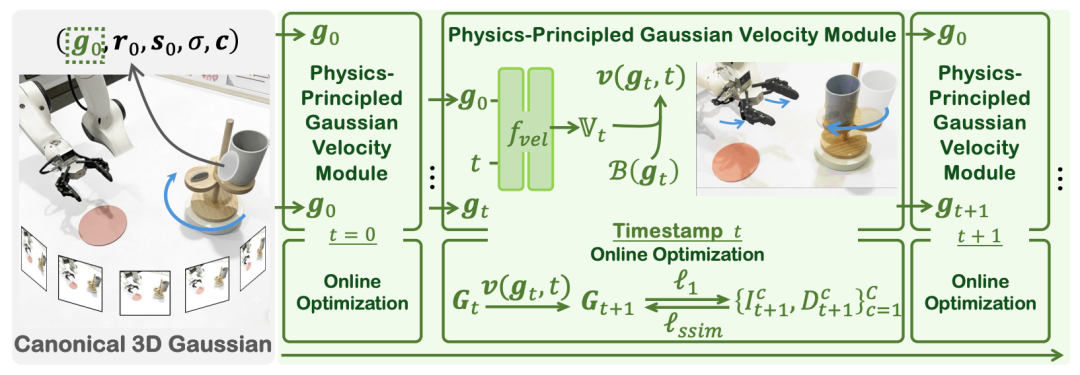
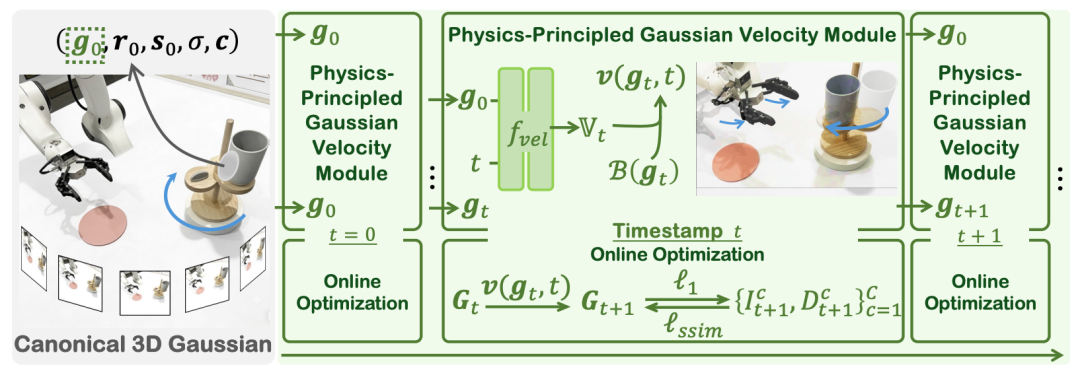
▲规范3D高斯模块(左)与物理高斯速度模块(右),底部展示了在线优化的迭代流程©【深蓝具身智能】编译
散度自由这个约束的价值很容易被忽略。通俗来说,它意味着模型学到的运动场不会凭空"创造"或"消灭"物体:一个杯子不会突然分裂成两个,一个球不会莫名停在半空。
这些物理常识对视频生成模型来说是"可选项",但对机器人操控是"必选项"。
KNN近邻 + 可学习Token:把未来动态喂给策略
世界模型输出的是3万个高斯粒子的速度向量。如何把它们转化成策略网络能理解的信号,是第二道坎。
PhysMani的设计分六步走:
对场景点云Pt中每个点,用KNN找到最近的K个高斯邻居
计算相对偏移量∆P和对应的速度分量Dt
两路分别过MLP,统一到相同特征维度
引入一个可学习向量L作为Query Token,做三次交叉注意力(偏移量做Key,速度分量做Value)
得到最终的速度Token
直接加到视觉Token上,形成"未来感知Token"At
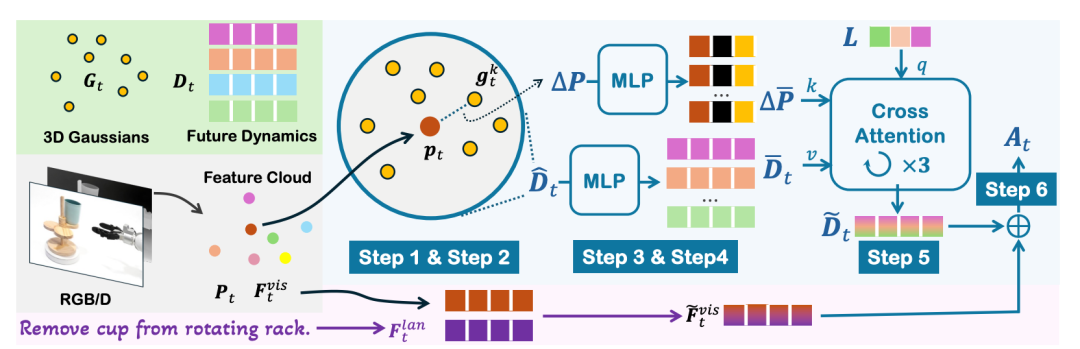
▲视觉/语言编码(左)+ 六步未来动力学融合模块(右),通过可学习Token交叉注意力将高斯速度场注入策略网络©【深蓝具身智能】编译
这个设计有两个巧思:
一是L是模型自己学出来的,不需要人工定义"哪些运动信息更重要";
二是加性融合(动力学Token ⊕ 视觉Token)确保两种信息不会互相覆盖。
策略网络本身沿用3DFA(3D FlowMatch Actor)作为骨架,不做额外改动——也就是说,PhysMani相对于3DFA的唯一增量就是这套世界模型+动态融合模块。
PhysMani-Bench:首个通用动态操控基准
现有机器人基准(RLBench、LIBERO、CALVIN)清一色是静态或准静态任务。PhysMani团队从RLBench中扩展出8大类动态任务,每类分为常速和高速两个难度,共16项:
绕障穿孔(Beat Buzz):控制环沿旋转导线行走,不能触碰
旋转插柱(Insert Peg):将环插入旋转底座上的立柱
移动投篮(Drop to Hoop):捡球投入移动篮筐
桌面抓取移动方块(Pick Cube)
按压移动按钮(Push Button)
垃圾投入移动桶(Deposit Rubbish)
杯子挂上旋转架 / 从旋转架取下(Place/Remove Cup)
目标移动速度设为与Franka机械臂最大末端速度同级(约2 m/s),属于高速动态场景。
实验
仿真16任务主结果
几个值得注意的数据分布:
高速任务才拉开的差距:常速任务PhysMani和3DFA差距不大(45.9% vs 37.8%),但8个高速任务上,PhysMani达到46.7%,接近3倍于3DFA
目标移动越快,纯反应式策略越跟不上,越需要预测能力兜底。
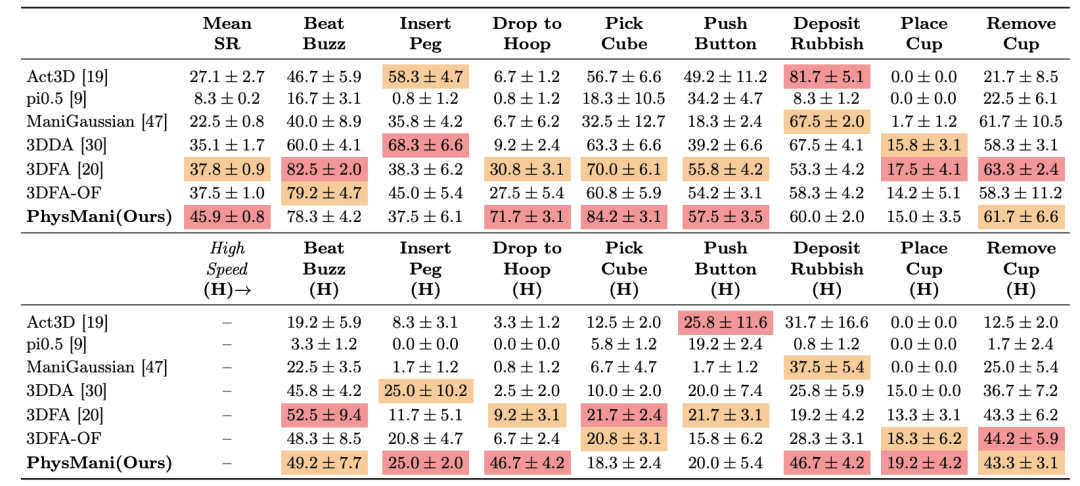
▲16项动态任务平均成功率(%)对比,PhysMani比次优方法3DFA高出8.1个百分点©【深蓝具身智能】编译
2D光流不如3D速度场:给3DFA输入加上2D光流通道(3DFA-OF),性能几乎没有提升(37.5% vs 37.8%)。
二维平面上的像素位移信息,无法替代三维空间中基于物理的速度预测。
VLA模型完全不适配:pi0.5在高速任务上平均仅3.9%,Place Cup高速为0%,根本原因是pi0.5的视觉编码和动作解码都是为静态场景设计的,没有3D空间表征能力。
未来帧预测
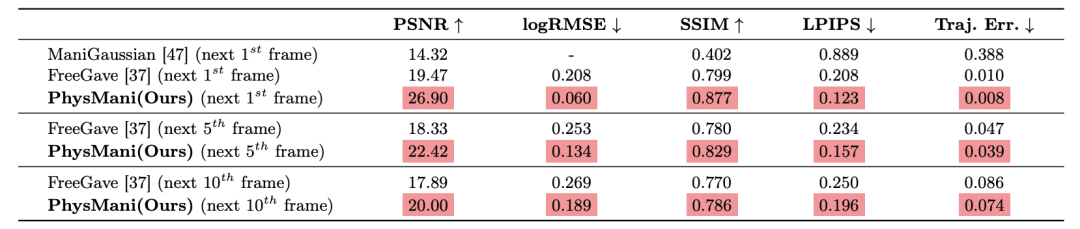
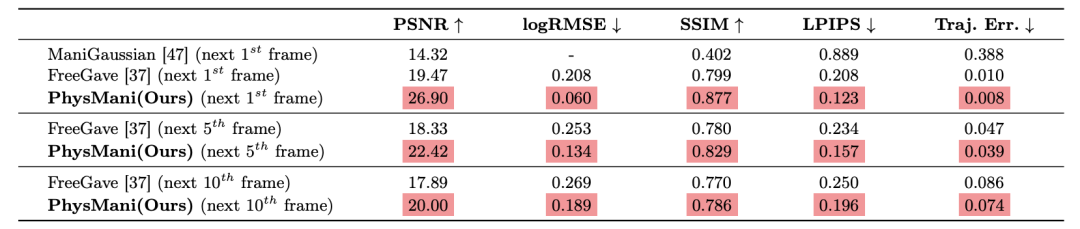
▲未来帧预测质量——PhysMani在全部指标上显著领先ManiGaussian和FreeGave©【深蓝具身智能】编译
第一帧预测PSNR 26.90 vs FreeGave 19.47 vs ManiGaussian 14.32;做10步前推后PSNR仍保持20.00,FreeGave掉到17.89。
更关键的是轨迹误差(预测目标中心与实际位置欧氏距离):第1帧仅0.008m,第10帧0.074m;而ManiGaussian第1帧就达到0.388m,差了近50倍。
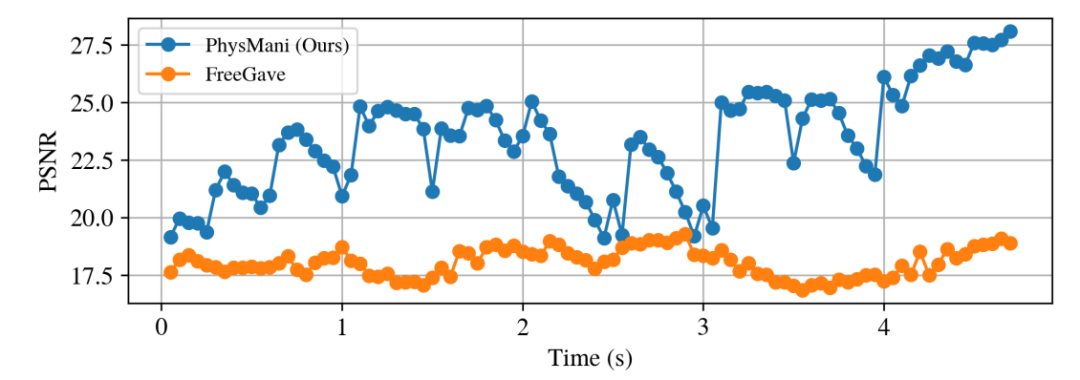
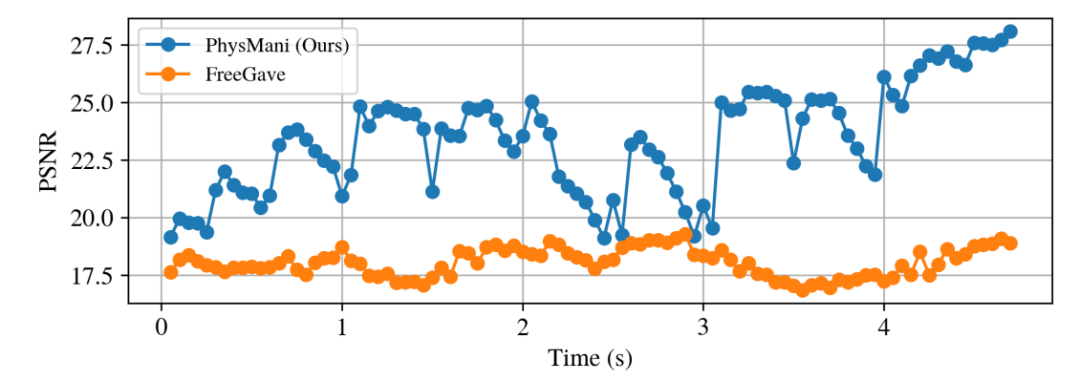
▲等量计算预算下PhysMani与FreeGave的PSNR时序均值对比,PhysMani快3倍且质量更高©【深蓝具身智能】编译
速度优势源于架构精简:FreeGave 607ms/帧,PhysMani仅205ms/帧,且PSNR曲线全程高于FreeGave——不是"以速度换质量"的取舍,而是"又快又好"。
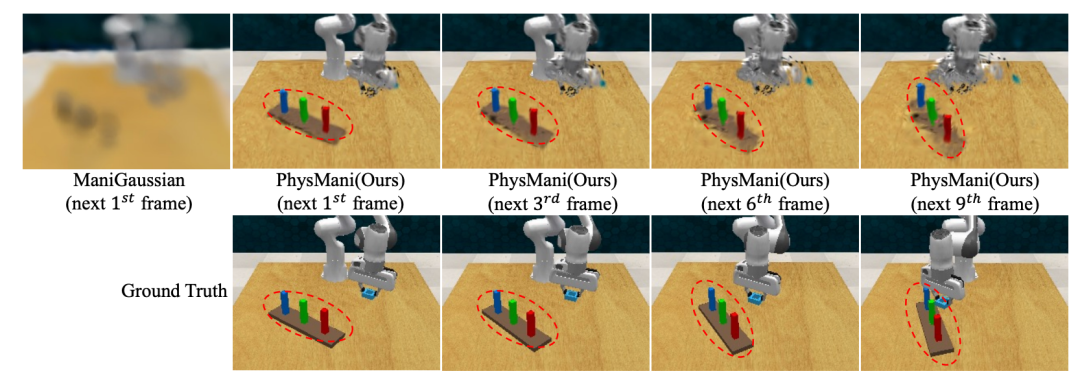
▲未来帧预测定性对比,红圈标注PhysMani对运动目标位置的精确预测©【深蓝具身智能】编译
真机验证
四项任务:传送带抓取、传送带放置、旋转架放置方块、旋转架取下杯子。64次测试覆盖不同目标速度、形状和初始位置。PhysMani在Place on Belt(62.5% vs 37.5%)和Place on Rack(25.0% vs 6.3%)两项上优势尤为明显。
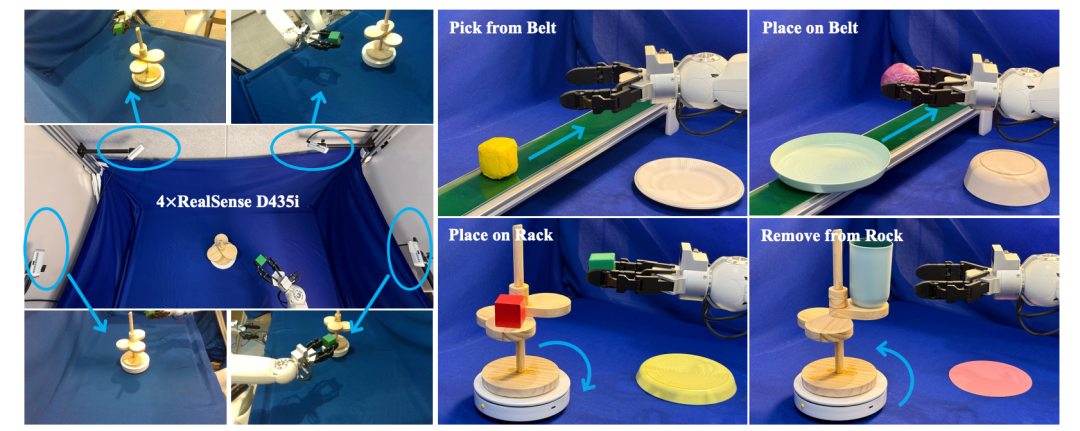
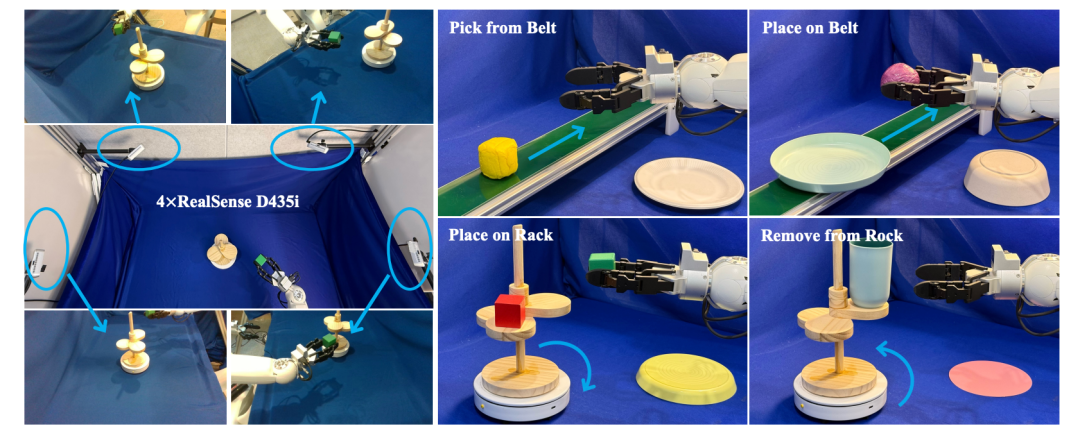
▲真机实验设置(Astribot S1机械臂 + 4台RealSense D435i)与四项真实动态任务©【深蓝具身智能】编译
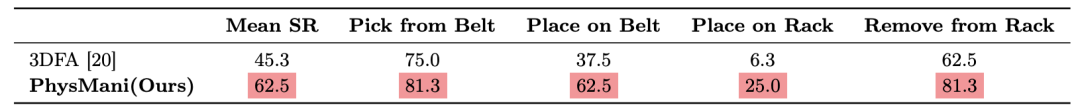
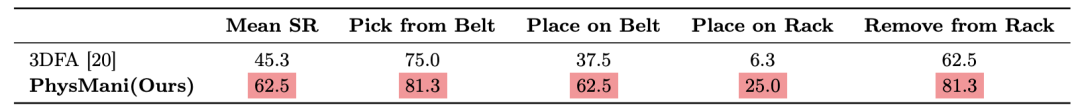
▲真机4项动态任务成功率,PhysMani均值62.5% vs 3DFA 45.3%©【深蓝具身智能】编译
需要客观看待的是,真机实验规模较小(每项仅16试次),且使用Astribot S1这台性能较强的机械臂——在更廉价、精度更低的机械臂上能否复现,论文没有验证。
行业定位与局限
三条路线的横向对比
在动态物体操控这条赛道上,目前有三条路:
VLA端到端(pi0.5、OpenVLA 等):优势是统一架构、泛化性好;短板是缺少3D空间和物理动态建模,高速目标下基本失效
视频世界模型+策略(Cosmos + 控制模块 等):优势是想预测什么就能预测什么;短板是2D限定、物理不保真、延迟高
物理3D世界模型+策略(PhysMani):优势是物理一致、3D几何准确、延迟可控;短板是依赖多视角RGB-D和固定相机布局
PhysMani是第三条路线上第一个在通用动态操控基准上完成系统验证的工作。其核心定位不是替代VLA,而是在VLA失效的高速动态场景中补位。
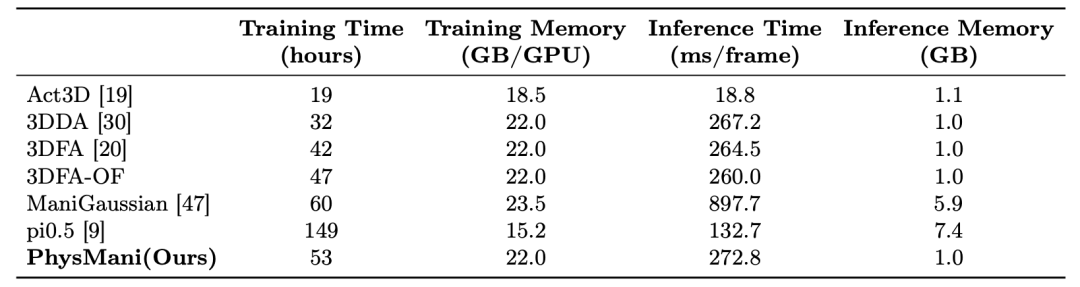
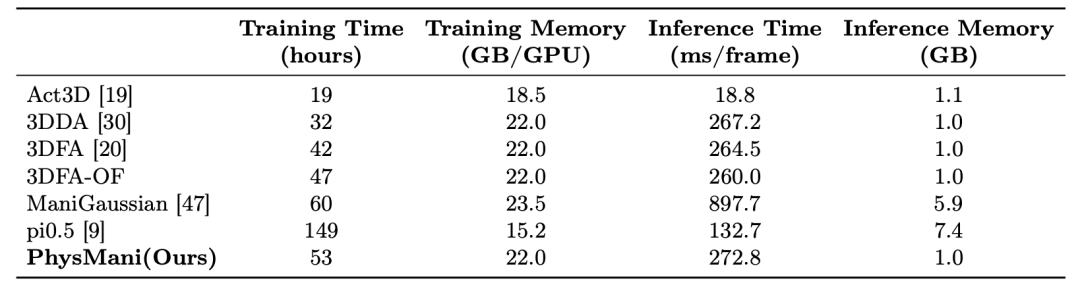
▲训练/推理时间与内存对比,PhysMani训练53小时(远少于pi0.5的149小时),推理272.8ms/帧©【深蓝具身智能】编译
四个无法回避的局限
场景假设严苛:依赖4台固定RGB-D相机,这在实验室标准RLBench环境下成立,但放到非结构化场景(杂乱仓库、移动视角)就会失效;
世界模型在线优化有延迟天花板:200ms/轮是RTX4090上的数据,移植到边缘设备(Jetson Orin等)后延迟至少翻几倍,能否满足高速动态操控存疑;
任务规模和多样性有限:16个任务虽然比零强,但距离"通用动态操控"还有明显距离。研究中也明确指出扩展到PhysInOne的规模(数百上千任务)是一项非平凡工程;
仅适配单臂操作:所有实验在Franka Panda或Astribot S1单臂上完成,双臂协同、移动底盘+机械臂等场景未涉及。
物理上正确的3D未来预测
PhysMani做了一个定位清晰的减法:不追求VLA的"大而全",不走视频世界模型的"看着好看但不管用"路线,而是把“物理上正确的3D未来预测”作为唯一核心,用一套轻量级世界模型+可学习Token融合的方式嵌入现有策略网络。
效果是明显的——在高速动态任务上对VLA形成碾压级优势,对同架构基线也有稳定的8个百分点提升。
但这套方案目前仍然高度依赖实验室级的传感和算力配置,离"任意动态场景、任意硬件、即插即用"还有不小的距离。
如果要把这件事往实用方向推,最迫切的是两个方向:
一是降低世界模型对多视角RGB-D的依赖(单目、双目),二是把200ms的在线优化延迟打到100ms以内。
至少,在当前阶段,教会机器人"看懂物理"比教会它"说人话"对动态操控的价值高得多。
原文链接: https://www.leiphone.com/category/private/WvwJXwBImcfDzk6A.html
