


来源:智驾具身新世界
原文链接:https://mp\.weixin\.qq\.com/s/JsebXS7LzFhcKMECrnVP5g
本篇论文出发点:
现有端到端自动驾驶模型的局限性:虽然是端到端方案了,感知决策规划在一个网络中,但仍然存在长尾场景泛化能力差(没见过的情况容易出错),复杂语义理解不足的问题,比如(比如交通意图、规则、上下文),缺乏灵活推理能力(决策比较“死板”)
VLM模型可以缓解上述问题,但直接将vlm模型应用到自动驾驶领域也有问题:
当前VLM模型都是基于2D图像训练的,缺乏3D空间推理能力
VLM模型容易出现过于自信但又错误的描述(“幻觉),这对自动驾驶来说是灾难性的问题
本篇论文为了解决以上问题,通过引入结构化视觉表征和交互建模,让vlm能看懂3D驾驶管径、理解指令,生成可靠的规划轨迹。
本文主要贡献:
提出 OpenDriveVLA,一种融合 2D/3D 视觉、多模态输入和语言指令的端到端视觉-语言-动作模型,用于直接生成空间对齐的驾驶轨迹。
设计分层视觉-语言对齐方法,将结构化 2D 与 3D 视觉表示映射到统一语义空间,并引入智能体-环境-自车交互建模以增强空间推理与安全性。
知识点介绍:
nuScenes-QA:一个用来评估和训练自动驾驶模型场景理解与推理能力的问答数据集
视觉-语言-动作模型(VLA):将感知、语言理解与动作生成统一到一个大模型中,实现从多模态输入直接输出驾驶行为。
3D空间感知与跨模态对齐:通过结构化的 2D/3D 表示与分层视觉-语言对齐,使模型具备真实驾驶场景中的空间理解能力。
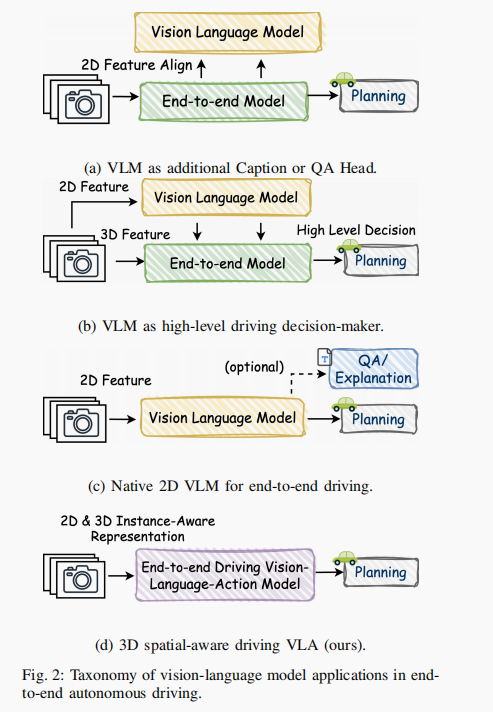
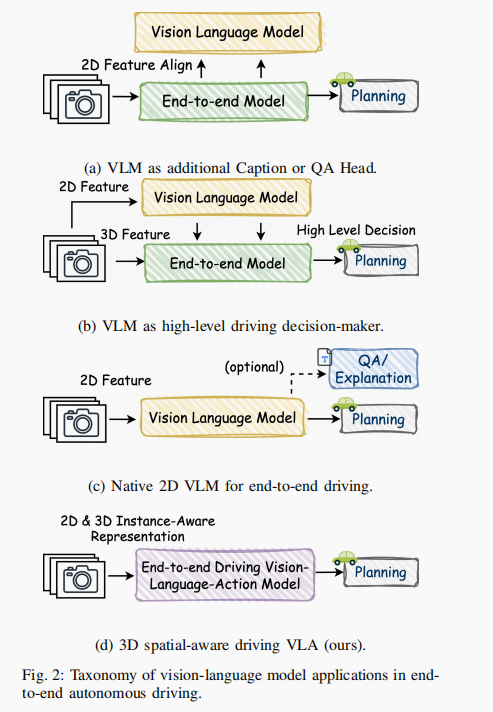
当前VLM模型在自动驾驶中的用法如下图
VLM不参与规划决策,只负责解释;一般做法是给驾驶模型加一个 caption(描述)或 QA(问答)头
VLM参与决策,输出高层指令给规划器执行;一般做法是VLM输出高层指令(如:左转、变道)然后panning去执行,比如drivevlm快慢系统
VLM直接做端到端,输出最终的轨迹;一般做法是直接用VLM从图像->输出轨迹,但仅用2D图像作为输入,没有3D结构,模型容易产生幻觉,看图开车不理解真实空间
本文方法:具备3D空间认知能力的端到端VLA模型
本文方法介绍:
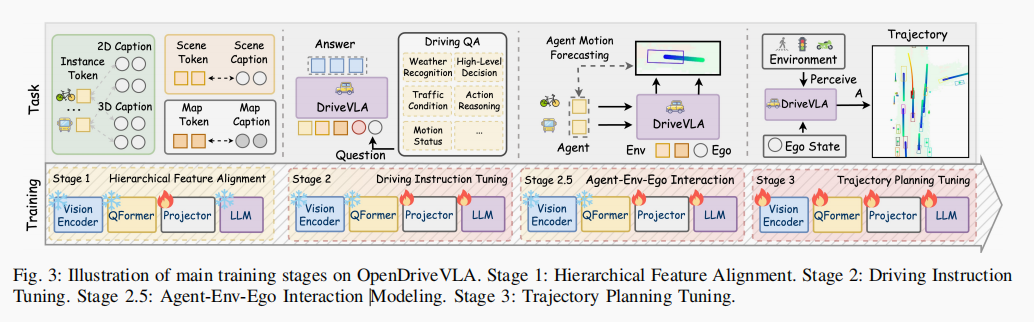
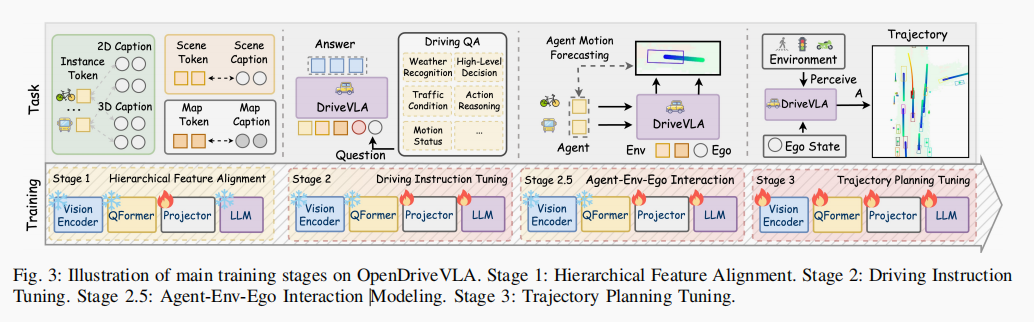
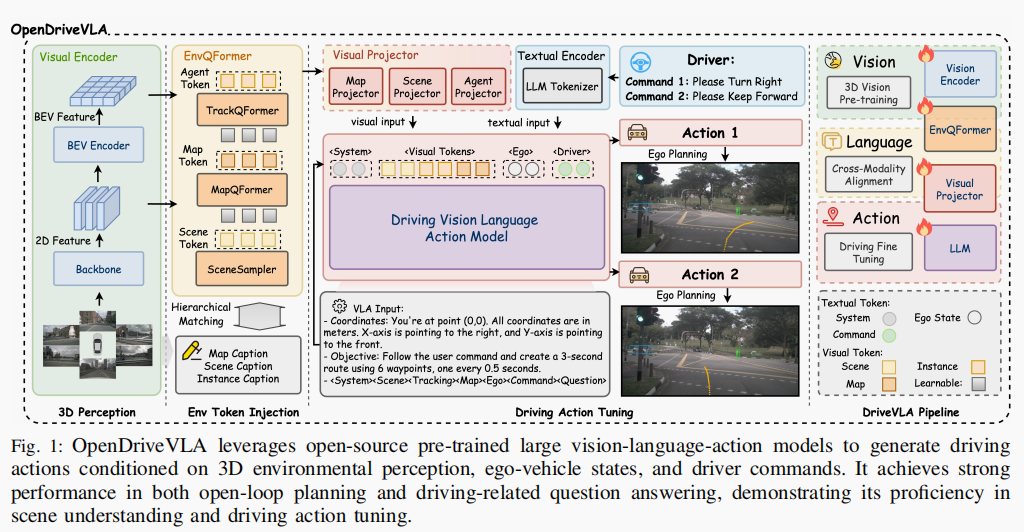
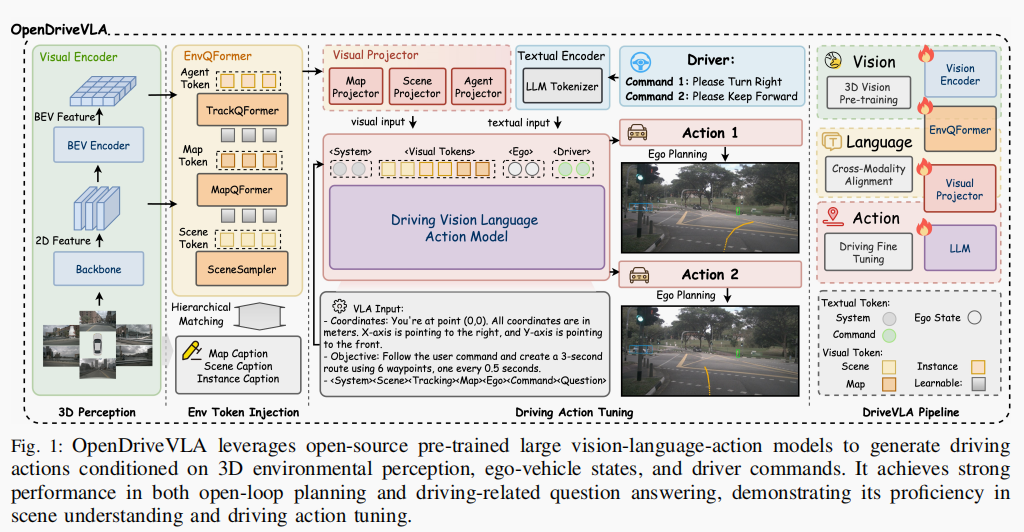
3d视觉环境感知:这一部分作者使用了bev感知方案,将2d图像转换为3d表示,同时对agent、map、env建模
stage1分层视觉-语言对齐:这一部分将1得到的三种视觉token与语言特征进行对齐,因为LLM输入是语言,所以必须得做视觉语言对齐,由于是分别对agent、map、env进行对齐,所以叫做分层对齐。实现方式就训练mlp网络实现,固定LLM只训MLP{Φscene, Φagent, Φmap}:对齐过程表述为
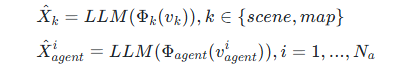
stage2驾驶指令微调:这一阶段的目标是:让模型学会“理解驾驶问题并作出合理回答”。通过构建驾驶问答数据,把感知、预测、决策等知识注入模型,使其具备:场景理解能力、指令跟随能力、基本驾驶推理能力
同时避免推理时使用复杂的 CoT,从而提高效率。
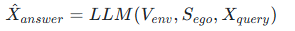
3. stage2.5智能体-环境-自车交互建模:通过引入“预测其他车辆未来轨迹”的辅助任务,模型可以学习:多车之间的相互影响、与自车的交互关系从而提升在复杂交通环境中的安全性和决策能力。第i个智能体的学习目标表述为:
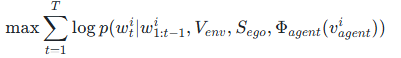
4. 阶段3:端到端轨迹生成:模型将轨迹离散成 token,用类似语言生成的方式逐步预测未来路径点,实现:
输入:环境 + 自车状态 + 指令
输出:未来轨迹
整个系统可以端到端训练,并在推理时直接生成可执行的驾驶路径。
生成过程:
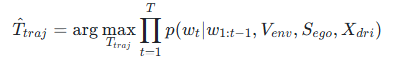
整体流程如下图
5. 实验细节:
数据集:
训练:TOD3Cap (1.89M)、nuScenes-QA (376K)、nuCaption (348K)、nuX (28K)
评估:nuScenes验证集
评估指标:
轨迹规划:L2位移误差(1s/2s/3s)、碰撞率
VQA:BLEU、METEOR、CIDEr、BERT-Score
实现细节:
视觉编码器:ResNet-101 + FPN
LLM:Qwen2.5-Instruct (0.5B/3B/7B)
训练:4×NVIDIA H100,约2天
6. 消融实验:每个阶段的累积改进:
阶段1后:碰撞率0.37%
阶段2后:碰撞率0.26%
阶段2.5后:碰撞率0.10%
阶段3后:0.09%
交互建模(阶段2.5)带来最显著的碰撞率下降。
总结:
好的:
首次系统性地将3D实例感知视觉表示与VLA模型结合用于端到端自动驾驶
训练范式:提出多阶段训练策略,有效弥合视觉与语言模态差距
开源贡献:提供开源实现
不好的:
LLM 引入带来“可解释但不可靠”的风险(幻觉问题仍未根治)本文用LLM直接回归离散轨迹点, 可能输出“看似合理但错误”的轨迹或解释,后续工作也有很多使用diffusion替换LLM回归轨迹点,平滑度会更好。
只有开环指标
原文标题: OpenDriveVLA: Towards End-to-end Autonomous Driving with Large Vision Language Action Model
原文链接: https://www.leiphone.com/category/private/Yn4F40VGxSy6AM4t.html
