


来源:公众号“gee AI学习室”
大语言模型(LLM)智能体的竞争重心正在发生转移。单纯的“提示词工程”已不足以应对复杂的现实挑战,行业开始更加关注如何赋予智能体在复杂环境中“深思熟虑的推理能力”、“主动重构的长程记忆”以及“在实战中自我进化的本能”。
本文精选了近期被机器学习顶级会议ICML 2026录用的三篇重磅论文,分别来自清华大学(Deliberate Evolution)、新加坡国立大学(MRAgent)、以及北京大学与智谱AI等(MemoPilot)。这三项研究集中展示了LLM智能体在“探索式推理”、“图记忆重构”以及“测试时学习强化”三个关键维度的突破。它们共同打破了当前大模型在复杂任务和长程交互中的落地瓶颈,打造了更聪明、更持久、更具成长性的AI“大脑”。
【亮点速览】
打破试错低效魔咒:现有的基于LLM的符号回归(SR)方法严重依赖标量反馈(如均方误差MSE),导致模型只能像无头苍蝇一样进行低效的“试错”搜索,通常需要评估上千个候选公式。清华大学等团队指出了核心痛点:现有方法将“候选生成”与“搜索引导”混为一谈。为此,他们提出了一种专为LLM设计的“深思熟虑进化(Deliberate Evolution, DE)”智能体框架,大幅提升了样本效率。
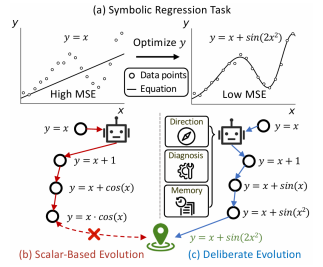
图1:标量反馈vs深思熟虑的进化。
传统的进化方法仅靠标量分数(如均方误差)进行盲目的试错搜索(图b);而DE框架则将方向指导、结构诊断和反思记忆注入到候选公式的生成中(图c),实现了从“盲目猜测”到“精准修改”的范式转移。
【创新点】
解耦生成与控制的“三驾马车”机制:
自适应算子(Adaptive Operators):提供方向引导。模型不再盲目变异,而是根据当前搜索状态明确选择是进行微调(Refine)、大幅变异(Mutate)、交叉(Crossover)还是推倒重来(Regenerate)。
工具增强诊断(Tool-augmented Proposal):提供诊断引导。利用数据分析器、残差诊断和量纲验证器,将干瘪的误差分数转化为具体的结构化修改建议(如:提示模型缺少周期函数)。
反思记忆(Reflective Memory):提供历史引导。自动总结成功模式和失败教训,避免模型在同一个坑里反复跌倒。
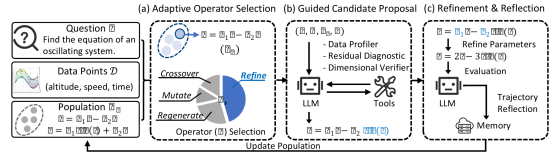
图2:DE(深思熟虑进化)系统全景图。
系统在标准的进化循环中,显式地解耦了大模型的“生成”与“引导”:(a)自适应算子提供方向引导;(b)数据与残差分析工具提供诊断反馈;(c)从历史轨迹中提炼的记忆提供排雷指南。
【成果】
极少算力,极限精度:在LLM-SRBench基准测试中,DE框架仅使用了标准样本预算的40%,就在物理、化学、材料科学等多个领域全面超越了现有的LLM-SR基线模型(如归一化均方误差降低了高达55%)。此外,模型在面对噪声数据和分布外(OOD)泛化时展现出了惊人的鲁棒性。
【亮点速览】
摒弃被动检索(RAG),走向主动重构:当前的记忆增强大模型(如传统的RAG)依赖于“检索-后-推理”的僵化流水线,无法根据推理过程中的新线索动态调整检索方向。新加坡国立大学团队从人类认知神经科学中汲取灵感(人类记忆是重构的,而非读取的),提出了MRAgent框架,彻底颠覆了传统的静态内存提取模式。
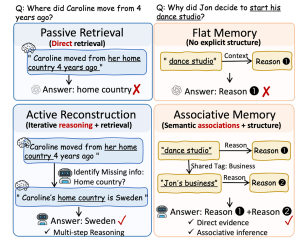
图3:被动检索与主动重构的逻辑对比。
面对复杂问题,传统的平面记忆或预设图检索容易因线索不足而陷入死胡同(右上);而MRAgen的主动重构机制(左下)允许大模型根据中间推理结果(如推断出时间节点),像滚雪球一样不断探索出正确的记忆链条。
【创新点】
线索-标签-内容(Cue-Tag-Content)关联记忆图:构建了一个多粒度的异构记忆图,将记忆分为具体的“片段(Episodic)”、抽象的“语义(Semantic)”和宏观的“主题(Topics)”。
主动重构机制(Active Reconstruction):将LLM的推理过程直接嵌入到记忆访问中。智能体可以像侦探一样,根据初始线索找到相关标签,再根据标签决定是否深入挖掘具体内容,并在多步交互中动态剪枝无关路径,防止信息爆炸。
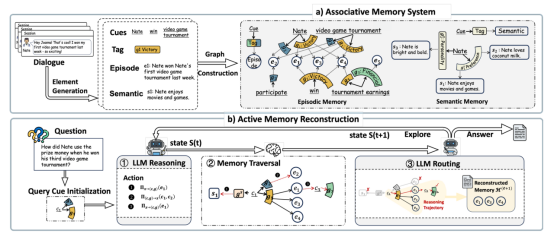
图4:MRAgent的联想记忆重构网络。
(a)建立起明确编码语义关联的Cue-Tag-Content(线索-标签-内容)异构记忆图;(b)智能体在面对查询时,不直接读取原文,而是通过大模型在记忆图上进行多轮动态路由与剪枝,实现按需的记忆重构。
【成果】
降本增效的记忆大师:在LoCoMo和LongMemEval等高难度长文本记忆基准测试中,MRAgent相比强基线模型实现了高达23%的性能提升。更令人震撼的是其工程效率:通过按需重构,它将每个样本的提示词消耗从A-Mem的632k骤降至118k,大幅降低了代币消耗和运行延迟,真正做到了“又快又准”。
【亮点速览】
赋能模型在实战中“打怪升级”:大模型在长期部署中需要通过经验不断提升自己(测试时学习,TTL)。然而,现有的记忆更新方法多依赖人工设计的提示词规则,难以在多步交互中对齐下游目标。北京大学与智谱AI等机构提出了一个外挂式的“记忆副驾驶(MemoPilot)”,直接使用强化学习来端到端训练模型的“记忆更新过程”。
【创新点】
将记忆更新转化为马尔可夫决策过程(MDP):创新性地不直接更新LLM玩家的参数,而是用强化学习(多轮GRPO)专门训练一个记忆生成器模型。
精细的信用分配机制:引入了“逐回合奖励(turn-wise reward)”和“回合级优势估计(turn-level advantage estimation)”。这解决了长程博弈中奖励稀疏和随机性大的问题,让模型明确知道哪一次的记忆更新带来了最终的胜利。
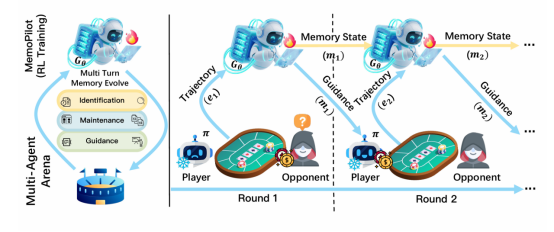
图5:MemoPilot强化学习记忆架构。
模型将被动记录转变为主动博弈:独立于冻结状态的玩家模型,MemoPilot作为一个外部插件,专门通过GRPO强化学习算法,在与对手的多轮交互轨迹中训练其提炼战略、更新记忆和提供行动指南的能力。
【成果】
从新手到大师的无缝切换:在多轮石头剪刀布(RPS)和德州扑克(LHE)博弈中,搭载MemoPilot的冻结LLM玩家胜率飙升,在两个游戏中的Elo评分均位列第一(LHE达1762,RPS达1590),远超DeepSeek-V3.2和所有基线记忆方法。更强大的是,训练好的记忆模型可以实现零样本泛化,即插即用地辅助参数量大得多的未知强模型(如Qwen3-235B),完美验证了“学得好不如记的好”的策略优势。
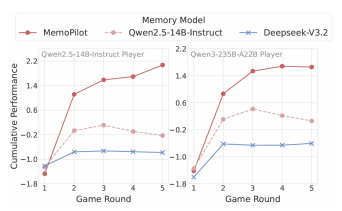
图6:测试时学习(TTL)的统治力与零样本泛化。
在德州扑克实测中,搭载MemoPilot的模型(红线)在几局之内迅速摸清对手套路,胜率大幅反超(左图)。更惊艳的是,这个经过RL训练的记忆插件可以直接“即插即用”地辅助235B的超大参数模型(右图),展现了极强的泛化协同能力。
看完这三篇论文,我最大的感受是——顶会论文里那些漂亮的创新,背后都是无数次的试错和推倒重来。Deliberate Evolution的作者在rebuttal里改了三版才把‘自适应算子’的逻辑讲清楚;MRAgent的团队为了那个Cue-Tag-Content图结构,前后迭代了7个版本……
