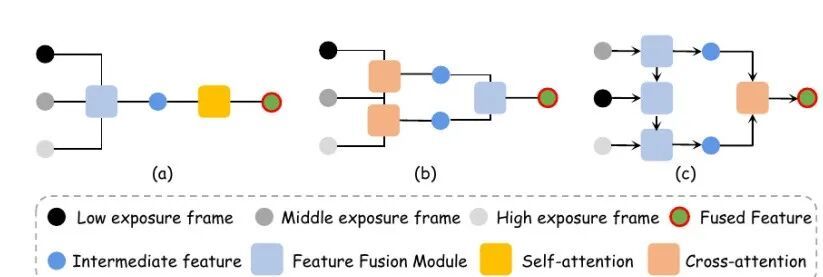
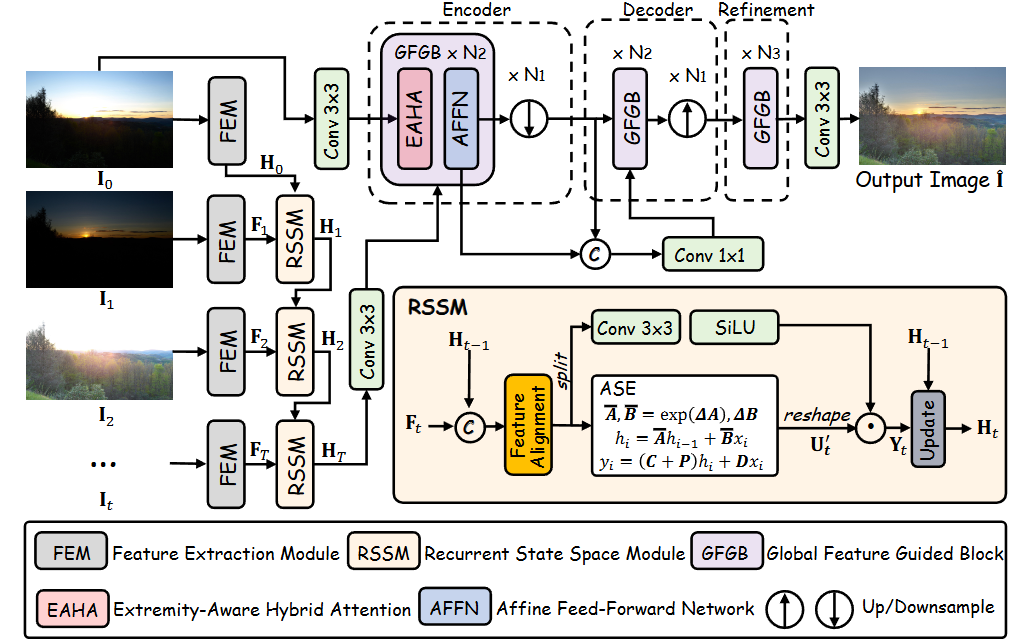
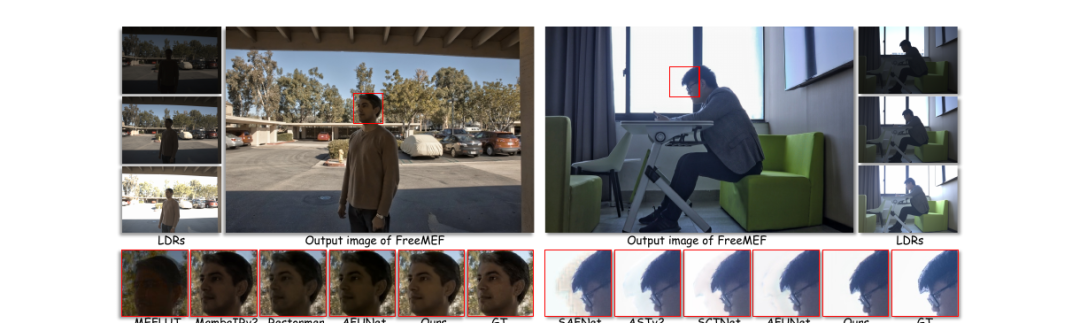
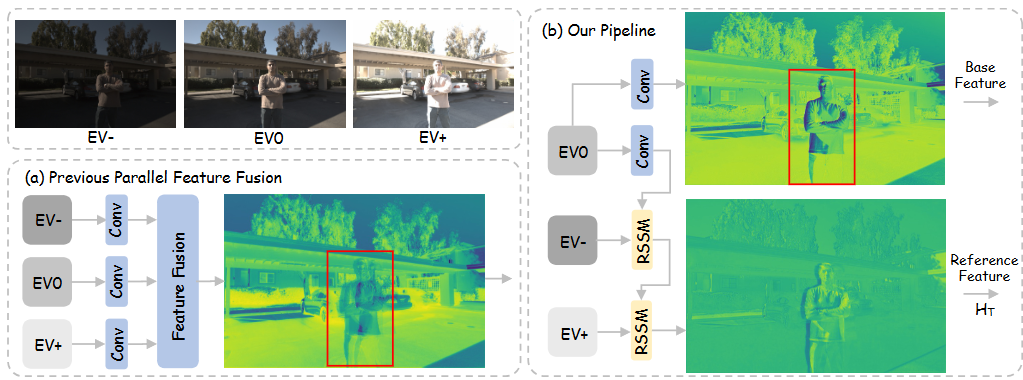
每一张图片都会被送入一个轻量级的特征提取模块中去。然后RSSM就会把当前时刻的特征和上一个时刻的隐藏状态做可变形对齐,并且用Attentive State-Space Equation来建模出长距离的空间-序列的关系。这里的隐藏状态并不是简单的累加,而是通过门控的方式来更新的:有多少信息要保留下来,又有多少信息需要被加入进来,这一切都是由网络根据具体内容来决定的。因此2 帧、3 帧或者 5 帧的区别只在于循环次数的不同,并没有改变模型本身的结构。
式(8):门控地把当前的曝光信息存到全局隐藏的状态中去。
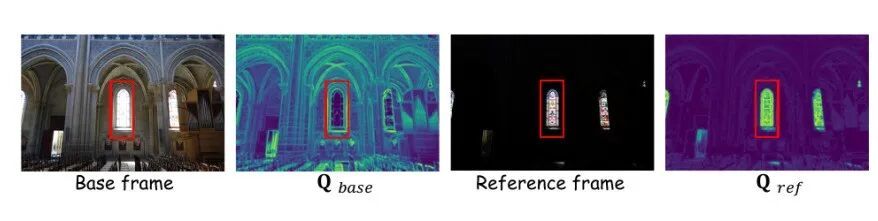
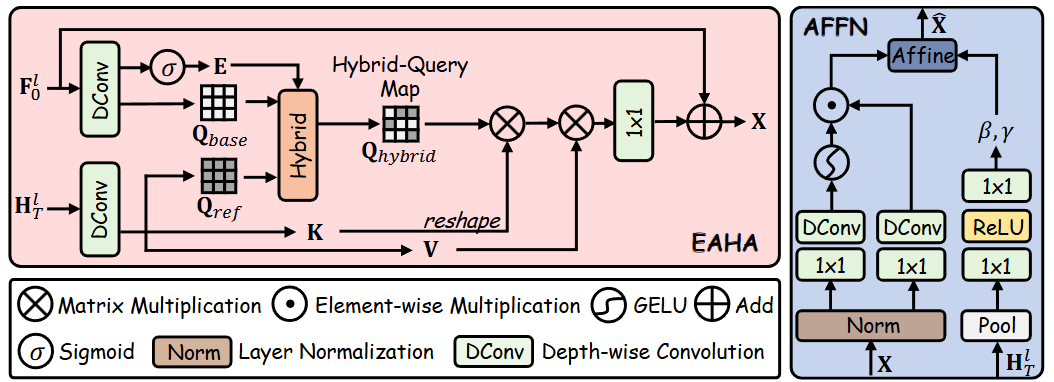
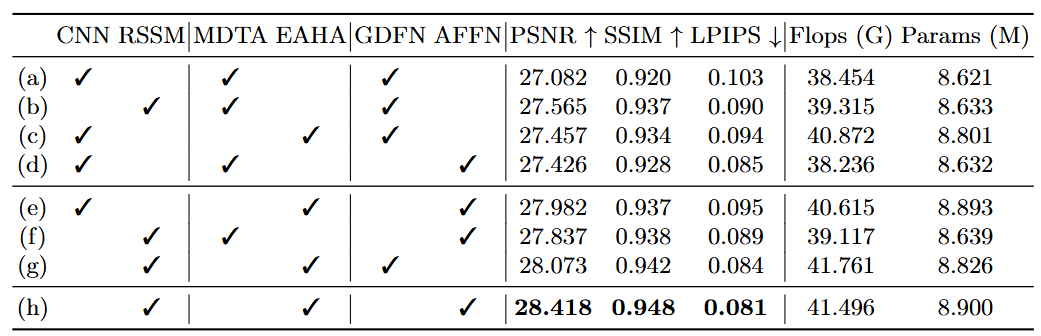
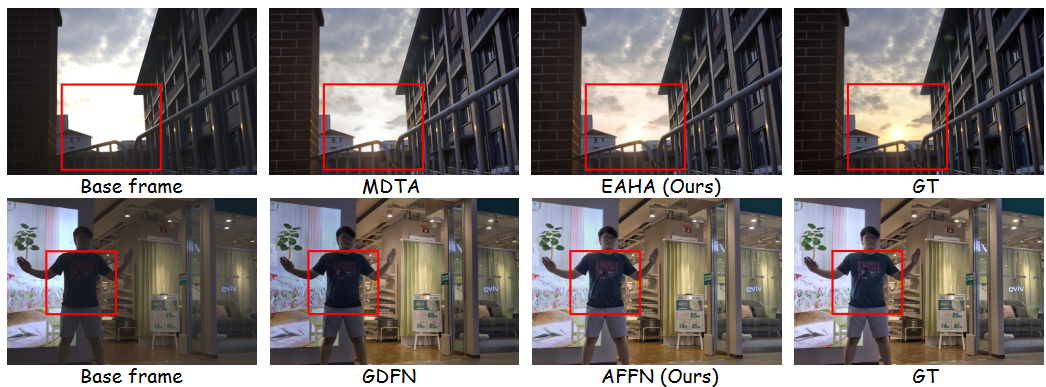
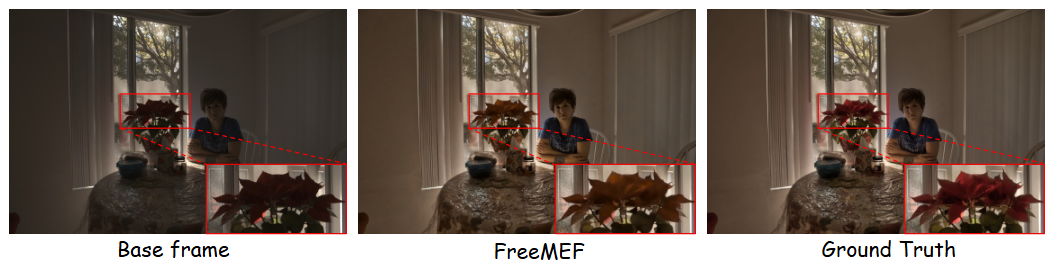
GFGB 中的 EAHA 同时有两个查询:一个是基准帧,用来保持正常的曝光区域的内容一致;另一个是全局参考状态,在基准帧过曝或者欠曝的时候作为备用检索入口。网络预测出极值图 E,并且对这两个查询做空间上的自适应混合。正常的区域用基准帧,饱和的地方就变成参考状态这样就可以防止最重要的地方没有参照依据了。
式(11):极值图E决定了每一个地方是更加信任基准查询还是参考查询。
除了把缺少的纹理“搬回来”之外,还需要解决LDR和目标融合图像在亮度、对比度上的差异问题。AFFN从全局参照的状态中抽取描述向量,并且推算出缩放参数γ和偏移参数β,然后对局部特征进行仿射调整。EAHA 选择去哪里获取资料,AFFN 选择如何恢复亮度和对比度。
式(13):全局曝光状态产生各个通道的尺寸和位移参数。
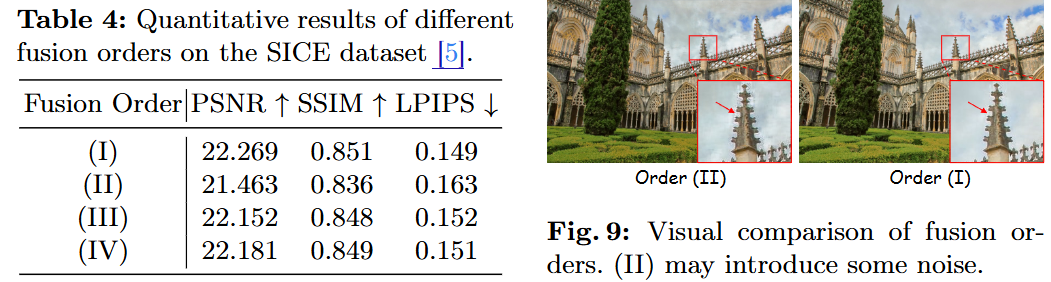
“去”的过程就是将各个曝光帧按照顺序写入RSSM中,从而得到一个不依赖于帧数的全局参考状态;而“回”的过程则是使该状态沿着GFGB回到基准帧,并在多层次的Transformer里逐渐恢复饱和区。先解耦基准特征和参考特征,然后选择性地进行融合防止并行早融合把运动错位直接写入到统一特征中去。