来源:机器地图
原文链接:https://mp.weixin.qq.com/s/kgvUksuwXiQ4p-4jjAD8jA
标题:The Sword, Shield, and Achilles’ Heel: Characterizing the Linguistic Inductive Bias of Large Language Models for Spatial Reasoning in Navigation Planning
作者:Xudong Zhang, Jian Yang, Shengkai Wang, Jiangpeng Tian, Shaowen Chen, Xian Wei, Ke Li, Xiong You
机构:华东师范大学,信息工程大学,郑州大学
刊物:IJCAI-ECAI 2026 (the 35th International Joint Conference on Artificial Intelligence)
链接:https://arxiv.org/abs/2605.31404
关键词:大型语言模型;语言归纳偏置;空间推理;导航规划;认知地图;表征干预;上下文干预
论文聚焦大语言模型(LLM)用于导航规划时的语言归纳偏置问题。现有导航系统将空间结构转为文本供模型推理,但语言形式、特征选取带来的偏置常被忽视。为此提出双干预实验框架,从表征和上下文两个维度开展对照实验:表征干预探究语言格式、文本压缩的影响,上下文干预分析不同空间线索的偏好与冲突问题。大量实验结论:拓扑信息是导航规划的核心支撑,稳定性最强;语言表达形式利弊并存,效果受模型规模、任务类型、压缩程度共同影响;语义信息是明显短板,语义错误或歧义会严重扰乱规划逻辑。研究据此给出工程设计准则:构建面向LLM导航的文本空间表征时,需保证拓扑完整、按需控制文本压缩、严格保障语义准确。论文同时开源了相关代码。(https://github.com/jonesdong150/LLM-Navigation-Inductive-Bias)
01 研究背景
空间智能是具身人工智能的核心能力,导航任务对此尤为依赖。导航智能体需要根据目标主动规划行进路径,而非单纯依靠被动避障完成移动。近年来,大语言模型被广泛用作高层导航规划器,依托符号化空间表征进行推理,并输出导航子目标。现有主流系统均采用分层架构:大语言模型基于拓扑图、语义地图等显式空间输入制定高层导航决策,底层控制器则负责执行具体动作。
尽管相关技术发展迅速,但一个核心问题仍未得到充分探究:序列化空间输入所采用的语言表征形式,会如何影响大语言模型的导航推理行为?以往研究大多将空间表征转文本视为常规工程步骤,仅用其辅助规划,并未系统性分析语言结构与上下文线索对推理结果造成的影响。从大语言模型的原理来看,基于Transformer架构的模型以词序列为推理载体,依靠注意力机制筛选并整合长文本中的有效信息。平铺式描述、层级化分组、聚类化表征等不同语言组织形式,会形成截然不同的注意力分布与信息权重。同时,各类空间线索与序列处理逻辑的适配性也存在差异:拓扑连通性这类信息天然契合序列处理模式,而基于坐标的几何描述则不然。即便底层空间信息完全一致,表征形式的差异也会让导航推理产生系统性偏置。认知地图理论为本研究提供了研究思路。空间认知领域的研究指出,人类导航会综合运用多类空间信息,且层级化、聚类化是空间知识组织的基本特征。本文并非将生物认知机制照搬至大语言模型,而是借鉴该理论思想,对语言结构、上下文线索的可调用性开展可控干预实验。
基于上述思路,本文设计了一套包含表征干预与上下文干预的可控实验框架。与以性能优化为核心的提示工程不同,本框架严格遵循信息等价原则:固定底层空间事实,仅系统性调整语言格式、压缩比例、上下文特征组合以及特征冲突。本文在五项空间推理任务中完成评测,将语言结构与上下文线索的影响相互解耦,挖掘模型隐藏的决策优先级与固有缺陷。
02 相关工作
1️⃣大语言模型导航中的显式空间表征
越来越多的研究将大语言模型作为导航系统的高层规划模块,把拓扑图、语义地图等环境信息转化为序列化文本。现有方法大多从工程角度出发,仅将文本描述当作单纯的信息载体。但相关实验结论并不统一:将占据栅格、层级地图等复杂空间结构转化为词序列时,会引入与Transformer预训练逻辑相悖的归纳偏置;在复杂场景下,这类问题甚至会导致大参数量模型的性能下降。
区别于这类以性能优化为目标的研究,本文将语言组织形式、上下文线索设定为独立实验变量,系统性分析不同表征方案对大语言模型导航推理的影响,而非单纯优化系统各项指标。
2️⃣认知地图
认知科学研究表明,人类导航依赖拓扑、几何、地标等多类空间信息,且这些信息会以层级、聚类的形式进行组织。近年来,人工智能领域常借用认知地图的概念探究大语言模型的世界建模能力,但多数研究仅停留在定性描述层面,未能将该理论转化为可落地的可控实验方案。因此,各类空间线索对导航推理的具体影响机制,目前尚不明确。
与之不同,本文将认知地图的核心原理落地为双干预实验框架。通过表征调整、上下文冲突探测等可操作变量,本文系统性分析了在语言驱动的导航任务中,大语言模型对各类空间线索的优先级排序、信息融合方式以及冲突处理逻辑。
03 研究方法
本文的核心研究是一套双干预实验框架(图1),整体分为表征干预和上下文干预两大模块,全程遵循信息等价原则,通过控制单一变量开展对照实验,系统探究大语言模型在导航规划中的语言归纳偏置。
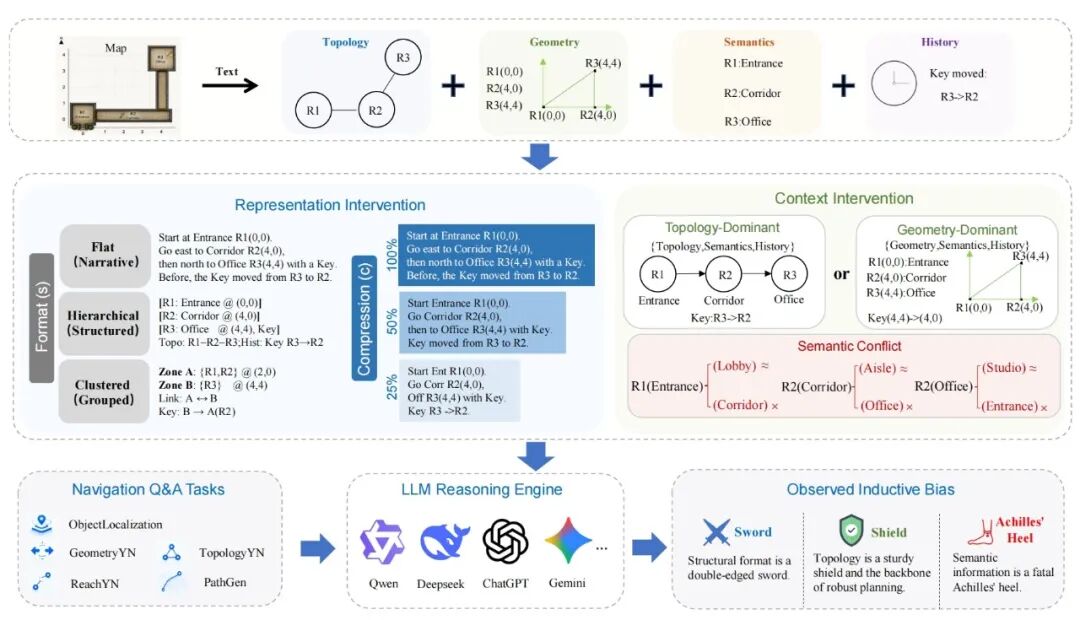
图1 统一框架概览
1️⃣表征干预
主要控制语言格式与文本压缩程度两大变量,该模块的表征转换关系由公式1定义:
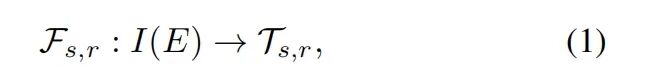
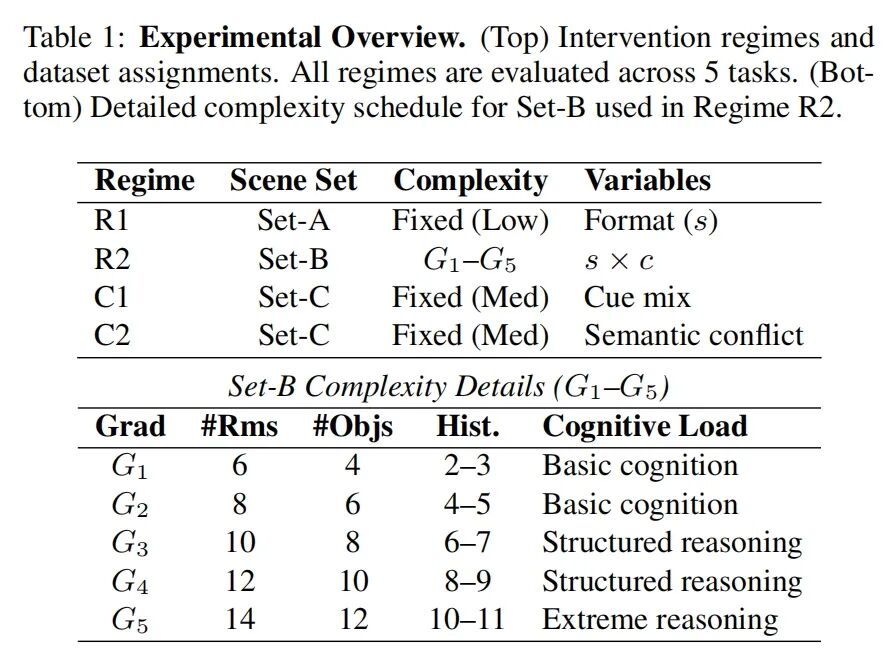
式中区分语言格式与信息保留率两类参数,且所有实验组的底层空间线索保持完全一致。首先开展语言格式干预,设置平铺式、层级式、聚类式三种文本组织形式,该实验记为R1,基于复杂度固定的数据集A进行验证,分析不同参数量模型对三种格式的适配效果。其次开展文本压缩干预,在每一种语言格式下分别设置100%、50%、25%三档信息保留率,对应完整文本、半精简文本与高度压缩的符号化文本,该实验记为R2,采用包含G1至G5五级复杂度梯度的数据集B,依次分析文本结构随场景复杂度的效果变化、不同场景对文本压缩的耐受能力,以及各类格式在不同导航任务中的适配性差异。
2️⃣上下文干预
研究将空间信息划分为拓扑、几何、语义、历史四类独立线索,从线索组合与线索语义冲突两个维度设计实验。第一组为上下文线索组合实验,记为C1,分别搭建拓扑主导、几何主导两种推理环境,为量化模型对两类线索的偏好程度,使用公式(2)计算线索主导分数
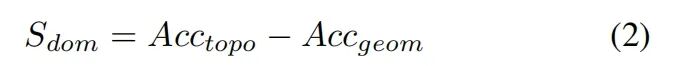
对比不同规模模型在两种场景下的准确率表现。第二组为语义冲突探测实验,记为C2,实验在拓扑主导的稳定场景中人为引入语义标签混淆,模拟真实应用中的感知混淆问题;为衡量语义错误造成的负面影响,定义公式(3) 作为语义短板指数。
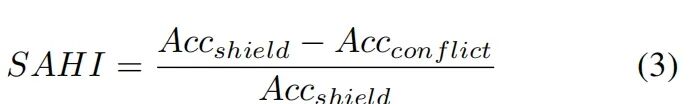
同时对比轻量、中端、高端三类模型受语义冲突影响的程度。
04 实验及结果
双干预实验共生成57500条测试样本,充足的样本规模可以排除随机误差,客观反映大语言模型导航推理的内在规律。
4.1场景数据集与导航任务
实验整体设置见表1。采用三套精心构建的合成场景数据集(A、B、C)。Matterport3D、Habitat等主流开源导航数据集虽拥有丰富的视觉场景,但标注信息并不完整,无法严格隔离实验变量,不满足本研究“信息等价、变量可控”的实验要求。而合成数据集可独立、同步地控制拓扑、几何、历史等所有维度,完美适配干预实验需求。
数据集A:包含10个低复杂度场景,用于语言格式干预实验。
数据集B:包含10个梯度复杂度场景(G1~G5),用于文本压缩干预实验。
数据集C:包含10个中等复杂度场景,专门用于上下文线索组合与冲突探测实验。
选取五项覆盖核心空间认知能力的导航任务开展评测:
物体定位:实体位置匹配;
几何关系判断:推理方位、相对位置等空间关系并验证正误;
拓扑连通判断:从线性文本中验证节点连通性;
可达性判断:多跳路径可达性分析;
路径生成:端到端序列路径规划。
4.2实验模型
实验选取不同参数量、不同部署形态的开源/闭源模型,覆盖全梯度模型能力,探究归纳偏置随模型规模的变化规律,同时为实际工程部署提供参考:
轻量部署型(≤40亿参数):适配端侧设备,包括通义千问3(0.6B、1.7B、4B)、Llama-3.2(1B、3B);
中端可用型(40亿~320亿参数):需搭配高性能边缘设备或轻量云服务器,包括Llama-3.1-8B、通义千问3-14B、通义千问3-32B;
高端能力型(超千亿参数):仅可通过接口调用的前沿模型,包括ChatGPT-5.2、Gemini-2.5。
所有实验均将温度系数设为0,保证实验结果可复现。
4.3 表征干预实验
R1组基于数据集A与图2完成语言格式测试,结果显示语言归纳偏置与模型规模强相关:轻量模型更适配层级式文本结构,该结构可充当推理支架、降低模型运算负担;随着参数量提升,层级结构的优势逐步消失,高端大模型更倾向于使用平铺式自然语言描述,而聚类式格式在全量级模型中表现均不佳,会割裂空间信息关联。
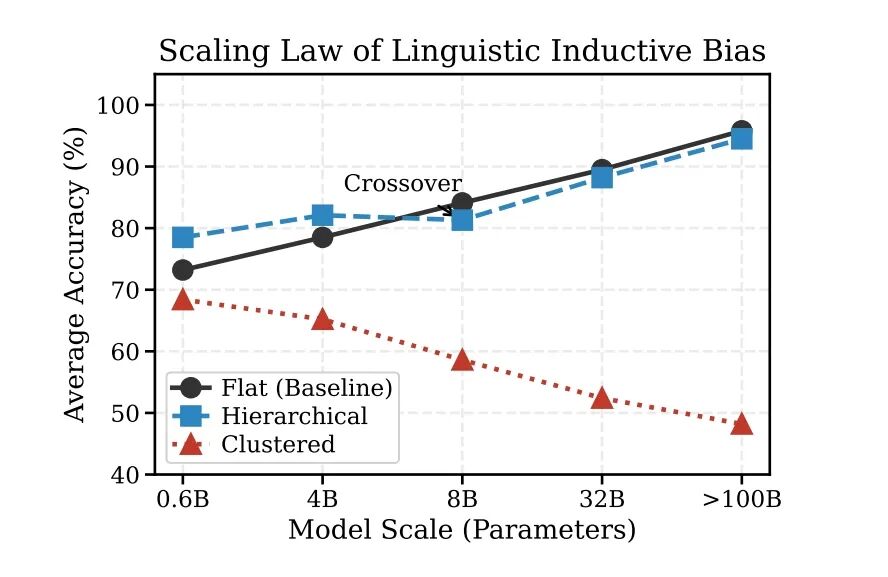
图2 语言归纳偏见(Set-A)的尺度行为
R2组基于数据集B、结合图3开展文本压缩与复杂度联合实验,图3三组子图分别呈现不同维度结论:在结构效果层面,轻量模型会随场景复杂度提升出现增益反转,简单环境下层级格式更优,复杂环境下层级结构会变成冗余开销,中高端模型则受格式影响极小;在压缩耐受度层面,简单场景对文本压缩不敏感,复杂场景存在临界阈值,当信息保留率低于50%时模型准确率会出现断崖式下跌;在任务适配层面,层级格式在拓扑连通、可达性任务中表现突出,平铺格式则更适合物体定位、几何关系判断类任务。
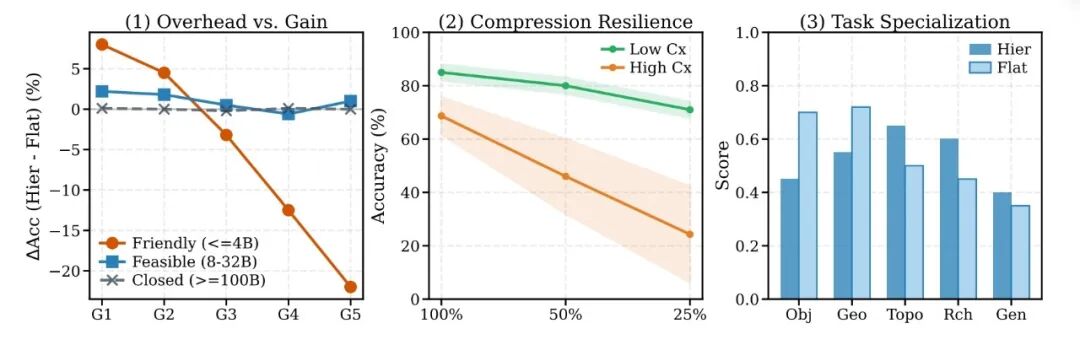
图3 复杂度依赖性边界与任务特异性效用(R2)
4.4 上下文干预实验
C1组线索组合实验分析模型偏好(图4),数据表明所有量级的模型均显著偏向拓扑线索,主导分数稳定在0.22至0.32区间,证明拓扑结构是大语言模型导航推理的核心支柱,模型处理离散连通关系的能力远优于隐式坐标计算。C2组语义冲突实验引入人为构造的语义标签混淆,模拟真实场景中的感知混淆问题,并通过语义短板指数与图5量化性能损失。实验结果证实,语义歧义能够破坏拓扑结构的稳定性,其中4B~32B的中端模型受影响最为严重,语义短板指数约为0.24,平均准确率下降超21%,出现语义与逻辑相脱离的问题,充分证明语义信息是大语言模型空间推理的致命短板。
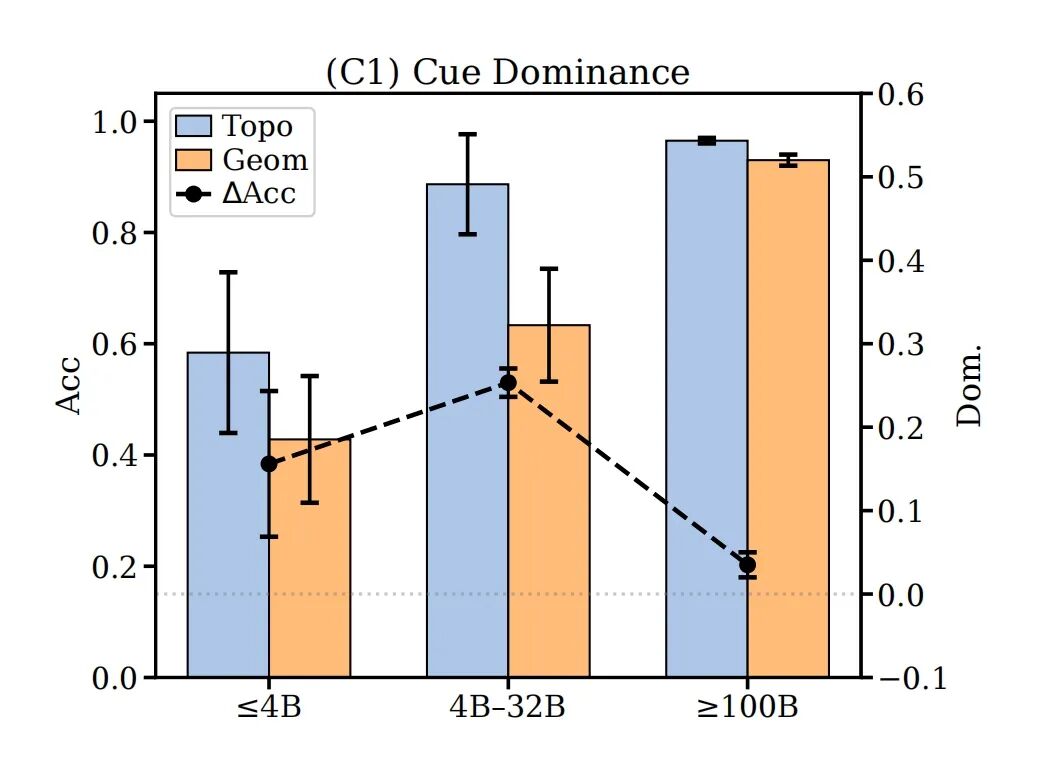
图4在信息充足条件下线索优势(C1,分层显示)
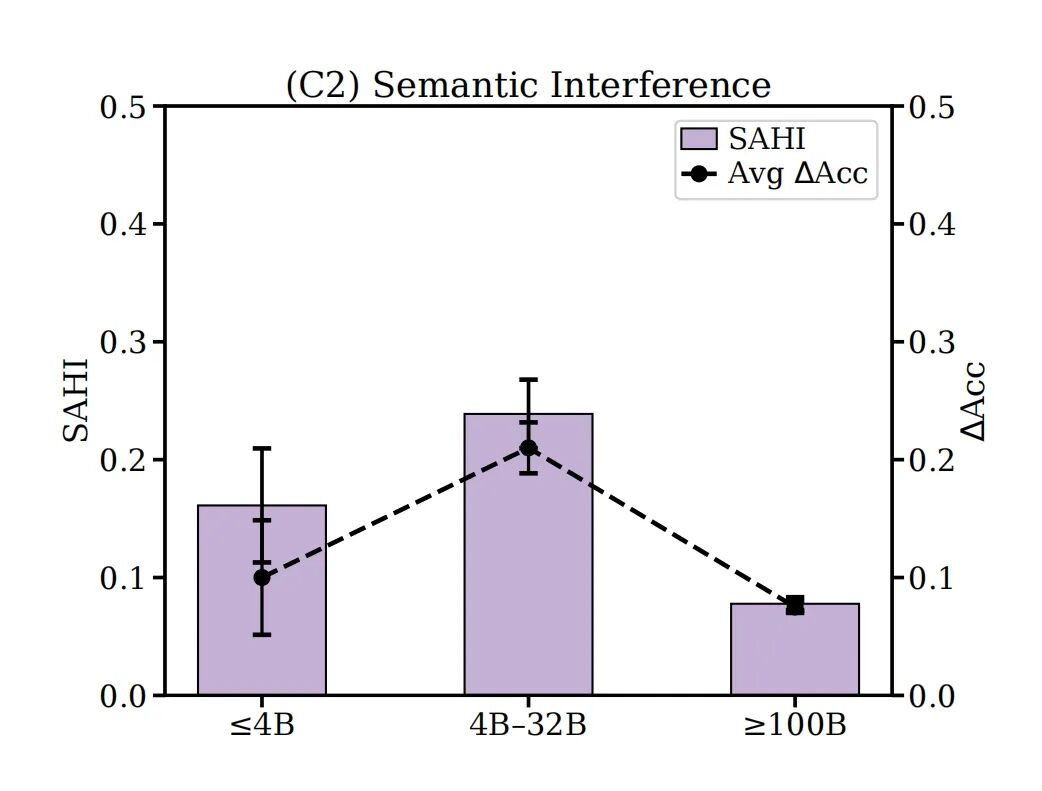
图5线索冲突下的语义脆弱性(C2,分层级分析)
05 结论
论文归纳出大语言模型在导航空间推理中存在三大典型语言归纳偏置。其一为语言结构带来的差异化影响即“利剑”效应:显式层级结构对端侧轻量模型能够起到辅助支撑作用,但在高压缩、高复杂度的空间场景中,层级结构会转变为冗余负担,且该结构的优劣会随模型规模发生明显反转,聚类格式则始终不适用于导航场景的空间表征。其二是拓扑信息具备极强稳定性,即“坚盾”特性:无论模型参数量大小,拓扑连通关系都是导航规划最核心、最可靠的推理依据,模型对拓扑线索的偏好远高于几何坐标类线索。其三是语义模糊性即“阿喀琉斯之踵-短板”:语义歧义、标签重复等问题会突破拓扑结构的防护,扰乱全局路径规划,其中中端模型受语义干扰的负面影响最为突出。
基于上述结论,针对性提出工程落地规范:将拓扑完整性作为空间表征设计的首要约束条件;结合模型性能与场景复杂度灵活设置文本压缩比例;根据部署环境与任务类型选用适配的语言格式;把语义准确性、语义消歧作为硬性要求,以此规避模型推理失效的风险。所有实验均在可控合成环境中完成,未来可将这套干预框架拓展至含感知噪声、标注不全的真实导航数据集,进一步验证相关归纳偏置在实际具身场景中的有效性。