


来源:机器人操作前沿动态
原文链接:https://mp\.weixin\.qq\.com/s/n\_qdyW9lyJ8FN34zy6ymow
机器人抓取与操作相关的研究,arXiv本周后公开约24篇,涉及基础模型(8篇)、操作学习(7篇)、感知与操作(2篇)、控制与规划(3篇)、可变形体操作(1篇)、移动操作(1篇)、交互与协作(1篇)、硬件与系统(1篇)。
一、基础模型(8篇)
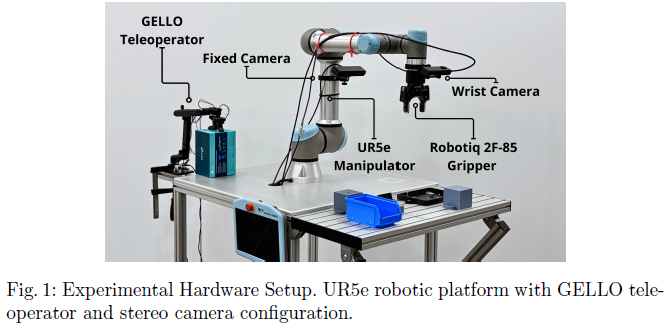
1 On the Efficiency of LoRA Fine-Tuning for Vision-Language-Action Models in Industrial Robotic Manipulation
中文标题:视觉-语言-动作模型在工业机器人操作中LoRA微调的效率研究
作者机构:Finn Ferchau, et al. Technische Hochschule Nürnberg Georg Simon Ohm, etc.
论文地址:https://arxiv\.org/pdf/2607\.10172
项目地址:https://github\.com/F\-Fer/lerobot\_ur5e\_gello
论文贡献:系统研究LoRA在π0 VLA上的微调效果,发现r=32性能饱和且与全量微调无显著差异,VRAM降至10.8 GiB。
未来工作:仅在单一机器人平台和单一VLA架构上验证,泛化性需进一步研究;LoRA缩放约定可能导致大rank下梯度坍缩,未来需评估rsLoRA等秩稳定缩放方法。
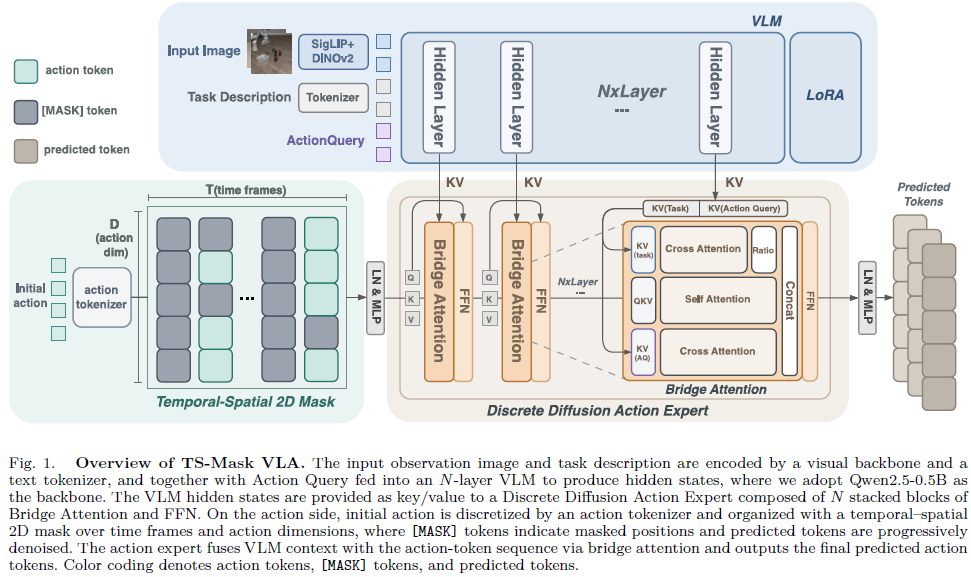
2 TS-Mask VLA: 2D Temporal–Spatial Masking for Vision-Language-Action Model with Effective Bridging
中文标题:TS-Mask VLA:面向视觉-语言-动作模型的二维时空掩码与有效桥接
作者机构:Shengzhuo Yang, et al. Zhejiang University, etc.
论文地址:https://arxiv\.org/pdf/2607\.09818
论文贡献:提出TS-Mask VLA框架,引入离散扩散动作专家与二维时空掩码策略,以0.5B参数在LIBERO实现95.7%成功率。
未来工作:仅在资源受限场景下验证,未充分探索充足训练资源下的性能上限;未来将研究在丰富训练资源条件下的表现。
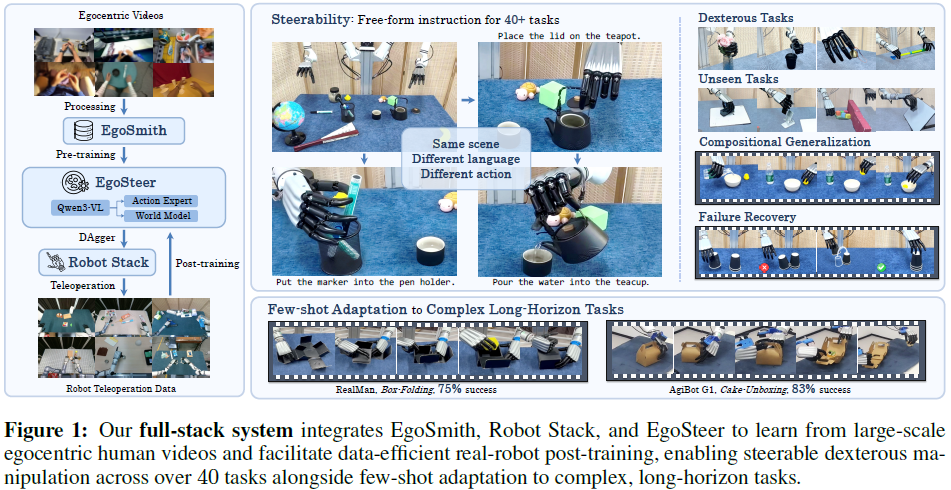
3 EgoSteer: A Full-Stack System Towards Steerable Dexterous Manipulation from Egocentric Videos
中文标题:EgoSteer:面向可操控灵巧操作的自我中心视频全栈系统
作者机构:Yifan Zhong, et al. Institute for AI, PKU, etc.
论文地址:https://arxiv\.org/pdf/2607\.09701
项目地址:https://egosteer\.github\.io
论文贡献:提出全栈可操控灵巧操作系统,集成EgoSmith数据管线(9.6K小时)和世界模型增强VLA,在40+任务上实现75%成功率。
未来工作:机器人自由度限制阻碍高灵巧人类知识迁移,缺乏触觉反馈限制接触丰富任务性能,预训练规模可进一步扩展;未来将解决这些瓶颈以支持更广泛的任务泛化。
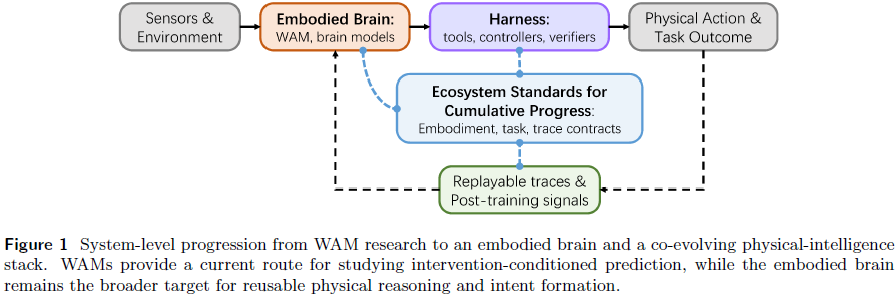
4 From World Action Models to Embodied Brains: A Roadmap for Open-World Physical Intelligence
中文标题:从世界动作模型到具身大脑:开放世界物理智能路线图
作者机构:Yuanzhi Liang, et al. Institute of Artificial Intelligence (TeleAI), China Telecom, etc.
论文地址:https://arxiv\.org/pdf/2607\.11689
论文贡献:提出从世界动作模型到具身大脑的协同演进路线图,通过预测契约和物理智能栈接口解决模型表征、标准化和系统层面的三大耦合鸿沟。
未来工作:核心局限在于动作输出仅相对特定具身和控制器有意义,预测接口暴露不同后果变量;未来需验证模块化接口在跨具身适应性中的实际有效性。
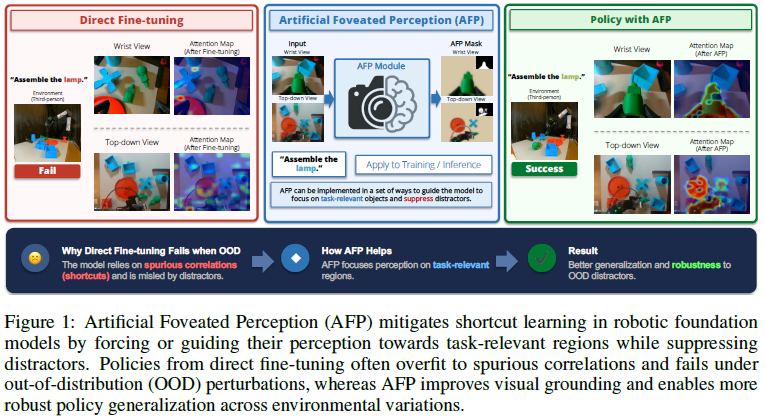
5 Artificial Foveated Perception for Mitigating Shortcut Learning in Robotic Foundation Models
中文标题:用于缓解机器人基础模型快捷学习的人工注视感知
作者机构:Xiatao Sun, et al. Yale University, etc.
论文地址:https://arxiv\.org/pdf/2607\.10655
论文贡献:提出人工注视感知(AFP)模块,通过任务条件化掩码引导策略视觉注意力到任务相关区域,减少快捷学习,提升微调效率和泛化鲁棒性。
未来工作:主要依赖任务相关性标注,标注成本高且可能有偏;未来可通过扩展数据集或开发自监督接地目标来缓解。
6 Towards Predictive, Aligned, and Scalable Robot Learning
中文标题:迈向预测性、对齐和可扩展的机器人学习
作者机构:Astribot Team. Astribot, etc.
论文地址:https://arxiv\.org/pdf/2607\.11270
项目地址:https://www\.astribot\.com/research/Lumo2
论文贡献:提出Lumo-2潜在世界-动作模型,通过多阶段模态预对齐策略将动作表征与潜在世界动力学、视觉和语言逐步对齐,实现预测推理和可扩展机器人学习。
未来工作:自回归推理速度是主要瓶颈,实时控制受限;潜在世界动力学的可解释性和跨具身泛化能力有待进一步验证。
7 FlowWAM: Optical Flow as a Unified Action Representation for World Action Models
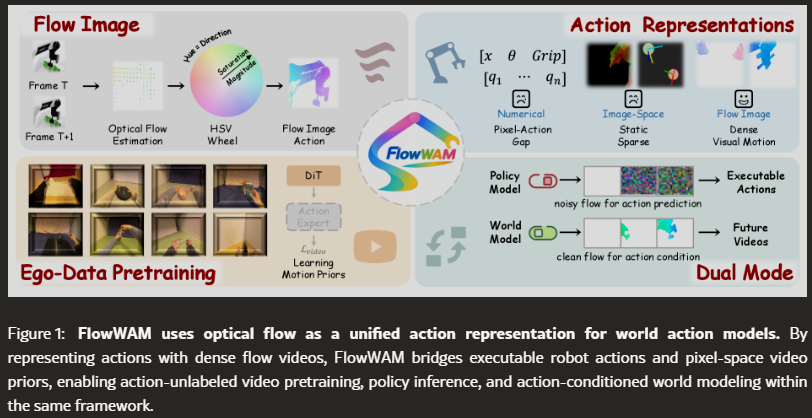
中文标题:FlowWAM:以光流作为世界动作模型统一动作表示的方法
作者机构:Yixiang Chen, et al. Institute of Automation, Chinese Academy of Sciences, etc.
论文地址:https://arxiv\.org/html/2607\.13017
项目地址:https://flow\-wam\.github\.io/
论文贡献:首次提出以光流作为世界动作模型的统一动作表示,通过双流扩散框架联合建模RGB与光流视频,同时实现动作预测和世界建模。
未来工作:当前无动作预训练数据规模有限且规划时间跨度较短,未来将扩展到互联网规模数据集并延长基于光流的规划时间跨度。
8 ExToken: Structured Exploration for Efficient Vision-Language-Action Reinforcement Fine-tuning
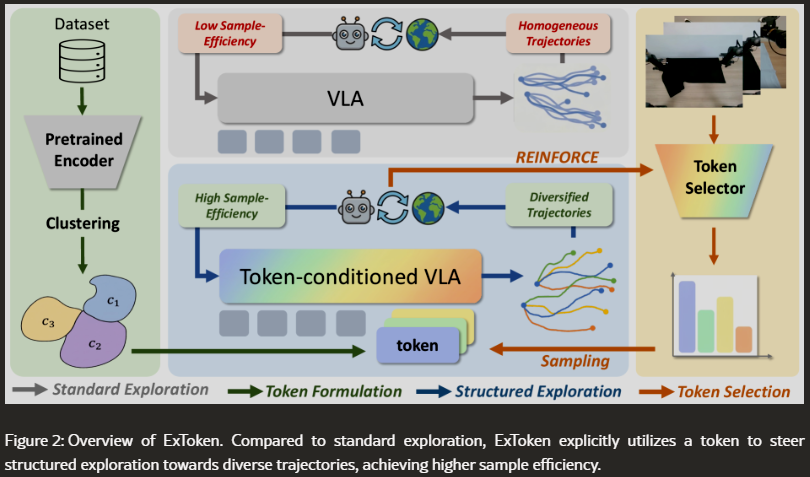
中文标题:ExToken:面向高效视觉-语言-动作强化微调的结构化探索方法
作者机构:Yilun Kong, et al. Nanyang Technological University, etc.
论文地址:https://arxiv\.org/html/2607\.12931
论文贡献:提出ExToken框架,通过离散行为先验token条件化VLA策略实现结构化探索,结合状态条件token选择器弥合训练探索与部署推理差距,显著加速策略收敛。
未来工作:当前token利用方式较简化且仅适用于短程任务,未来将token与策略联合优化并扩展到长时程任务的时间条件化token。
二、操作学习(7篇)
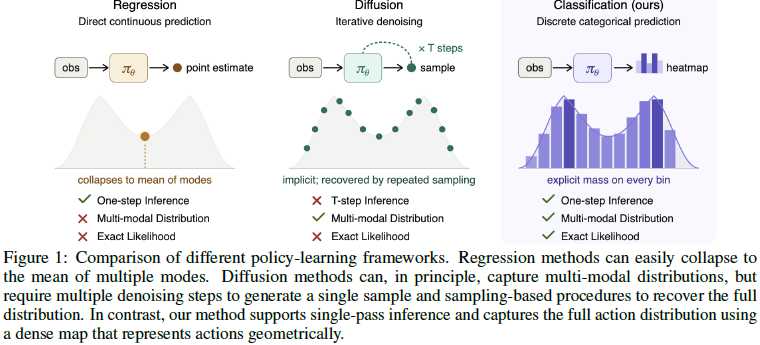
1 Action Map Policy: Learning 3D Closed-loop Manipulation via Pixel Classification
中文标题:动作图策略:通过像素分类学习三维闭环操作
作者机构:Haojie Huang, et al. Northeastern University, etc.
论文地址:https://arxiv\.org/pdf/2607\.10706
项目地址:https://haojhuang\.github\.io/amp
论文贡献:提出AMP框架将三维闭环操作学习转化为像素分类问题,单次前向推理生成动作块,在多项任务上超越基线。
未来工作:生成的动作存在轻微抖动,工作空间受限于相机标定覆盖范围;未来可通过几何一致性损失、更大视野相机和扩展至灵巧手设置来改进。
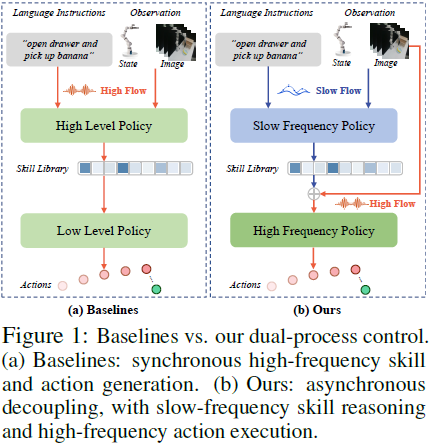
2 Dual-Process Atomic Skill Learning: Decoupling Semantic Reasoning and Real-Time Control
中文标题:双过程原子技能学习:解耦语义推理与实时控制
作者机构:Jun Chen, et al. University of Electronic Science and Technology of China, etc.
论文地址:https://arxiv\.org/pdf/2607\.10625
项目地址:https://github\.com/Hatakekaka/DASL
论文贡献:提出异步分层模仿学习框架DASL,解耦慢频语义推理与高频运动控制,显著提升组合泛化能力。
未来工作:当前依赖离线演示数据,无法通过在线交互自适应;未来将探索强化学习在线微调并集成大规模视觉语言基础模型。
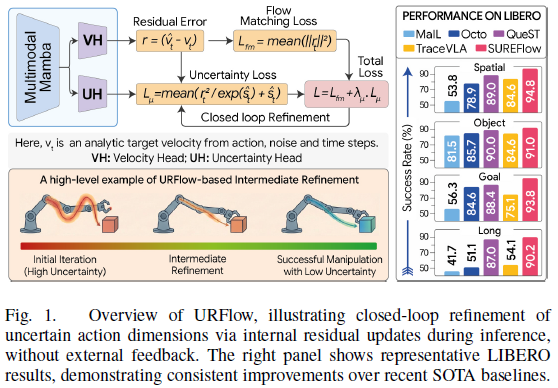
3 SUREFlow: State-space Uncertainty-aware REsidual Flow Matching for Robust Robot Manipulation
中文标题:SUREFlow:面向鲁棒机器人操作的状态空间不确定性感知残差流匹配
作者机构:Md Tanvir Islam, et al. Kyungpook National University, etc.
论文地址:https://arxiv\.org/pdf/2607\.10504
项目地址:https://github\.com/tanvirnwu/SUREFlow
论文贡献:提出基于Mamba的不确定性感知残差流匹配框架SUREFlow,以179M参数在LIBERO上实现92.5%成功率。
未来工作:真实世界实验仅限于单一桌面杯匹配任务,不确定性权重需精细调校且精炼步数超过3步后无增益;未来可扩展至更多样化的真实操作场景。
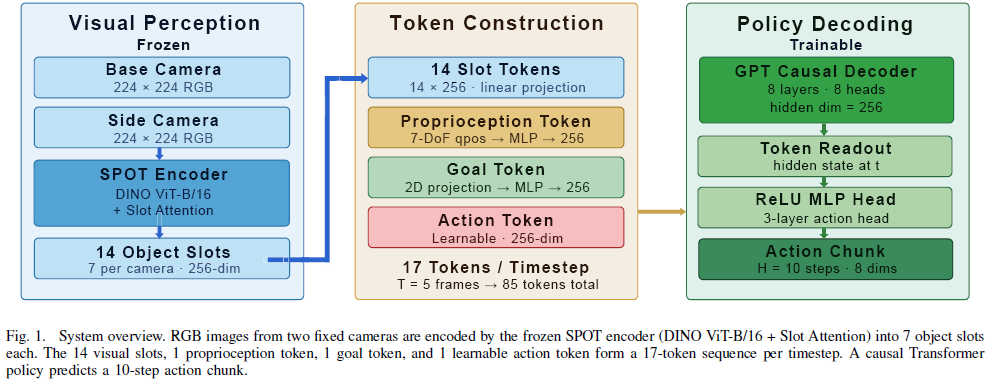
4 More Structure, Not More Capacity: Object-Centric Representations for Visuomotor Imitation Learning
中文标题:更多结构而非更多容量:面向视觉运动模仿学习的以对象为中心的表征
作者机构:Yi Li, et al. TU Darmstadt, etc.
论文地址:https://arxiv\.org/pdf/2607\.09825
论文贡献:在匹配条件下比较三种视觉表征,发现对象中心SPOT表征比稠密DINO高22.4%成功率,并引入运动学失败分类法。
未来工作:SPOT缺乏时序槽位记忆导致遮挡恢复失败,融合比较未在接地条件下运行,表征比较使用近似标定;未来将探索槽位掩码目标接地和时序槽位一致性。
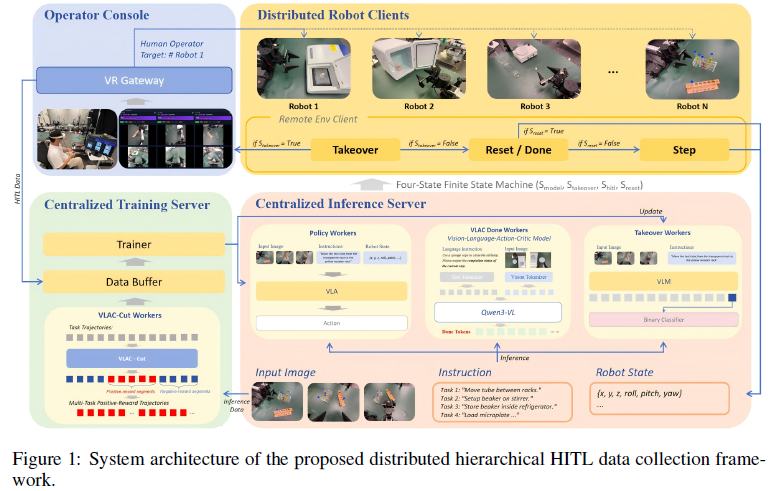
5 Maximizing Human Efficiency in Large-Scale Robot Post-Training via VLAC-CUT Guided Pipeline
中文标题:通过VLAC-CUT引导流水线最大化大规模机器人后训练中的人类效率
作者机构:Shaopeng Zhai, et al. Shanghai AI Lab, etc.
论文地址:https://arxiv\.org/pdf/2607\.09776
论文贡献:提出以人效为核心的VLA后训练流水线,通过VLAC-CUT自动分割自主轨迹并复用有效片段,在相同人工预算下成功率达80%至95%、吞吐量提升1.7倍至4.2倍。
未来工作:仅在四个任务上验证,冰箱任务受相机视角和机械结构限制饱和于80%;流水线扩展到更多任务和具身形态有待验证。
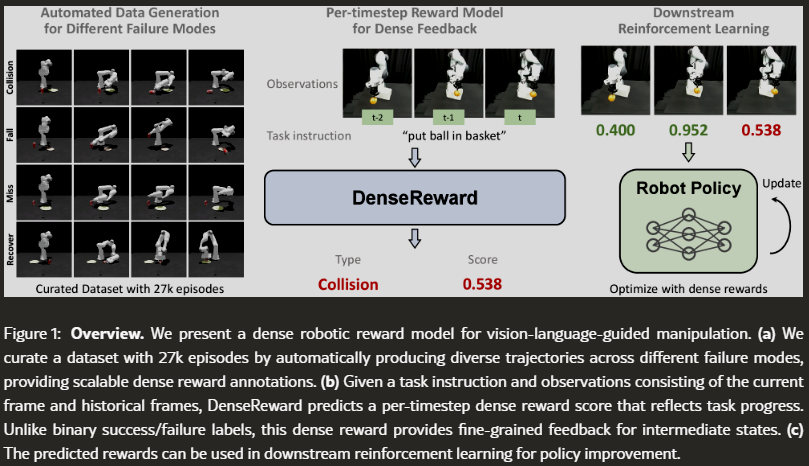
6 DenseReward: Dense Reward Learning via Failure Synthesis for Robotic Manipulation
中文标题:DenseReward:通过失败合成学习密集奖励的机器人操作方法
作者机构:Yu Fang, et al. University of North Carolina at Chapel Hill, etc.
论文地址:https://arxiv\.org/html/2607\.13033
项目地址:https://dense\-reward\.github\.io/
论文贡献:提出DenseReward密集奖励模型,通过自动化失败轨迹合成管线生成六种物理真实失败模式并标注帧级密集奖励,为MPC和RL提供有效奖励引导。
未来工作:当前仅验证有限任务类型,未来计划扩展到工具使用和长时程任务,并整合人类偏好反馈以提升奖励模型通用性。
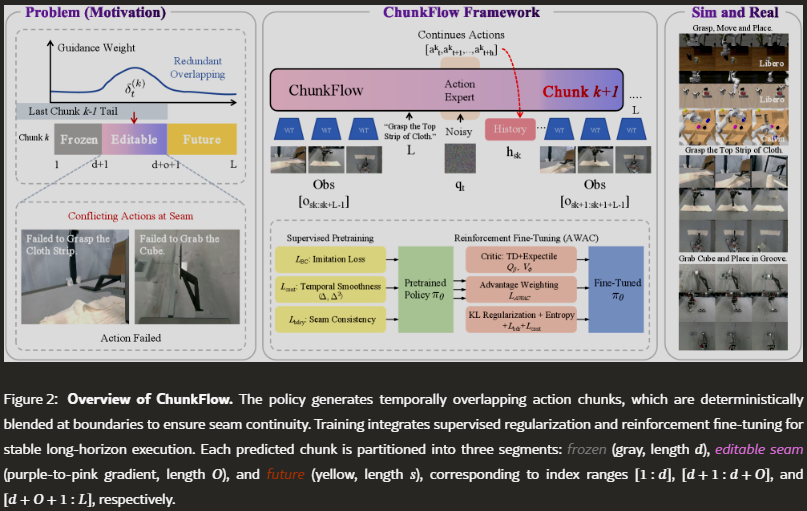
7 ChunkFlow: Towards Continuity-Consistent Chunked Policy Learning
中文标题:ChunkFlow:面向连续性一致的分块策略学习
作者机构:Zhao Yang, et al. Xi'an Jiaotong University, etc.
论文地址:https://arxiv\.org/html/2607\.12992
项目地址:https://cytoderm\-ai\.github\.io/chunkflow
论文贡献:提出面向分块策略的接缝感知训练框架ChunkFlow,通过冻结-可编辑-未来三分区结构和连续性正则化消除块边界抖动,在CALVIN和LIBERO上实现高成功率和低延迟。
未来工作:当前仅在仿真和初步硬件测试中验证,更广泛的真实世界鲁棒性仍待探索;训练计算成本较高且真实机器人任务类型有限。
三、感知与操作(2篇)
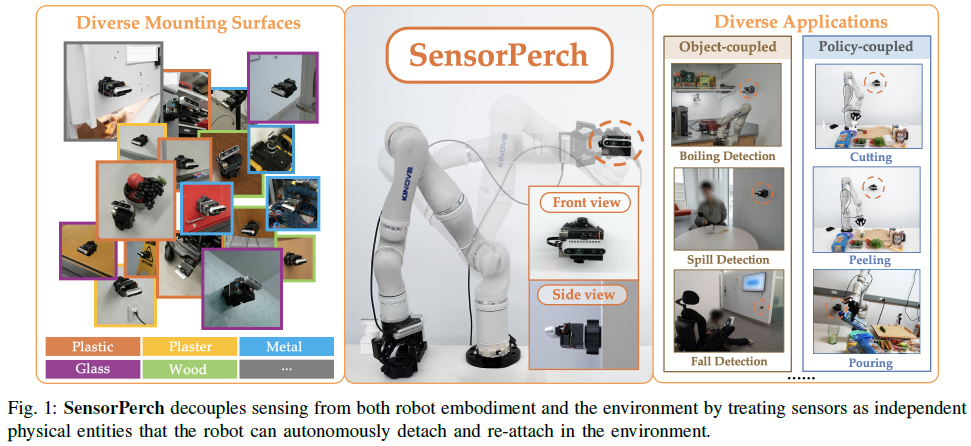
1 SensorPerch: Sense Wherever and Whenever it Matters
中文标题:SensorPerch:在需要时和需要处感知
作者机构:Zhanxin Wu, et al. Cornell University, etc.
论文地址:https://arxiv\.org/pdf/2607\.10682
论文贡献:提出SensorPerch——将传感器作为独立物理实体由机器人自主拆卸和重安装的主动感知范式,实现任务最优视角的按需构建。
未来工作:依赖可附着表面和真空吸附可靠性,多孔或柔软材料上受限;未显式建模机器人运动对遮挡和视角质量的影响。
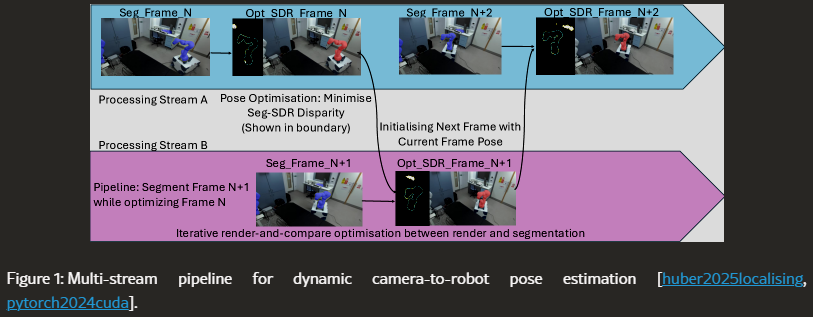
2 Streamlining stereo differentiable rendering for marker-free real-time tracking of surgical robots
中文标题:面向手术机器人无标记实时跟踪的立体可微渲染优化方法
作者机构:Yanghe Hao, et al. King's College London, etc.
论文地址:https://arxiv\.org/html/2607\.12604
项目地址:https://github\.com/lbr\-stack/roboreg
论文贡献:通过CUDA多流并行化扩展立体可微渲染框架roboreg,实现手术机器人30fps实时无标记姿态跟踪,精度接近1cm并优于FoundationPose基线。
未来工作:当前依赖分割精度且需已知初始位姿,仅在单一平台验证;未来将采集更高帧率数据并扩展到多机器人和更多平台。
四、控制与规划(3篇)
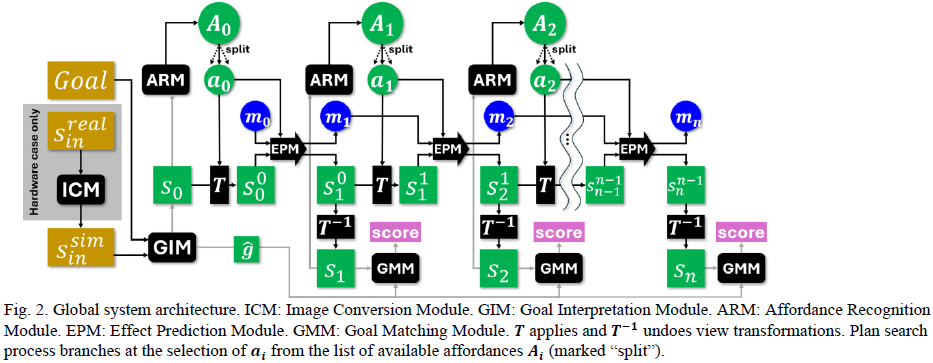
1 Affordance-Based Manipulation Planning with Text Goals and Sim-to-Real Generalisation via Real-to-Sim Image Conversion
中文标题:基于可供性的文本目标操作规划与通过实到虚图像转换的仿真到现实泛化
作者机构:Solvi Arnold, et al. NICT, etc.
论文地址:https://arxiv\.org/pdf/2607\.11004
论文贡献:提出基于可供性识别与效果预测的操作规划系统,支持文本目标定义和实到虚图像转换实现仿真到现实泛化。
未来工作:各模块分别训练导致级联误差累积,规划速度较慢(每任务数十秒至数分钟);未来可通过联合训练各模块提升精度并优化规划效率。
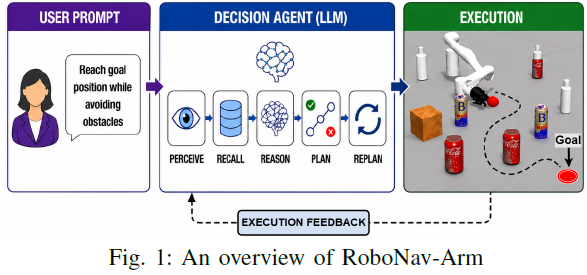
2 RoboNav-Arm: Agentic AI-Driven Navigation and Obstacle Avoidance for Robotic Manipulator in Cluttered Environments
中文标题:RoboNav-Arm:面向杂乱环境中机械臂的智能体AI驱动导航与避障
作者机构:Aachal Sharma, et al. Indian Institute of Technology Mandi, etc.
论文地址:https://arxiv\.org/pdf/2607\.09716
论文贡献:提出端到端智能体AI框架RoboNav-Arm,集成环境感知、自适应规划器选择和安全感知轨迹执行,在仿真中验证鲁棒性。
未来工作:仅在Gazebo仿真中验证且未处理动态运动障碍物;未来将聚焦动态障碍物处理、实时重规划改进和真实世界部署。
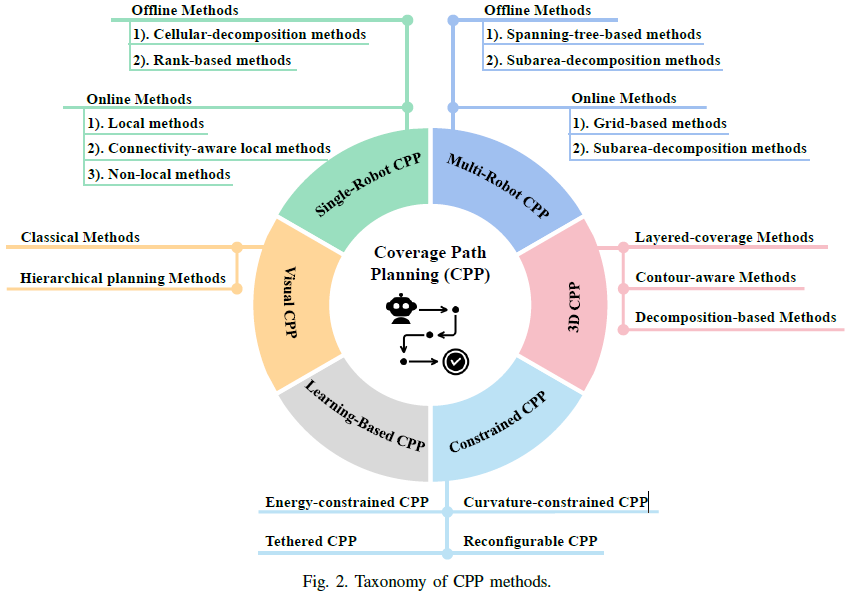
3 Coverage Path Planning: Classical Foundations, Recent Advances, and Future Directions
中文标题:覆盖路径规划:经典基础、最新进展与未来方向
作者机构:Zongyuan Shen, et al. College of Information Science and Technology, Jinan University, etc.
论文地址:https://arxiv\.org/pdf/2607\.10649
论文贡献:综述125篇代表性工作,将覆盖路径规划分为六大类别系统梳理,连接经典方法与2015至2026年最新进展。
未来工作:在线3D和视觉CPP需从噪声不完整传感器在线重建几何;异构多机器人团队和受限通信下的CPP有待探索。
五、可变形体操作(1篇)
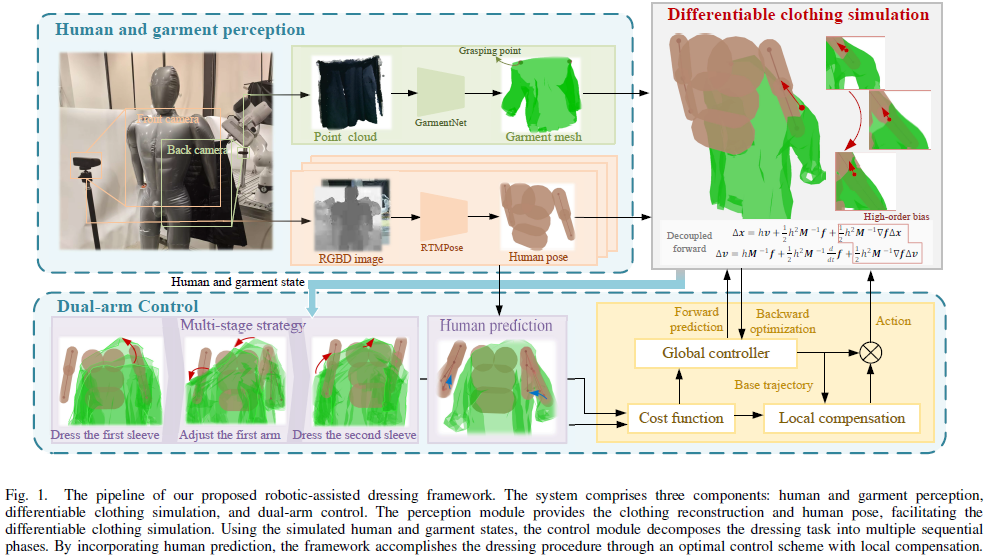
1 Dual-Arm Robot-Assisted Dressing with Differentiable Clothing Simulation
中文标题:基于可微分布料仿真的双臂机器人辅助穿衣
作者机构:Yiming Liu, et al. Shanghai Jiao Tong University, etc.
论文地址:https://arxiv\.org/pdf/2607\.10999
论文贡献:提出实时可微分布料仿真算法与多阶段控制策略,实现大时间步稳定仿真并成功完成双袖穿衣辅助任务。
未来工作:当前方法在处理布料自碰撞方面存在局限,高阶偏置引入的能量耗散使其不适用于高动态场景;未来将扩展模型适用范围以支持更通用的布料操作。
六、移动操作(1篇)
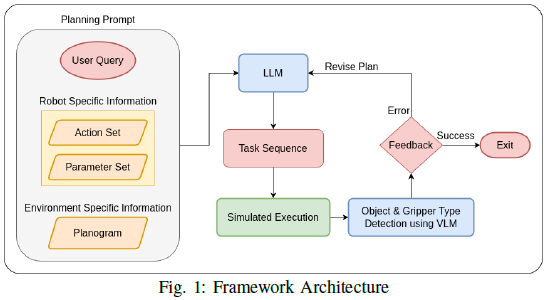
1 Task Planning for Mobile Manipulation in Retail Stores using Foundation Models with Iterative Re-planning
中文标题:基于基础模型与迭代重规划的零售店移动操作任务规划
作者机构:Vismay Vakharia, et al. Tata Consultancy Services Ltd., etc.
论文地址:https://arxiv\.org/pdf/2607\.09962
论文贡献:提出结合LLM和VLM的任务规划框架,通过执行反馈迭代重规划解决零售场景补货问题。
未来工作:仅在PyBullet仿真环境验证,缺乏真实世界部署;系统需多次重规划修正错误,未来可扩展至真实零售场景并优化单次规划成功率。
七、交互与协作(1篇)
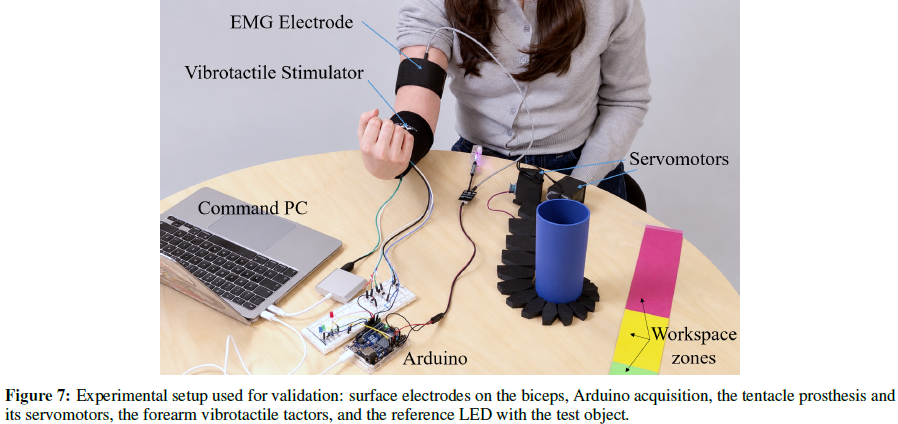
1 A Biomimetic Myoelectric Tentacle Prosthesis with Sensorless Object Detection and Vibrotactile Feedback
中文标题:仿生肌电触手假肢:无传感器物体检测与振动触觉反馈
作者机构:Gabrielle Marion, et al. Polytechnique Montréal, etc.
论文地址:https://arxiv\.org/pdf/2607\.09807
论文贡献:设计肌电触手形假肢,集成EMG控制、无传感器物体检测和振动触觉反馈,实现77ms响应和90%以上检测成功率。
未来工作:无传感器检测对轻物体敏感度不足,MVC归一化对特定人群不适用,振动触觉空间分辨率差;未来将探索次极大收缩归一化、集成外部传感器和优化反馈时序。
八、硬件与系统(1篇)
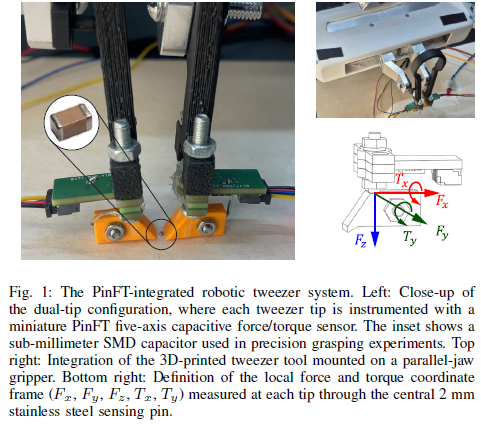
1 PinFT: Miniature 5-Axis Force/Torque Sensor Embeddable to Tweezer-like Tool
中文标题:PinFT:可嵌入镊子式工具的微型五轴力/力矩传感器
作者机构:Leo King, et al. University of California Santa Cruz, etc.
论文地址:https://arxiv\.org/pdf/2607\.10000
论文贡献:提出紧凑型五轴电容式力/力矩传感器PinFT,集成于镊子尖端,力误差约0.23N并在精细操作中可靠区分成功与失败。
未来工作:当前设计力范围限于9N以下,受限于硅胶-PCB结构的机械鲁棒性;未来将聚焦基于PinFT测量的实时闭环力控制以实现自适应精细操作。
原文链接: https://www.leiphone.com/category/private/ktXfJJsTen25O5Js.html
