


来源:公众号“鼓捣AI”
链接:https://mp.weixin.qq.com/s/MmRkJpvzaQx-tkdCEi7PLQ
在无人机领域,一个长期存在的悖论是:如何既保证安全,又实现极致的敏捷?
传统的无人机飞行控制器,无论是基于模型还是基于学习,都像是在“开卷考试”。它们依赖于精确的仿真训练和系统辨识,一旦部署到现实世界,就只能固守一套“标准答案”。当遇到未预料到的情况,比如电池老化、硬件磨损或突如其来的阵风时,这些固定的策略往往会变得束手无策,甚至导致坠机。因此,为了安全,它们不得不牺牲性能,以保守的姿态飞行。
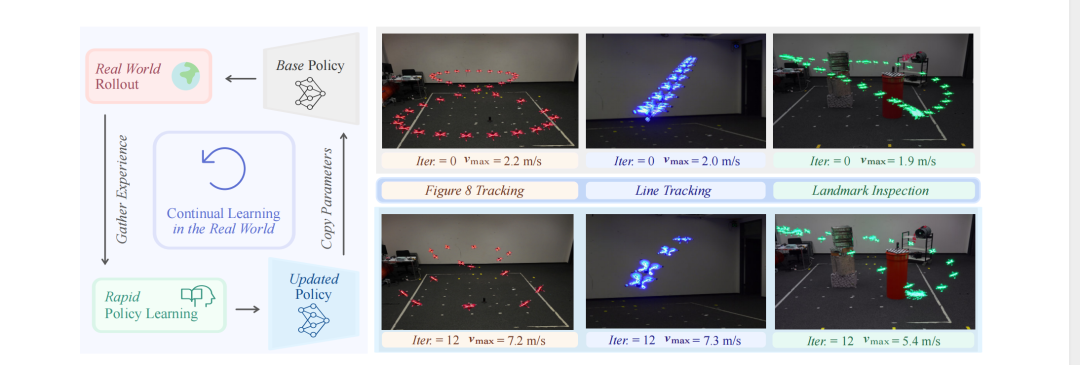
今天,要解读的这篇来自苏黎世大学机器人学与感知小组(RPG)的论文《Learning Agile Quadrotor Flight in the Real World》,提出了一种颠覆性的解决方案。它让无人机摆脱了对仿真和人类数据的依赖,通过在真实世界中“自学”,仅用约100秒的飞行时间,就将最高速度从2.0米/秒提升至7.3米/秒,逼近其控制接口的物理极限。
这项研究的核心是一个名为LAFR (Learning Agile Flight in the Real-world) 的自适应框架,它首次实现了无人机在真实世界中持续、在线地提升其敏捷飞行能力。
论文链接:
https://rpg.ifi.uzh.ch/docs/RSS26_Ren.pdf
项目链接:
传统方法的瓶颈:为何“开卷考试”行不通?
目前主流的敏捷飞行控制方法主要有两种:
仿真训练(Sim-to-Real):在仿真环境中进行大规模强化学习或模仿学习,然后将训练好的策略部署到真实无人机上。这种方法严重依赖于精确的系统辨识和大量的领域随机化,一旦现实世界与仿真环境出现偏差(即“现实鸿沟”),性能就会急剧下降。
离线适应(Offline Adaptation):通过收集真实世界的数据来优化仿真模型,然后重新训练策略。这种方法虽然能缩小现实鸿沟,但过程耗时耗力,无法应对快速变化的动态环境。
这两种方法都假设无人机的动态特性是固定不变的。然而,现实世界是动态的。电池电量下降、电机性能衰减、甚至是螺旋桨的轻微损伤,都会改变无人机的飞行特性。一个固定的控制器无法适应这些变化,只能以牺牲性能为代价来换取安全。
LAFR的突破在于,它不再让无人机“死记硬背”,而是让它“活学活用”。
LAFR的核心:一个“感知-学习-进化”的闭环
LAFR框架的核心是一个在真实世界和可微分仿真之间不断循环的闭环系统。它让无人机在飞行的同时,持续地学习、优化和进化。
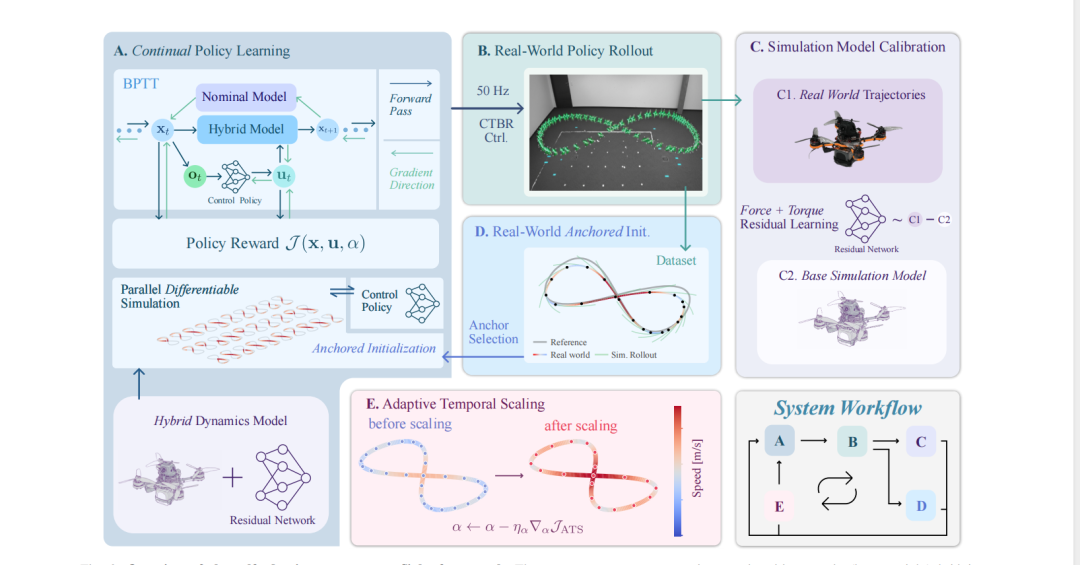
整个框架由三个协同工作的核心部分组成:
1、在线残差动力学学习(Online Residual Learning)
这部分是LAFR的“感知”系统,负责实时弥补“理想模型”与“物理现实”之间的差距。
混合动力学模型:LAFR并非从零开始学习,而是从一个简单的标称刚体动力学模型出发。然后,它引入一个神经网络来学习“残差”——即标称模型无法预测的加速度和角速度偏差。这些偏差可能来自未建模的空气动力学效应、硬件磨损或外部干扰。
在线训练:无人机在飞行中不断收集状态数据,并用这些数据实时更新残差网络。这使得混合动力学模型能够越来越精确地反映无人机当前的真实物理状态。
2、基于真实世界锚定的短时域反向传播(RASH-BPTT)
这部分是LAFR的“学习”系统,负责利用更新后的模型来优化飞行策略。
真实世界锚定(Anchored Initialization):为了解决仿真误差累积的问题,LAFR在进行策略优化时,不是从随机状态开始仿真,而是每次都从无人机在真实世界中的最新状态“锚定”开始。这确保了优化过程始终基于现实,避免了策略在“幻觉”中越走越远。
短时域优化:LAFR只在很短的时间范围内进行反向传播(BPTT),这进一步减少了因模型不完美而导致的误差累积,保证了策略更新的稳定性和高效性。
3、自适应时间缩放(Adaptive Temporal Scaling, ATS)
这部分是LAFR的“进化”系统,负责在保证安全的前提下,主动探索并提升飞行敏捷性。
动态调整速度:ATS引入了一个可学习的时间缩放参数α,它可以动态地“拉伸”或“压缩”参考轨迹的执行时间。当跟踪误差小时,ATS会减小α,让无人机飞得更快;当误差增大时,ATS会增大α,让无人机减速以确保安全。
安全边界探索:ATS将飞行安全作为一个约束条件,通过一个势函数来平衡“速度”和“安全”。它会主动将无人机推向安全边界,但又不会越界,从而在确保安全的同时,持续地探索并达到当前物理状态下的性能极限。
效果如何?从仿真到现实的表现
1、敏捷性:速度飙升3倍以上
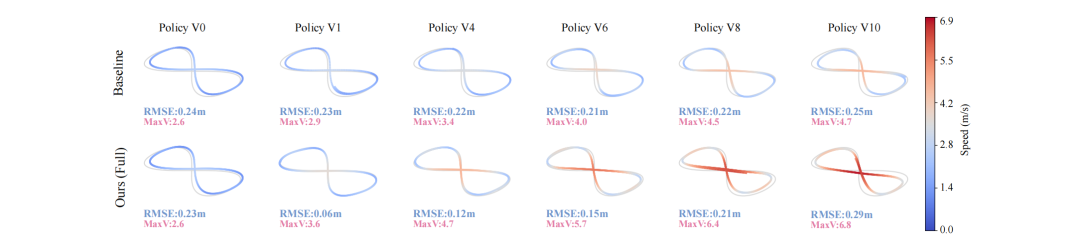
研究者在“8”字形和线性穿梭两种轨迹上进行了测试。
线性穿梭:无人机的最高速度从初始的 2.0 m/s 提升到了 7.3 m/s。
“8”字形轨迹:最高速度从 2.2 m/s 提升到了 7.2 m/s。
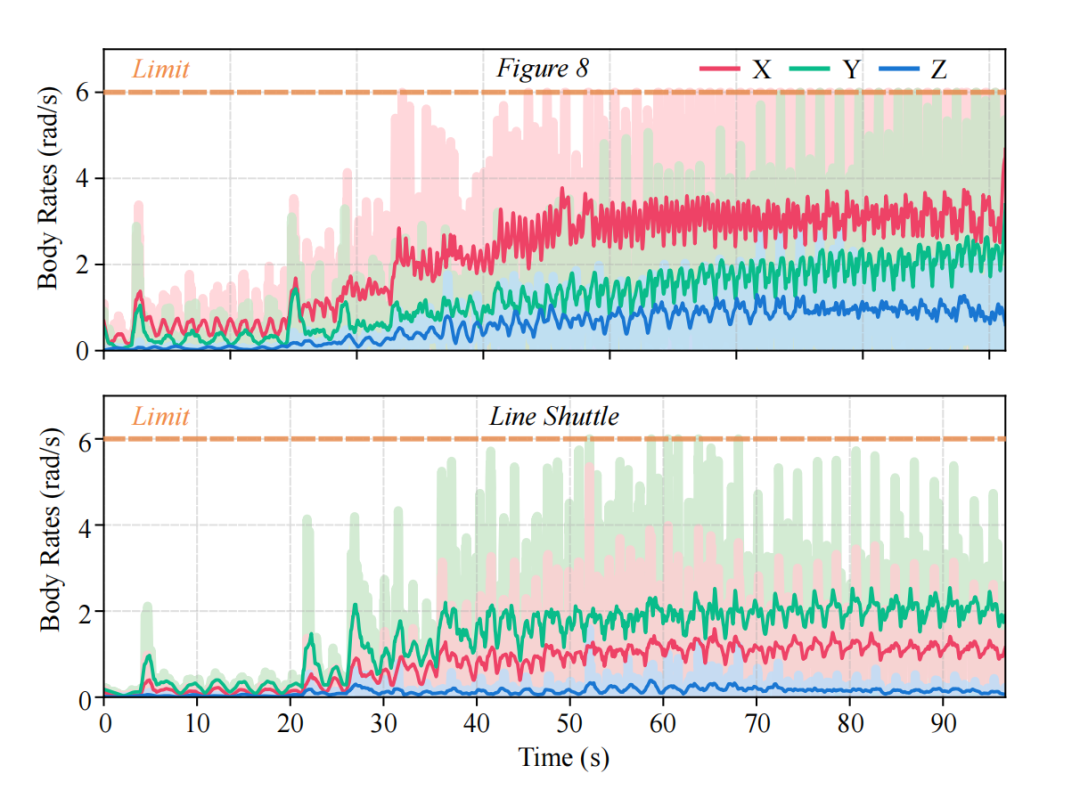
整个进化过程仅用了约100秒的飞行时间。更关键的是,适应后的策略使无人机的 commanded body rate 持续达到其控制接口的饱和上限(6 rad/s),这表明LAFR确实将无人机推向了其控制能力的极限,而非仅仅是在一个保守的范围内优化。
2、鲁棒性:从容应对硬件损伤
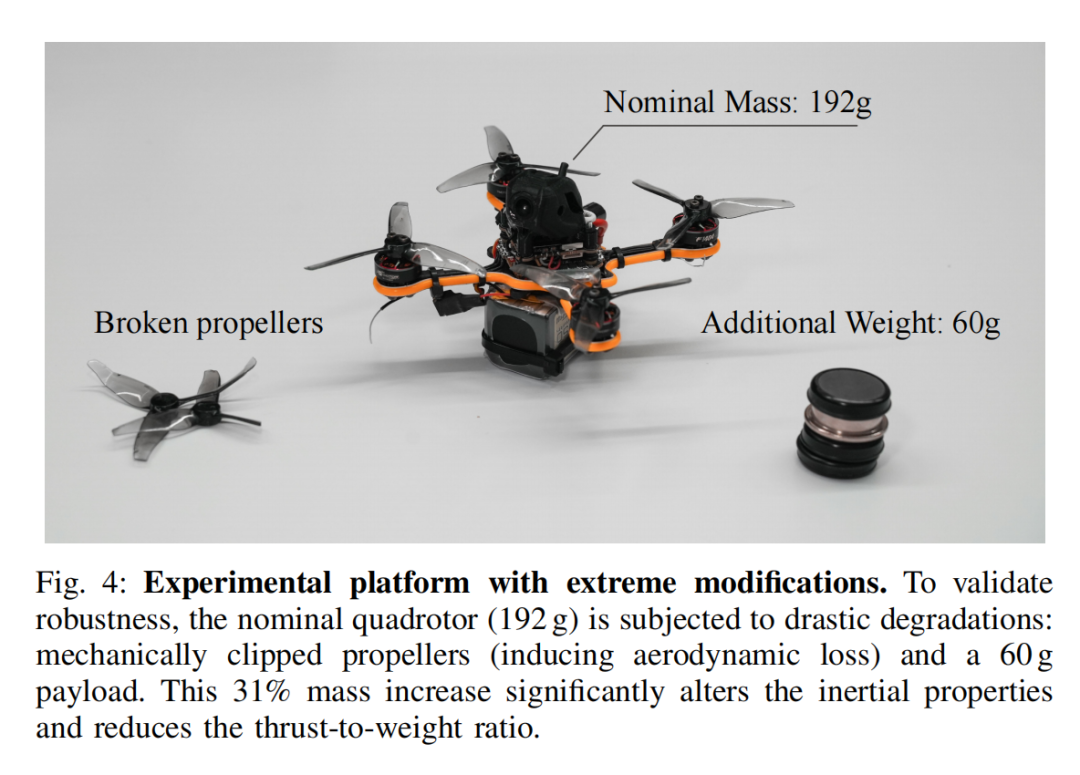
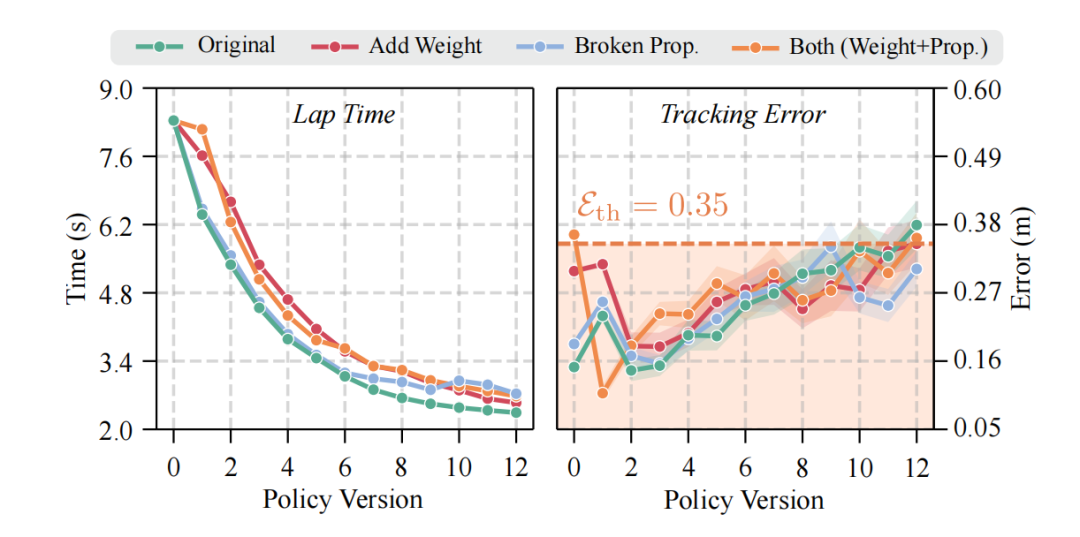
为了测试LAFR的鲁棒性,研究者对无人机进行了三种极端的硬件改造:增加60克配重、剪短螺旋桨、以及两者结合。
实验结果表明,即使在硬件受损、动力学特性发生剧变的情况下,LAFR也能在一次模型更新后迅速适应,并找到新的安全飞行包线。这证明了其在线残差学习能力的强大,它能让无人机“学会”带着“伤”继续高效飞行。
3、实用性:复杂环境下的任务优化
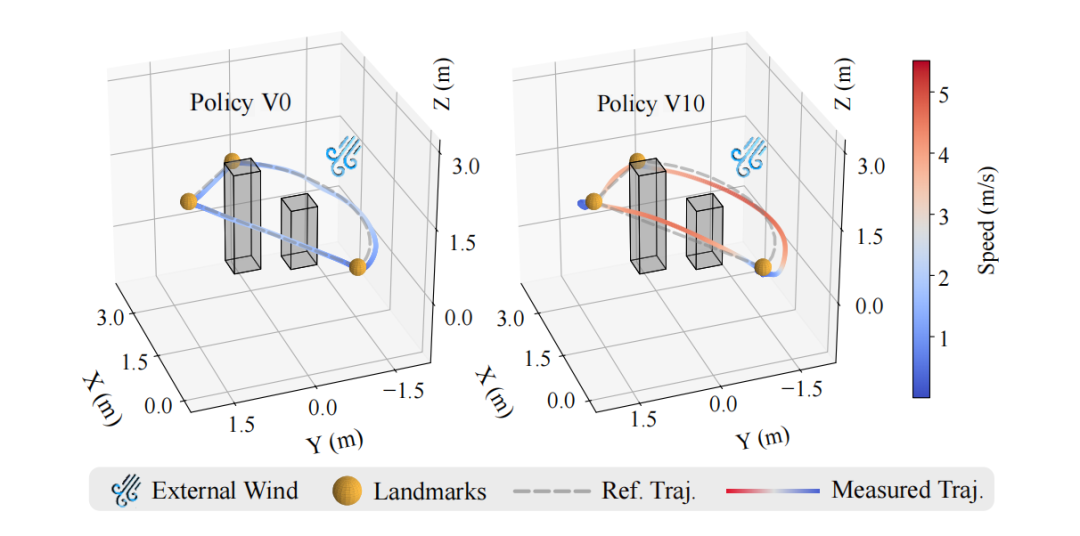
在一个模拟的真实任务中,无人机需要在强风干扰下穿越多个地标点。
初始状态:完成任务需要12秒。
适应后:LAFR通过在线学习补偿了风力干扰,并利用ATS机制将任务总时间缩短至7秒,效率提升了42%。
这证明了LAFR不仅能飞得快,还能在复杂动态环境中智能地优化任务执行效率。
总结展望
LAFR为无人机的运动生成开辟了一条新的道路。它证明了,通过结合LLM的高级推理和进化算法的探索能力,无人机可以摆脱对人类演示的依赖,自主创造出超越人类想象的、高度动态的全身运动技能。
当然,这项工作也存在一些局限性,例如目前只支持简单的刚体接触,且假设场景是已知的。未来的研究方向包括引入更复杂的接触模型(如滑动)、处理更复杂的物体(如铰接体),以及结合视觉模块,实现从传感器观测到动作生成的端到端闭环。
