


来源:以人为中心的协同计算
文章链接:https://mp.weixin.qq.com/s/WaE9yQZGUZfQzSS599Xu6w
近日,实验室硕士生任宇琪为第一作者的论文 GazePruning: Gaze-Guided Token Pruning for LVLMs in Virtual Reality 被 The 34th ACM International Conference on Multimedia(ACM MM 2026) 录用。ACM MM 2026今年收到7053有效投稿,往年的录用率为23.45%。
该工作面向虚拟现实场景中的大型视觉语言模型高效推理问题,聚焦视频输入带来的大规模视觉 Token 计算开销。现有视觉 Token 剪枝方法通常依赖视觉显著性或文本问题来判断 Token 的重要程度,但在自然 VR 交互中,用户真正关注的区域未必具有较高视觉显著性,同时文本查询也可能模糊、不完整甚至缺失。为解决这一问题,本文提出了注视引导的视觉 Token 剪枝框架 GazePruning。该方法利用 VR 设备天然可获取的眼动信号,在单帧内联合保留注视相关、全局语义和代表性视觉 Token,并进一步根据连续帧中的注视目标一致性进行帧间 Token 合并,从空间和时间两个维度减少冗余计算。实验结果表明,GazePruning 在多种主流 LVLM 和不同 Token Budget 下均取得优于现有剪枝方法的性能。
会议简介
ACM International Conference on Multimedia(ACM MM) 是多媒体领域的重要国际学术会议,研究内容涵盖多媒体分析、理解、生成、人机交互以及多模态智能等方向,也是中国计算机学会推荐的A 类国际学术会议。ACM MM 2026 计划于 2026 年 11 月 10 日至 14 日在巴西里约热内卢举行。
论文简介
问题背景
然而,LVLM 的计算成本会随着视频长度和视觉分辨率快速增长。以 Qwen2-VL 为例,一段仅包含 10 帧、分辨率为 480×480 的短视频,就会产生超过 4000 个视觉 Token。视觉 Token 数量远高于文本 Token,并逐渐成为模型推理过程中的主要计算负担。对于要求低延迟和高吞吐的 VR 系统而言,如何在尽可能保留有效视觉信息的同时减少冗余 Token,成为 LVLM 实时部署中的关键问题。
现有方法局限
现有视觉 Token 剪枝方法大体可以分为两类:显著性引导剪枝和问题引导剪枝。显著性引导方法根据视觉编码器内部的注意力或全局语义表示,识别画面中信息量较高的视觉 Token。例如,一些方法利用 [CLS] Token 与图像 Patch Token 之间的注意力关系筛选重要区域。这类方法无需依赖用户查询,但其判断标准来自模型本身的视觉显著性。问题引导方法则利用文本问题与视觉 Token 之间的跨模态注意力,只保留与当前查询语义相关的视觉信息。这类方法能够实现任务相关的 Token 选择,但高度依赖明确且完整的文本问题。
这两类方法在传统图像理解任务中具有较好的效果,但在 VR 场景中仍存在明显局限。首先,视觉显著性并不等同于用户关注。用户正在注视的目标可能并不显眼,却可能是当前交互过程中最关键的对象。如果仅依赖模型自身的视觉注意力,这些 Token 可能在剪枝过程中被直接删除。其次,自然 VR 交互并不总是伴随明确文本查询。用户输入可能十分简短,也可能根本没有显式问题,此时很难通过文本有效判断哪些视觉信息更加重要。
相比之下,现代 VR 设备通常能够通过内置眼动传感器实时获得用户的注视位置。眼动信息天然反映了用户当前正在观察的区域,因此可以作为一种更加直接的用户侧先验来指导模型分配计算资源。但直接使用眼动信息同样并不简单。一方面,注视点与真实注意力并不总是一致。用户可能存在偶然扫视、视觉搜索或注意游离,仅根据单个注视位置保留视觉内容可能导致重要场景信息丢失。另一方面,眼动信号存在明显的时间冗余。当用户持续注视同一物体时,相邻视频帧中注视区域的视觉语义通常高度相似,如果模型逐帧完整计算,会产生大量重复开销。
方法概述
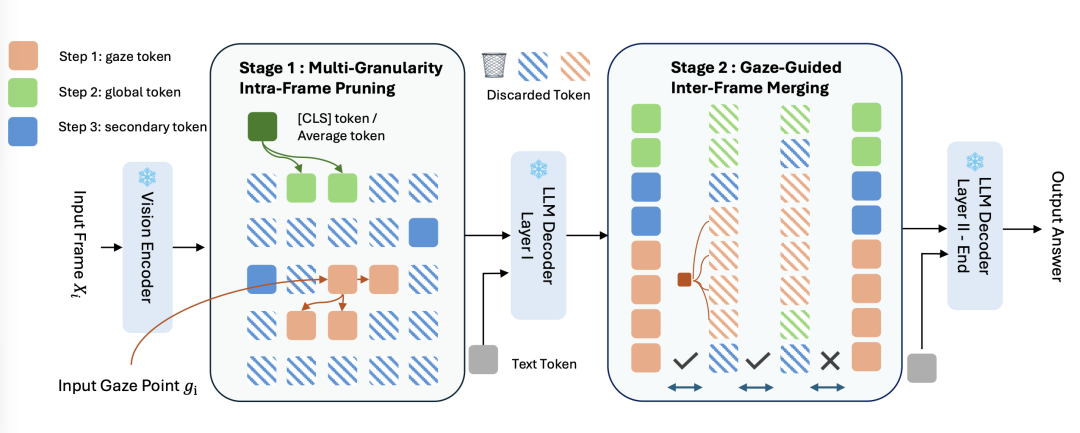
图1: GazePruning两阶段剪枝流程图
针对上述问题,本文提出 GazePruning,即 Gaze-Guided Token Pruning。GazePruning 的核心思想是:视觉 Token 的重要性不应只由图像本身或文本问题决定,还应考虑用户此刻真正注视的内容。同时,眼动信号本身存在噪声,因此模型也不能简单地“只保留注视区域”。基于这一思路,GazePruning 从帧内空间冗余和帧间时间冗余两个层面进行视觉 Token 压缩,整体包含两个核心模块:
第一,多粒度帧内剪枝(Multi-Granularity Intra-Frame Pruning)。同时保留注视相关 Token、全局语义 Token 和代表性辅助 Token,在突出用户关注内容的同时维持整体场景理解能力。
第二,注视引导的帧间合并(Gaze-Guided Inter-Frame Merging)。根据连续视频帧中注视目标的语义一致性识别重复内容,并将高度相似帧中的视觉信息进行聚合,减少时间维度上的重复计算。
阶段一:多粒度帧内剪枝
GazePruning 首先对每一帧进行独立的视觉 Token 剪枝。本文通过分析 LVLM 的视觉表征发现,属于同一物体的视觉 Token 往往具有较高的语义相似性。因此,用户的注视位置可以作为一个语义锚点,用于进一步发现与当前注视对象相关的视觉区域。基于这一观察,GazePruning 将保留的视觉 Token 分为三个层次。
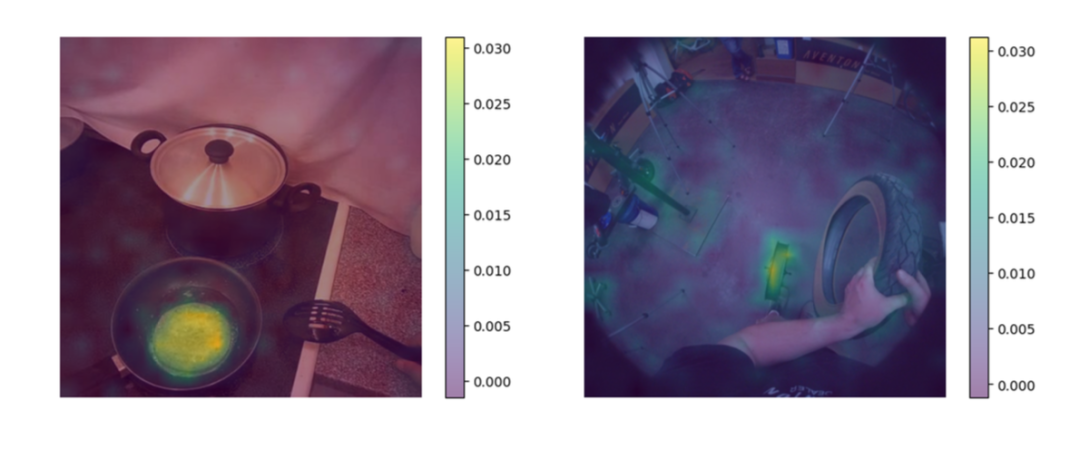
图2:同一物体视觉token具有语义相似性
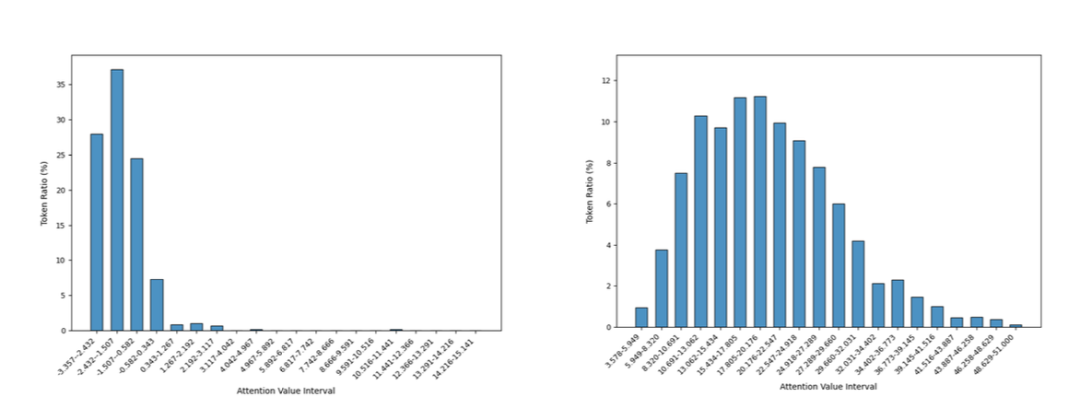
图3: 全局信息token具有稀疏性
注视相关 Token
对于视频中的第 (t) 帧,系统首先将用户的二维注视坐标映射到对应的视觉 Token,得到 gaze-anchored token。随后,模型计算这一 Token 与当前帧所有其他视觉 Token 之间的余弦相似度,并保留相似度最高的一组 Token。与直接裁剪注视点周围的固定区域不同,这种方法基于的是语义相似性。例如,当用户注视一个物体的局部区域时,与注视位置属于同一物体的其他 Token 往往也具有较高的特征相似度。通过这种方式,模型可以从一个注视位置进一步恢复用户真正关注的完整语义对象。
全局语义 Token
仅保留注视区域仍然存在明显风险。用户虽然正在注视某个局部对象,但很多视觉推理任务仍然依赖周围环境以及整体空间关系。因此,GazePruning 进一步保留能够表示完整场景语义的一部分 Token。对于具有 [CLS] Token 的视觉编码器,模型直接使用 [CLS] 作为全局语义锚点;对于 Qwen2-VL 等没有显式 [CLS] Token 的架构,则计算所有视觉 Token 的平均特征作为全局表示。随后,模型同样根据语义相似度筛选一部分具有较强全局代表性的 Token。这样,模型既能够重点处理用户正在看的目标,又不会完全丢失周围环境信息。
代表性辅助 Token
在注视 Token 和全局 Token 之外,仍可能存在一部分既不属于主要注视对象、也不是全局中心,但对后续推理具有补充价值的视觉信息。因此,GazePruning 进一步采用 Farthest Point Sampling(FPS) 在特征空间中选择少量代表性辅助 Token。FPS 会优先选择与现有 Token 差异较大的视觉表征,使最终保留下来的特征覆盖更加多样的语义区域。最终,GazePruning 在每一帧中同时保留:注视相关信息、全局场景信息和具有代表性的补充信息。
三种 Token 共同形成多粒度的视觉表示,在降低 Token 数量的同时降低错误剪除重要信息的风险。
阶段二:多粒度帧内剪枝
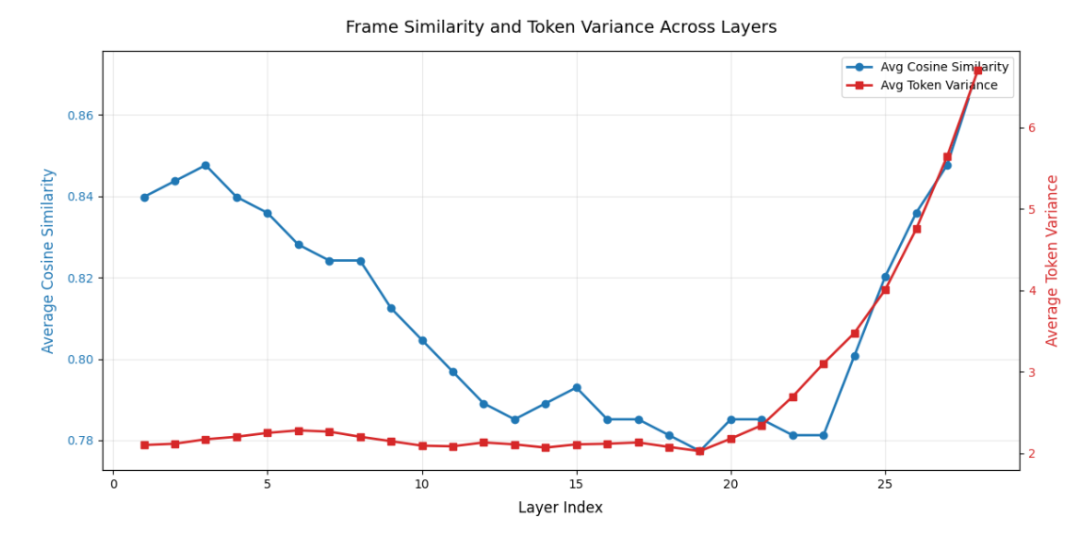
图4: 不同帧的同一物体的视觉token在浅层具有较高的相似性
仅进行帧内剪枝仍然无法解决视频中的时间冗余。在 VR 场景中,用户经常会持续注视同一个对象。例如,在观察桌上的物体、跟踪移动目标或完成某项操作时,用户可能连续多个视频帧都将视线保持在同一区域。此时,相邻视频帧中注视目标对应的视觉 Token 往往高度相似。如果仍然对每一帧进行完整计算,就会反复处理大量几乎相同的视觉语义。为此,GazePruning 进一步提出注视引导的帧间 Token 合并机制。
首先,对于每一个视频帧,模型计算当前帧所有注视相关 Token 的平均特征,作为这一帧的 gaze representation。随后,计算相邻两帧 gaze representation 之间的余弦相似度。如果连续多帧的相似度高于预设阈值,说明用户大概率仍然在观察同一视觉对象。GazePruning 会将这些连续帧组成一个时间窗口。对于一个稳定注视窗口,模型保留第一帧的视觉 Token,而后续高度相似帧不再完整保留所有 Token。与此同时,模型会将窗口内各帧中的 gaze representation 聚合为一个 temporal gaze-summary token,并加入第一帧的 Token 序列中。
通过这种方式,模型可以同时保留两类信息:一方面,代表帧提供完整的空间和场景结构;另一方面,temporal gaze-summary token 保存被注视对象随时间发生的潜在变化。因此,GazePruning 并不是简单删除后续视频帧,而是在压缩时间冗余的同时保留用户关注对象的动态语义。
实验
本文在 EgoGazeVQA Benchmark 上进行实验。该基准覆盖三个具有眼动信息的第一视角视频数据集:Ego4D、EgoExo4D 和 EGTEA Gaze+。整体包含 900 个视频和 1700 组问答样本,主要评估 LVLM 根据用户注视信息理解用户意图的能力。问题进一步划分为三个维度:Spatial:考察物体与注视位置之间的空间关系;Temporal:考察用户注视轨迹随时间的变化;Causal:考察注视行为与用户行为之间的因果关系。
为了验证方法的模型泛化能力,本文在多个主流 LVLM 上进行实验,包括:LLaVA-NeXT-Video-7B、InternVL2.5-8B、InternVL3-8B、Qwen2-VL-7B 和 Qwen2.5-VL-7B。对比方法包括三类具有代表性的 Token 剪枝方法:SparseVLM、VisPruner 和 FrameFusion。其中分别对应问题引导、显著性引导以及视频帧间冗余建模等不同剪枝思路。
实验结果表明,在不同 LVLM 和不同 Token Budget 下,GazePruning 均能够稳定优于现有 Token 剪枝方法。
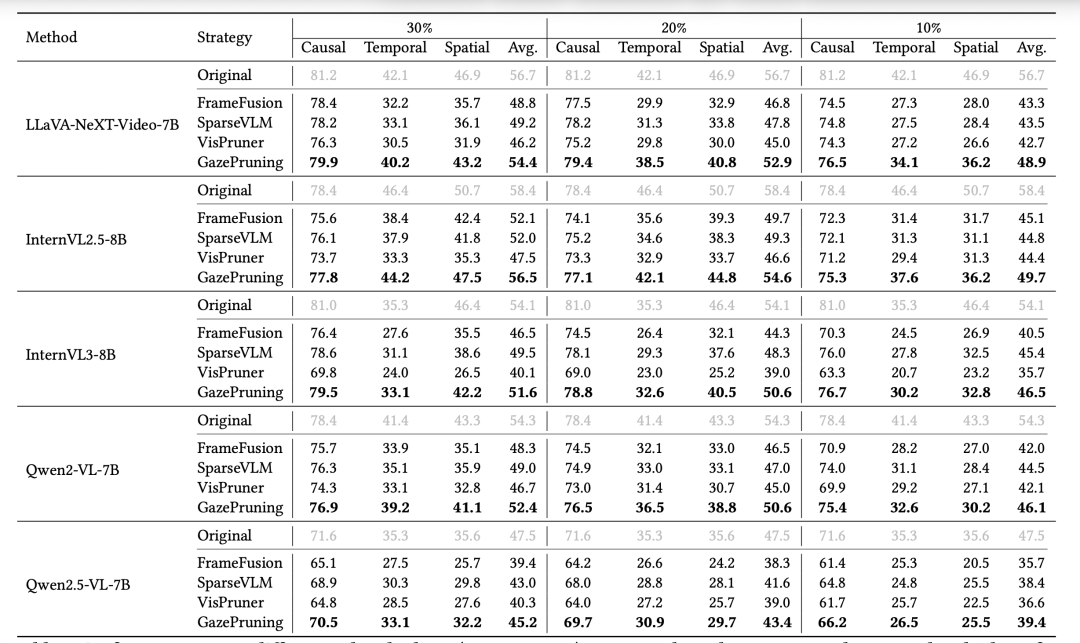
表1:不同模型架构、不同方法在同一剪枝力度下的效果对比
总结
总体而言,GazePruning 重新思考了 VR 场景中 LVLM 的视觉 Token 选择问题:哪些视觉信息值得计算,不应只由模型本身决定,也可以由用户真实的视觉行为参与决定。通过将用户注视作为视觉 Token 剪枝的重要先验,GazePruning 在单帧内部同时保留注视目标、全局场景和代表性补充信息,并进一步利用连续注视所产生的时间一致性减少跨帧冗余。这种设计使模型能够从空间冗余和时间冗余两个层面压缩视觉 Token,并在计算效率和任务性能之间取得更好的平衡。相比仅根据视觉显著性或文本查询进行剪枝,GazePruning 进一步将用户侧注意信息引入 LVLM 的计算过程,为面向 VR 眼镜、AR 眼镜等沉浸式设备的实时多模态智能提供了一种新的思路:让模型不仅能够“看见”环境,也能够知道用户正在看哪里,并把有限的计算资源用在真正值得看的地方。
致谢
本工作获得上海市科学技术委员会“科技创新行动计划”元宇宙专项项目“面向XR自然交互的手势识别与眼动追踪技术与示范应用”(项目编号:24511106300)的支持,为该项目重要成果之一。
