


来源:慧视AI迹
原文链接:https://www.toutiao.com/article/7670733576400339456
这是「具身智能日报」的第一篇深度精读。我们只讲一篇论文,把它讲透:SUREFlow,一篇刚被 IROS 2026 接收、7 月 11 日才挂到 arXiv 上的轻量 VLA 工作。它最抓人的点在于:只有 179M 参数,在 LIBERO 上做到 92.5% 平均成功率,在更考验鲁棒性的 LIBERO-PRO 上追平 3B–7B 参数的 OpenVLA 和 π0.5。它不是把模型做大,而是把“不确定性”这件事想清楚了。下面我们从动机、方法、实验、局限四个层面把它拆开。
一、论文档案
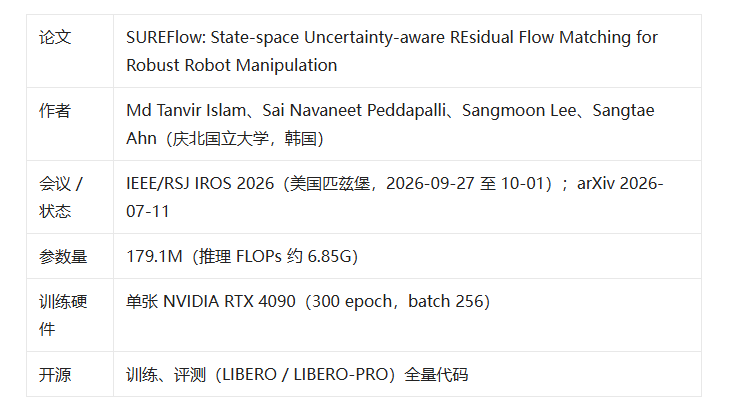
GitHub: | 论文:
二、一句话总结
一句话总结:SUREFlow 用 Mamba(状态空间模型)做骨干,把动作生成建模成“流匹配”问题,并在其中显式学习每个动作维度的预测不确定性(异方差建模)。训练时用不确定性加权损失,推理时不依赖环境反馈、只对“高不确定”的动作维度做几轮内部残差精修。最终以 179M 参数在 LIBERO 平均成功率 92.5%,在 LIBERO-PRO 上以 0.49 的成绩追平 3–7B 参数的大模型。
三个核心贡献:① URFlow:不确定性感知的残差流(训练 + 推理闭环精修);② MGAD:记忆引导动作解码器,轻量交叉注意力,让动作 token 学会“查记忆”;③ Mamba + FCM:线性复杂度骨干 + 流时间条件调制,保证轻量高效。
三、背景与动机:为什么生成式策略会“不稳”?
3.1 从“直接回归”到“生成式策略”
模仿学习最早的主流做法是直接回归动作(Implicit BC 等),输出是确定性的。这类方法有个公认的软肋:真实演示常是多模态的(同一句话、同一画面,可能有多种合理动作),确定性回归只能学到“平均”,动作会模糊、抖动。
于是生成式策略登场:扩散策略(Diffusion Policy)和流匹配(Flow Matching)不再预测单个动作,而是学习“动作的条件分布”,每次采样生成一个完整动作序列。多模态表达能力上去了,但新的问题来了——生成过程引入了随机性,随机性会在长程 rollout 中累积。
3.2 论文瞄准的三个具体问题
误差累积:长程任务里动作是开环执行的(模型不实时看反馈),每步小的速度误差会像滚雪球一样变大,最后动作漂移、任务失败。
同方差假设:现有 diffusion / flow 策略在拟合速度场(velocity field)时,默认所有维度、所有时刻的残差都一样可靠(homoscedastic),没有显式的不确定性建模。但现实中,某些时刻、某些关节就是更难预测(比如要精插的瞬间 vs 大范围移动的瞬间)。
算力门槛:主流 VLA 靠 Transformer 大骨干(OpenVLA 7B、π0.5 3B),推理和训练成本高,边缘部署难。
论文的核心命题:能不能用轻量骨干 + 显式不确定性建模,让生成式策略在长程执行中“自己知道自己哪里不可靠”,并只修正这些地方?
四、方法详解(核心章节)
4.1 先复习:条件流匹配怎么工作
流匹配把“生成动作”变成一个“搬运”问题:从一个简单分布(高斯噪声)出发,学一个速度场,把噪声一步步“搬”到专家动作分布上。具体地,给定真实动作 a 和噪声 z,定义插值路径:
x_t = (1 − t) · a + t · z,t ∈ [0,1]
t=0 时是真实动作,t=1 时是纯噪声。这条路径的解析速度场是 v(x_t) = z − a。模型学一个条件速度场 v̂_t = f_θ(x_t, s, t),s 是多模态条件(图像、状态、语言),训练目标是让 v̂ 逼近 v。推理时从噪声出发沿学到的速度场积分(论文用 70 步),得到动作序列。
4.2 整体架构一览
SUREFlow 的输入是:双视角 RGB 图(主视角 + 手眼相机)+ 机器人关节/夹爪状态 + 语言指令。整体架构如下(论文 Fig. 2):
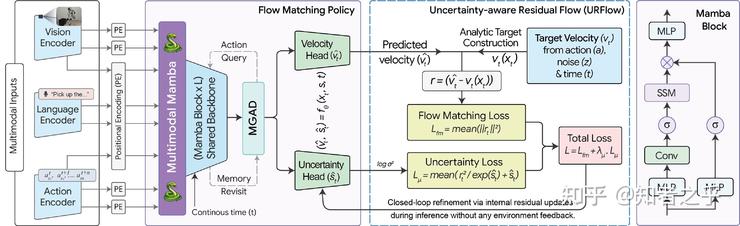
图 1:SUREFlow 整体架构(论文 Fig. 2,图片提取自 arXiv 原文)
4.2.1 架构图解:从左到右逐块看
这张图信息量很大,我们按数据的流动方向逐块读:
输入端(最左):双视角 RGB(主视角 I¹ + 手眼相机 I²)、机器人状态 s(关节 + 夹爪)、语言指令 g。
编码器:每个视角一个 ResNet-18(带 GroupNorm)输出 256 维视觉 token;状态做线性投影;语言用 CLIP ViT-B/32 编码成固定任务 embedding e。
时间嵌入:流时间 t 经正弦频率嵌入 + 两层 MLP 得到 ϕ(t),告诉网络“现在走到噪声→动作这条路的哪一步”。
统一 token 序列:把 [ϕ(t), e, 两个视觉 token, 状态 token, 当前动作 token x_t] 拼成序列,喂给骨干。
Mamba 骨干(中间大块):L=5 层选择性状态空间模型(隐藏 256),负责跨 token 的时序建模;FCM 沿层注入流时间做仿射调制(图中调制箭头)。
MGAD(右上):动作 token 作为 10 个可学习 query,对骨干输出的多模态记忆做单层交叉注意力,得到精化后的动作特征。
输出头(右侧两个头):速度头 f_v 预测动作速度场 v̂,不确定性头 f_s 并行预测对数方差 ŝ(即 log σ²)——这是 URFlow 的原料。
图下方的训练/推理回路:训练时用“流匹配损失 + 不确定性加权损失”联合优化;推理时从高斯噪声沿速度场积分 70 步生成动作序列,再在 t=0 处按不确定性掩码做 K 步内部精修(下一节详讲)。
4.3 FCM:把“时间”注入每一层
光把时间 token 拼进去还不够。FCM(Flow Conditioned Modulation)从时间嵌入 ϕ(t) 提取条件向量 c,学习两组线性投影生成缩放 γ 和偏移 β,对中间特征做仿射调制:
FCM(U, ϕ(t)) = U ⊙ (1 + γ) + β
关键细节:γ、β 初始化全零,所以网络一开始等价于恒等映射,训练稳定。FCM 应用到状态 token、动作 token、解码后的动作特征(可选任务 embedding)上,让网络对“现在走到概率路径的哪一步”保持感知。
4.4 MGAD:让动作 token 学会“查记忆”
MGAD(Memory-Guided Action Decoder)的直觉:动作预测不应该只靠动作 token 自己闷头算,而应该去“翻阅”整个多模态上下文(视觉、状态、任务记忆)。
10 个可学习动作查询(action queries),一层 4 头自注意力 + 交叉注意力(头维 64),再接 2 层 FFN(隐藏 512)+ LayerNorm。
相比完整 Transformer 解码器,这是单步轻量交叉注意力,几乎没有增加参数量(约 +0.3M)。
隐藏收益(消融里会看到):MGAD 让不确定性估计收敛更快、范围更稳定,避免模型“过度自信”。
4.5 URFlow:本文的灵魂——不确定性感知的残差流
URFlow 分训练和推理两段,思路非常干净。
训练:把残差当成“异方差”来拟合
模型在预测速度 v̂_t 的同时,用一个独立线性头预测不确定性的对数方差 ŝ_t(即 log σ²)。定义残差 r_t = v̂_t − v_t。训练总损失:
L = L_FM + λ_u · L_u,其中 L_u = ||r_t||² / exp(ŝ_t) + ŝ_t
这个形式来自经典的异方差回归(Kendall & Gal)。它的巧妙之处:
如果某维度残差大,模型会被惩罚去增大 ŝ_t(承认“我不确定”),而不是硬着头皮把残差压小;
exp(ŝ_t) 保证方差为正,对数形式数值稳定;
λ_u = 0.001 是精心调过的权重——太大(0.05)会喧宾夺主,性能反而掉到 0.79(后文敏感性分析)。
推理:不做环境反馈的“内部闭环”精修
推理时,URFlow 对生成的动作序列做一次纯内部的、确定性的精修:
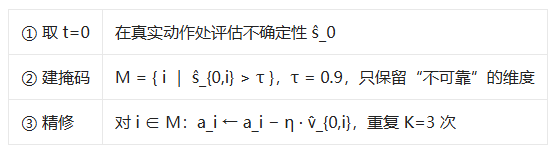
整个过程不接触环境、不需要奖励或真值,完全在模型内部完成——这正是它名字里“Residual(残差)”的含义:把速度场预测的残差当成修正信号,朝着真实速度场的方向“拽”一步。
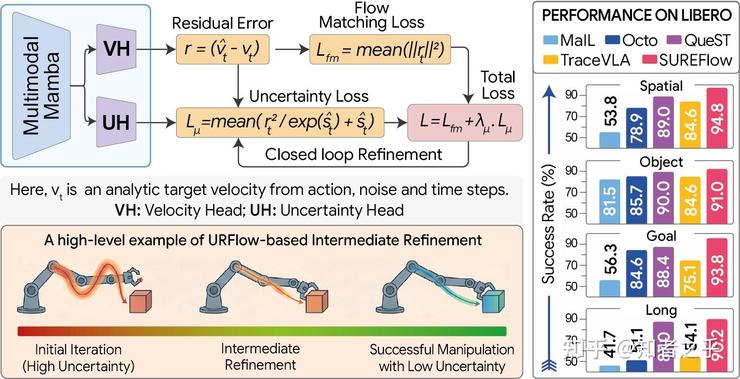
图 2:URFlow 推理期“内部闭环”精修流程(论文 Fig. 1)
图 2 把推理精修画得很直观:先生成动作序列 a;然后在 t=0 处评估每个维度的不确定性 ŝ₀,超过阈值 τ 的维度进入掩码 M;最后只对掩码里的维度执行 a_i ← a_i − η·v̂₀,ᵢ,重复 K 次。左侧是“闭式循环”——输出会回到输入再评估,但全程在模型内部,不碰环境。
为什么这套机制能work?长程开环执行最大的敌人是误差累积。URFlow 等于给生成结果加了一个“自查自纠”环节:先问模型“我哪些维度没把握”,再只改这些维度。注意是按维度选择精修,而不是整条动作统一缩放——这是它比简单后处理更细腻的地方。
五、实验结果详解
5.1 LIBERO:四套任务平均 92.5%,比同骨干的 MaIL 高 34.2 个百分点
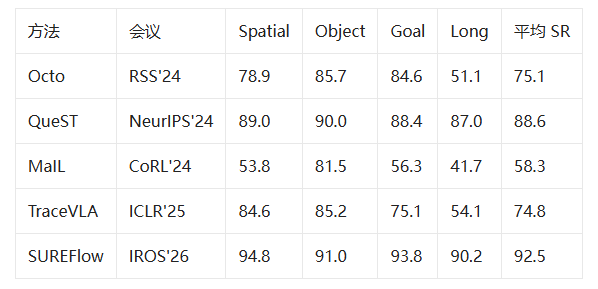
两点解读:第一,MaIL 也是 Mamba 骨干,但只有 58.3%——说明增益主要来自 URFlow 的不确定性建模,而不是换了个骨干;第二,Long 套件(长程)92.2% 是全场最高,恰好命中论文想解决的“长程误差累积”痛点。
5.2 Meta-World:难任务提升最明显,平均 88.32%
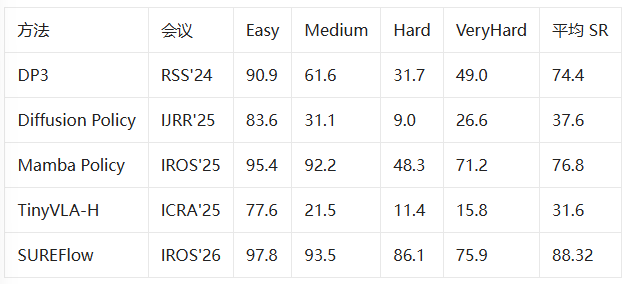
注意 Hard 列:Diffusion Policy 只有 9.0、TinyVLA-H 只有 11.4,SUREFlow 做到 86.1。难度越高提升越大,说明不确定性精修在“复杂、易出错”的动作上最有价值。
5.3 LIBERO-PRO:分布偏移下追平 3–7B 大模型
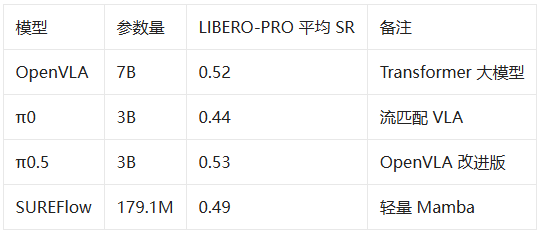
LIBERO-PRO 对物体、语义、任务、环境做扰动,测的是“换了个场景还认不认识”,比普通 LIBERO 更能反映泛化。0.49 与 7B 的 OpenVLA(0.52)、3B 的 π0.5(0.53)基本同档,参数量却只有它们的 1/20 到 1/40。
一个诚实的数据细节:在“位置扰动”和“任务扰动”两类下,几乎所有模型(包括 7B)都接近 0——说明这类扰动确实难,基准本身也有盲区;SUREFlow 的分数主要来自语义和环境扰动的稳定表现。
5.4 消融:URFlow 是单模块增益最大的,MGAD 负责“校准”
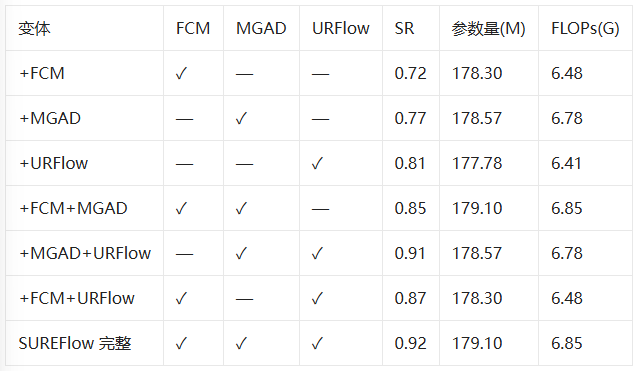
读表要点:① 单模块看,URFlow 增益最大(0.72→0.81);② MGAD 单独看只有 0.77,但和 URFlow 搭配到 0.91——因为它解决的是“不确定性校准”:论文的图 4(d) 显示,没有 MGAD 时模型的不确定性预测更极端(过度自信),有了 MGAD 才收敛快、范围稳;③ 完整模型 0.92,且参数量、FLOPs 几乎没变——提升来自建模质量而不是堆规模。
5.5 敏感性:三个超参的甜点区
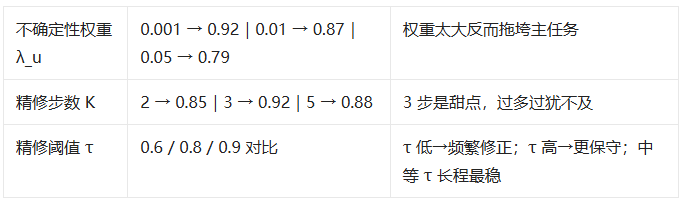
这组实验说明 URFlow 不是“有就行”,而是“要校准”:不确定性权重、精修深度、触发阈值都需要配平,配平好了才能在长程任务里又稳又不矫枉过正。
5.6 长程稳定性:开环 rollout 越长,URFlow 的优势越大
论文在 LIBERO Long 上对比了“有 URFlow / 无 URFlow”随 rollout 步数增加的成功率曲线:无 URFlow 时成功率随步数快速下滑且波动大;有 URFlow 时下降更平缓、更稳定。这正是对“误差累积”痛点的直接回应——URFlow 等于在每轮生成后把不可靠的维度往回拽,抵消了一部分积分误差。
5.7 真机验证:Franka 上做“颜色匹配插杯”,平均 88.5%
硬件:Franka Emika 七轴臂 + 平行夹爪 + Intel RealSense D405 RGB-D 相机,推理跑在 RTX 4090 上。任务:桌上 3 种颜色共 6 个杯子,机器人要①选定一个杯子 ②识别同色配对 ③把抓起的杯子插到同色杯上——要求颜色辨别、稳定抓取、精确对位三件事同时做对。
结果:每色 20 次 rollout(共 60 次),平均成功率 88.5%,在真实感知噪声和微小位姿偏差下稳定完成。说明不确定性精修不只是仿真里的“数字游戏”,在真实环境同样有帮助。
六、深度解读:这套设计到底妙在哪?
6.1 把“错误”变成“信息”,而不是一味消除
多数策略训练把残差一律当成“要压到零的错误”。URFlow 换了个视角:残差里包含任务难度和数据的真实不确定性,与其假装它不存在,不如显式建模它。这个哲学和贝叶斯/异方差回归一脉相承,但落在生成式机器人策略上还是首次(论文声称)。
6.2 “内部闭环”是轻量模型的作弊码
大模型靠海量参数记住更多场景,小模型没这个资本。URFlow 提供了一条不需要参数的补偿路径:推理时多做几轮“自查自纠”。等价地看,a ← a − η·v̂_0 就是在动作空间做一步梯度式修正,代价只有几次前向,却把长程稳定性显著拉高——这是“用算力换参数”的典型做法,对边缘部署特别友好。
6.3 效率账:179M 意味着什么
训练:单张 RTX 4090、300 epoch、batch 256 就能复现;推理:6.85G FLOPs,比 7B 级模型低一到两个数量级。对实验室和中小团队来说,“能跑得起、能复现”本身就是巨大价值——这也是它一开源就值得跟的原因。
6.4 一个容易被忽略的点:MGAD 是给 URFlow 打工的
只看消融表容易觉得 MGAD“没什么用”(单独 0.77)。但组合实验和不确定性曲线说明,MGAD 真正的作用是让不确定性头学会“什么时候该说不确定”——校准是精修有效的前提。这个“配角组件成就主角组件”的结构,值得在复现时单独验证。
七、局限性与值得存疑的地方(诚实版)
真机实验规模小:只有一个桌面任务(插杯)、60 次 rollout,且没有在真机上对比其他基线。真机泛化到复杂场景的证据仍然有限。
动作空间只有 7 维:LIBERO / Meta-World / Franka 都是 7 轴操作。双机械臂、灵巧手、移动操作等更高自由度场景没有验证,不确定性头的“逐维精修”在高维下是否仍有效是开放问题。
语言理解偏弱:用的是 CLIP 文本编码器而不是大语言模型,复杂指令、长指令的语义能力有限;LIBERO 的指令相对模板化,掩盖了这部分差距。
LIBERO-PRO 的分数构成要看清:位置/任务扰动下所有模型都接近 0,SUREFlow 的 0.49 主要来自语义与环境扰动——它追平的是大模型,但离“真泛化”还有距离。
精修超参需要调:τ、K、η 都是人工设定,K=5 反而下降说明“精修过头”有害;目前没有学出来的自适应停止条件。
没有大规模预训练:SUREFlow 从零训练,没有 OpenVLA/π0.5 那样的互联网级预训练,开放世界零样本泛化尚未被证明。
八、复现指南(基于官方仓库)
环境:Python 3.10 + PyTorch(推荐 CUDA 12.1+),仓库自带 Mamba 块的参考实现(SUREFlow/mamba/),不用单独装 Mamba 库。
训练:python run.py --train_suite libero_spatial(支持 libero_object / libero_spatial / libero_goal / libero_90 / libero_10)。
评测(普通 LIBERO):python run.py --train_suite libero_spatial --checkpoint_path /path/to/ckpt.pth。
评测(LIBERO-PRO):加 --eval_suite object(可选 swap / lan / task / temp)——训练集与评测集解耦,模型只在标准套件上训练。
复现建议:先跑 LIBERO-Spatial 确认基线,再开 --eval_suite object 验证鲁棒性;如果想验证 URFlow 的贡献,可以临时把不确定性头或推理精修关掉对比成功率曲线。
九、结语:这篇论文在回答什么大问题?
具身智能现在有两条路线:一条是“把模型做大”(OpenVLA、π0.5 的路线),一条是“把模型做小但做聪明”。SUREFlow 属于后者,而且给出了一个非常自洽的答案:轻量骨干负责效率,不确定性建模负责鲁棒,推理期精修负责长程稳定。
它未必是最终答案——真机证据薄弱、动作空间有限、语言能力一般,都是硬伤——但它把“不确定性”这个长期被忽视的维度,做成了可训练、可推理、可复现的完整闭环。对资源有限的团队来说,这是一条值得认真跟的路线。
小编结语:读论文最重要的是建立“评估坐标系”:小模型能不能打,关键看三点——骨干效率、不确定性的校准质量、以及推理期有没有低成本的纠错机制。SUREFlow 三样都占,所以它“以小博大”的成绩是有逻辑支撑的,不是刷出来的。
原文链接: https://www.leiphone.com/category/private/MmZ7qLoYhbM84tVL.html
