


来源:公众号“极佳科技GigaAI”
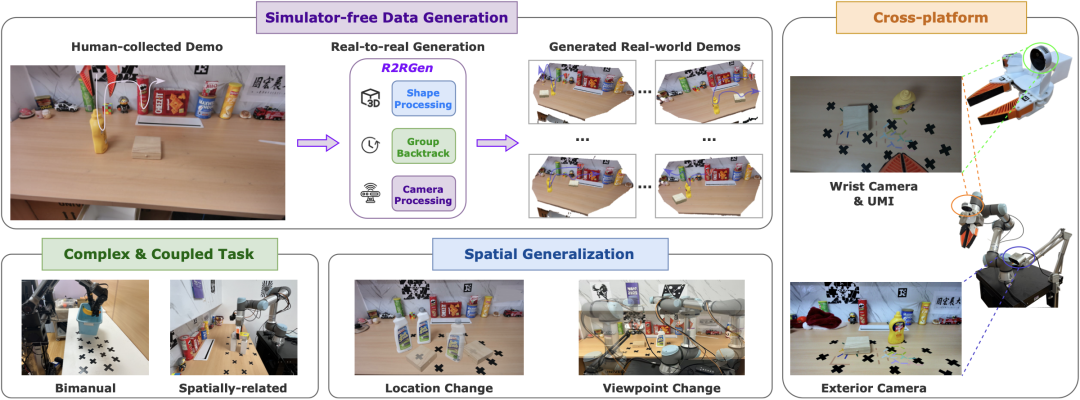
R2RGen 通过三项关键设计在最低人力代价下解锁强空间泛化:
其一,将外置 / 腕部等不同相机配置的源演示统一解析到世界坐标系,完成几何补全的场景解析与 motion / skill 轨迹分段;
其二,提出group-wise backtracking增强策略,把每个技能与一组目标 / 在手物体绑定、按因果顺序回溯地施加群体一致变换,从而支持任意数量物体与复杂的空间耦合关系;
其三,引入camera-aware post-processing,通过投影 + Patch-wise Z-buffer + 边缘填充,使增强后的 3D 观测严格匹配真实 RGB-D 相机的分布。在仅使用1 条人类演示的极端设置下,R2RGen 在 8 个真实世界任务上的平均成功率达到 40.3%,可媲美 25 条人类演示训练的策略,并完整支持移动操作、跨相机视角部署、双臂任务与非刚体物体。
论文链接:https://arxiv\.org/abs/2510\.08547
项目主页:https://r2rgen\.github\.io
代码地址:https://github\.com/r2rgen/R2RGen
背景
视觉运动策略借助模仿学习,能将视觉观测直接映射为机器人动作,是当下机器人操作端到端学习的主流范式,但对人类演示数据的需求很高:即便像"把苹果放到盘子"这样物体和技能都固定的任务,也常常需要几十到上百条演示去覆盖物体的空间分布与机器人本体位姿的变化。移动操作场景进一步放大了数据需求——底盘位置变化会带来视角变化,让"采够数据"变得更不现实。 空间泛化,因此成为机器人数据效率的根本瓶颈。
为缓解人力负担,MimicGen 系列工作通过在仿真器中合成轨迹来扩展少量真实演示,但仍需要 on-robot rollout 才能拿到真实观测,受限于 sim-to-real gap 与仿真器搭建成本。最近的 DemoGen 首次把数据生成搬到 3D 点云空间,做到 simulator- and rendering-free,但存在三个核心限制:1.仅支持固定底盘 + 外置相机,无法处理视角变化与腕部相机;2.对输入假设过强——需要裁剪背景、每个技能只能涉及单一目标物体;3.大幅增强后产生 visual mismatch:该被观测到的点缺失、该被遮挡的点却存在。这些限制让 DemoGen 在真实复杂任务上难以落地。
R2RGen 的目标,就是在移动 + 多相机 + 复杂物体交互的真实场景中,把"一条演示生成大量真实分布数据"做成可用的工程方案。
方法概览
R2RGen 采用三阶段流水线,将源演示从采集时的相机坐标系统一到共享世界坐标系内做增强,再转换回部署时的相机坐标系:
1. 源演示解析:完整场景 + 结构化轨迹
为避免"裁剪背景 + 单目标"这种强假设,R2RGen 对源演示做完整解析:
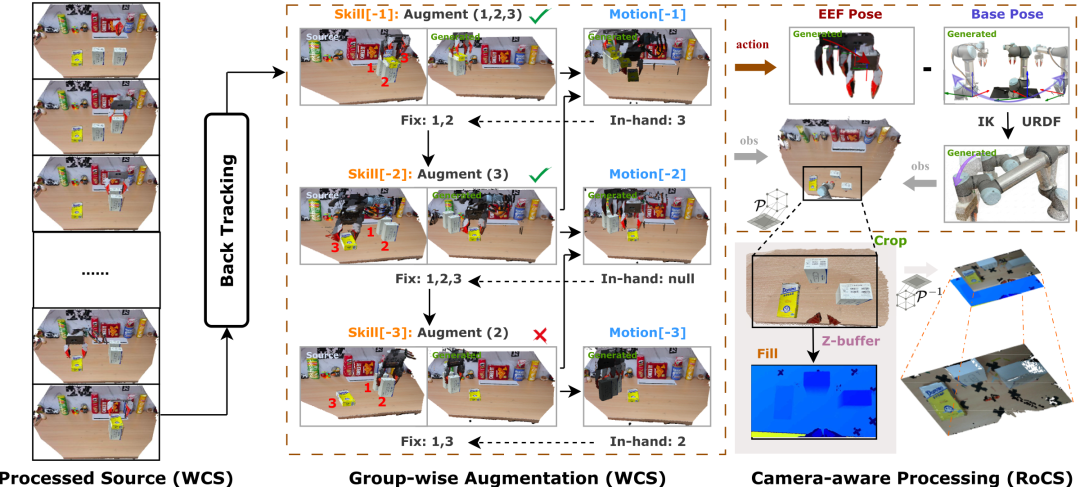
场景解析:使用基于模板的 3D 物体跟踪系统 FoundationPose,从首帧物体掩码出发,输出每帧 K 个物体的完整点云——即对 RGB-D 天然缺失的背面也进行几何补全;环境点云通过手持扫描预先获得,机器人手臂点云通过 URDF + 关节角度合成。完整几何是支撑大幅空间增强的前提。
轨迹解析:通过一个轻量标注界面,每条演示不到 60 秒即可完成 skill 起止帧与该技能对应的 target / in-hand 物体 ID 的标注;技能段之间的轨迹自动归类为 motion 段,便于后续用运动规划重生成。
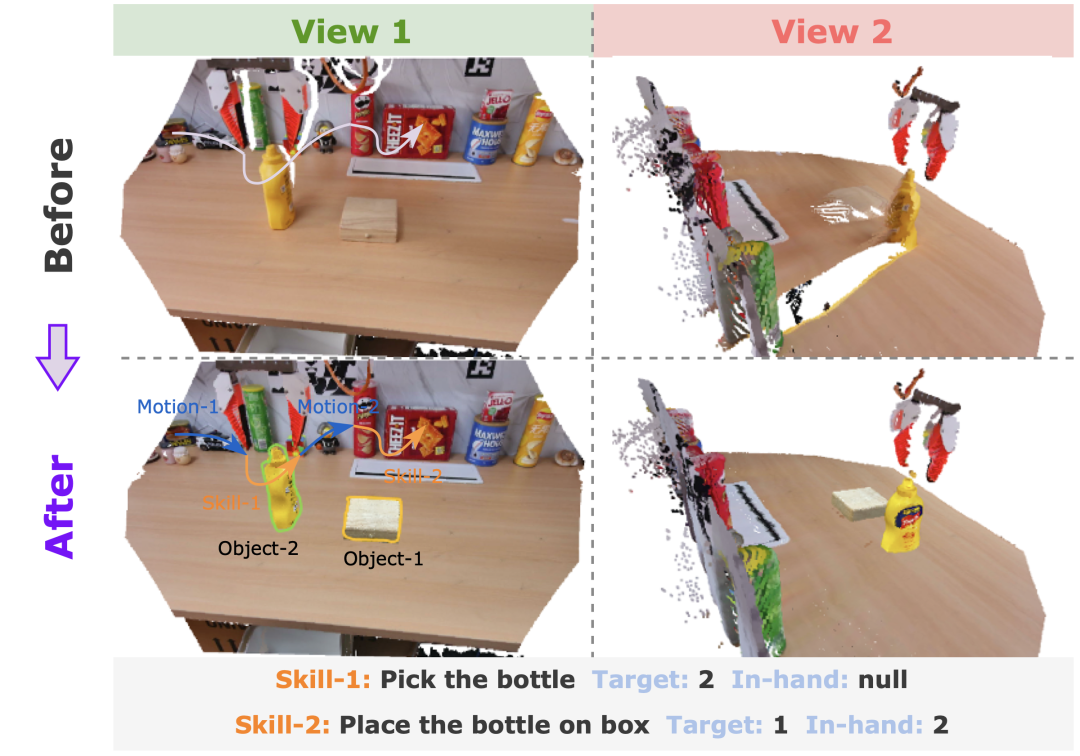
2. Group-wise 回溯增强:支持任意物体数量与空间耦合
先前方法是object-centric的:每个技能只能对应一个目标,全段轨迹按该目标的变换做单刚体变换。但像"build a bridge",先放两个桥墩、再把桥面盖上,这类任务要求桥面 object-3 落下时两个桥墩 object-1、object-2 保持特定相对距离——独立增强会破坏这种空间耦合。
R2RGen 改成group-wise:每个技能绑定一组物体,即 target 与 in-hand 的并集,组内施加同一个 XY 平移 + Z 轴旋转变换,从最后一个技能反向回溯到第一个。
每次决定是否能增强当前组前,与已“固定”集合取交集——若非空,则该组锁定不动,保证已分配的空间约束不被后续步骤破坏;in-hand 物体在被抓之前与当前技能无关,因此可以从固定集合中释放回可增强状态。
技能段内部同步变换末端轨迹与目标点云;技能间的 motion 段通过 motion planning 重新规划;此外,底盘位姿也可被增强——通过 IK 求解器 + URDF 重生成新的手臂点云,从而模拟视角变化。
3. Camera-aware 后处理:让生成点云匹配真实 RGB-D 分布
WCS 中的增强点云存在两个偏差:过完整,即每个表面都被填满,而真实 RGB-D 只能看到正对相机的那一面;以及视角偏移,即底盘增强后投影范围漂出图像。R2RGen 用一套 camera-aware 后处理把分布拉回真实传感器:
Crop:投影到图像平面并裁掉越界像素;
Patch-wise Z-buffer:在 r 邻域内仅保留最浅深度的点,有效遮挡背面,针对点云密度不高的真实场景;
Fill:通过裁剪图像尺寸或扩展环境点云填补由于增强造成的边缘空洞。
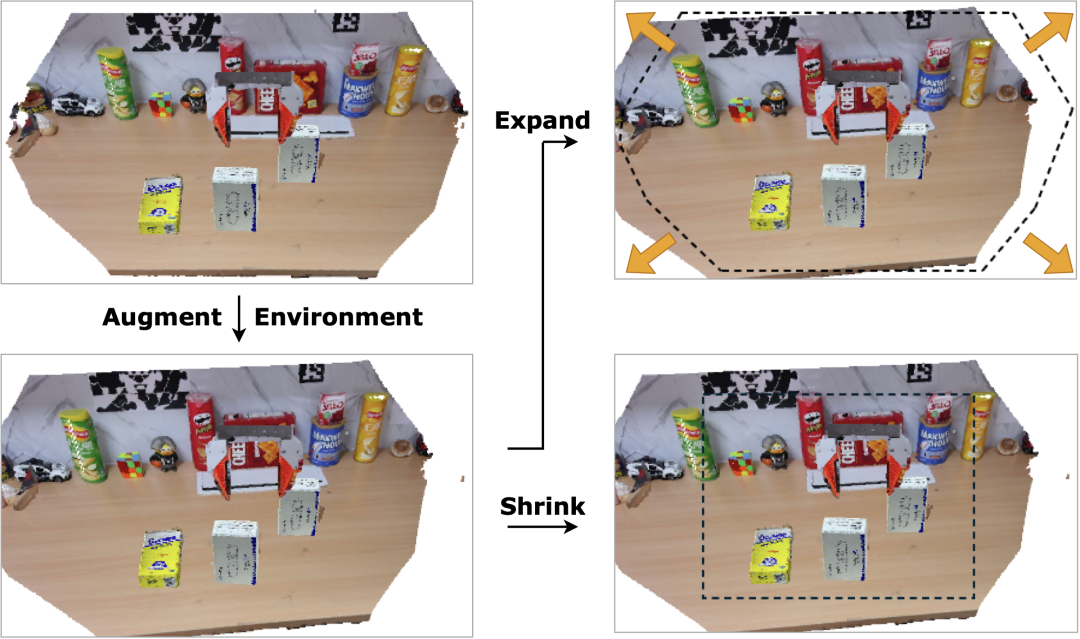
后处理后的点云在分布上与真实 RGB-D 几乎一致,可直接喂给 3D 策略 iDP3 训练,完全无需 sim-to-real 适配。
实验验证:性能与优势
1. 单次演示模仿学习
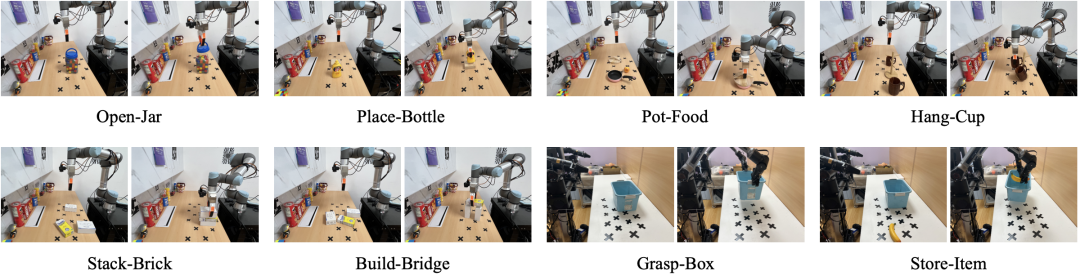
在 8 个代表性真实任务上——2 个简单、4 个复杂单臂、2 个双臂——仅用1 条人类演示经 R2RGen 生成数据训练的 iDP3 策略,平均成功率达到40.3%:
DemoGen 在复杂耦合任务上无法生成合理数据,而 R2RGen 在所有 8 项任务上都显著超过 DemoGen,且 1 条演示的效果就已与 25 条人类演示训练持平,在多个困难任务上甚至超过 40 条演示。
2. 跨相机配置:外置↔腕部自由切换
在“训练用外置、部署用腕部”以及“训练用腕部、部署用腕部”两种设置下,直接训测错配会产生灾难性失败,成功率接近 0。R2RGen 借助世界坐标系与相机坐标系之间的 3D 坐标变换天然消除域差,1 条演示即可拿到28–50%的成功率——印证了“在 3D 空间统一处理观测与动作”相比“在 2D 图像空间渲染”在跨视角部署上的根本优势。
3. 移动操作落地
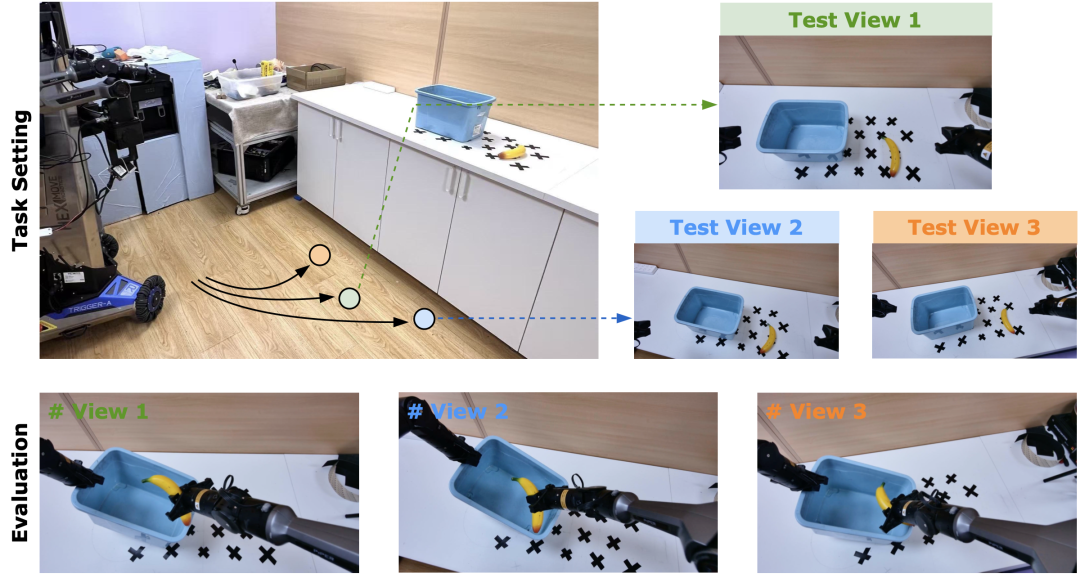
R2RGen 训练出的 iDP3 策略可直接与导航系统 Moto 拼接构成完整移动操作流水线,即便底盘停靠点距离误差超过5cm,策略仍能稳定完成任务。相比之下,DemoGen 依赖精确相机标定与背景裁剪,难以在移动场景中工作。
4. 性能-标注曲线与外观泛化
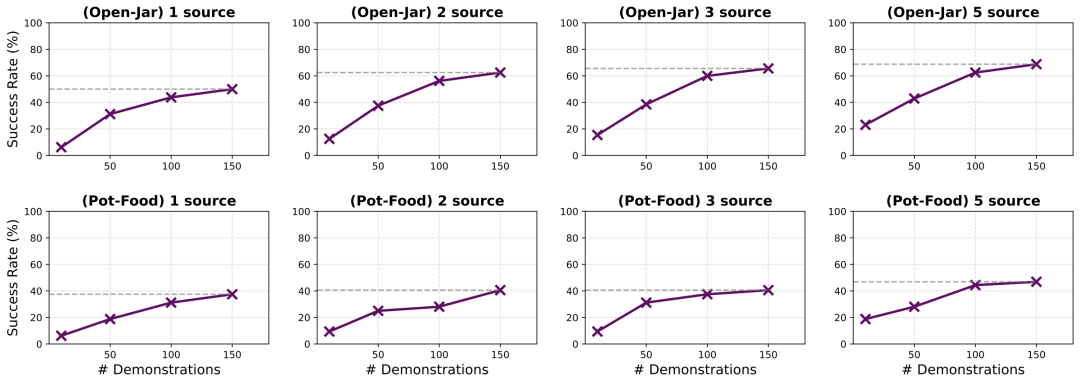
随着生成数据量增加,策略性能逐步饱和,主要受 iDP3 的 PointNet 编码器容量限制;增加源演示数量会进一步抬升饱和上限,验证了 R2RGen 的可扩展性。
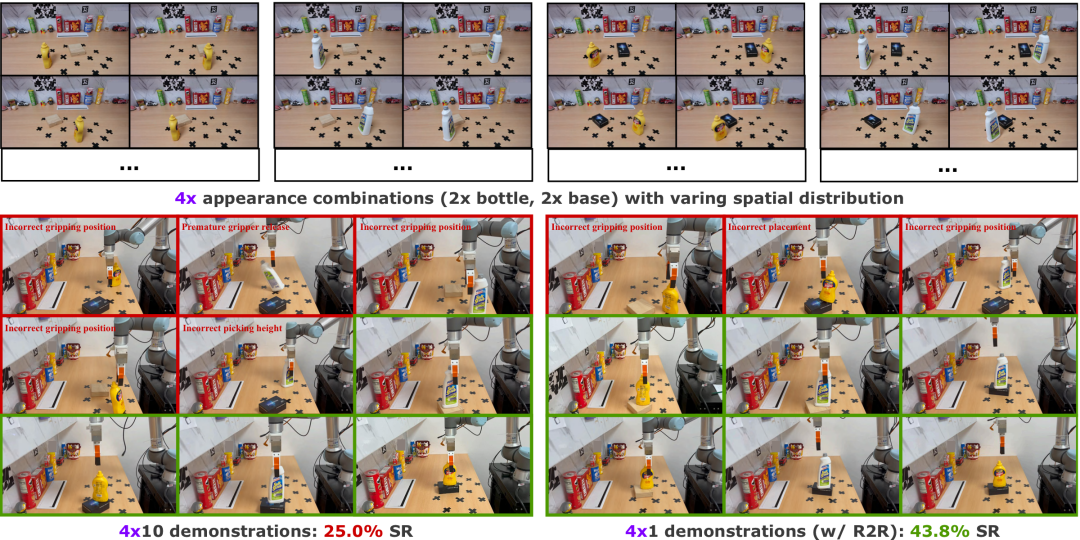
在 2×2 外观组合,即 2 种瓶子 × 2 种底座的 Place-Bottle 任务上,传统 4×10=40 条人类演示仅获 25.0%, R2RGen 用 4×1=4 条演示就达到43.8%——空间泛化作为基础能力,可显著降低同时获得外观泛化所需的数据量。
5. 非刚体扩展:与 SAM 3D 结合
借助 SAM 3D 作为统一的 3D 形状重建模型,替代仅支持刚体的 FoundationPose,R2RGen 可无缝扩展到铰链物体 Store-Box 与可形变物体 Cover-Object 两类任务,1 条演示分别取得31.3% / 53.1%的成功率,已逼近 40 条人类演示。
总结
R2RGen 走出了一条“少数据、强泛化”的新路径:不依赖仿真器堆叠、不依赖大模型先验,而是通过在真实 3D 空间中直接编辑观测与动作,再以 camera-aware 后处理把数据重新装回 3D 传感器的真实分布。它首次让 real-to-real 数据生成同时支持移动底盘、多相机配置、任意数量物体、复杂物体耦合与非刚体,是面向真实部署的可扩展数据范式。我们期待 R2RGen 为机器人操作的端到端可扩展学习提供一个新的范式起点,欢迎社区基于此进一步探索外观与任务两个维度的泛化。
公司核心团队包括清华、北大、中科院、中科大、WashU、CMU等全球知名院校顶尖研究人员,以及来自微软、三星、地平线、百度、博世等全球知名企业高管,核心团队在物理AI方向兼具业内领先的研究能力和大规模的产业落地经验。
极佳视界是国内第一家布局世界模型的科技公司,以世界模型平台 GigaWorld、通用具身大脑 GigaBrain、原生本体 Maker 构建闭环生态,致力实现10-100倍以上的数据、训练、测试全链路效率提升,推动通用具身智能机器人、通用自动驾驶等物理AGI大规模爆发。
原文链接: https://www.leiphone.com/category/private/4azSqpAvFKeLUBgD.html
