Logo
Loading...
期刊
专家
顶会专区
告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026
GAIR DAO 2026-10-16


来源:多模态信息融合

文章链接:https://mp.weixin.qq.com/s/-He-TQ62-1eyHUj2Waq2pg

PAPER READING

告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026
ACM MM 2026 · RGBT OBJECT DETECTION


本文所要解决的问题是RGBT融合中一个非常具体的问题:两种模态都很好用,但是把它们以全分辨率的方式混合在一起,那么背景也会被一起传播。
ProtoHGF-Net 先用单模态教师生成目标感知掩码,做融合前校准;然后把RGB/Thermal特征压成语义原型,在稀疏超图上完成跨模态交互。
最后,原型交互的结果被调制回全分辨率特征,并且由全局门控来决定两种模态所起的作用。


告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026


01
先校准,再融合
CALIBRATE FIRST, THEN FUSE
告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026


告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026
整体框架、视觉锚点


真正需要解决的
并不是“融合的程度够不够”
而是在于“哪些信息应该被融合进去”
告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026


核心信息


论文标题:ProtoHGF-Net: Prototype HyperGraph Fusion with Intra-modal Calibration for RGBT Object Detection
作者:Xiangqi Chen, Xiuling Zhang, Chengzhuan Yang, Li Zhao, Dawei Zhang, Yanchao Wang, Liyuan Chen*, Hua Wang, Hao Peng, Zhonglong Zheng
单位:浙江师范大学;国防科技大学;Victoria University
论文链接:

https://arxiv.org/abs/2608.11595

代码链接:

https://github.com/ZiMo-Chen/ProtoHGF

告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026
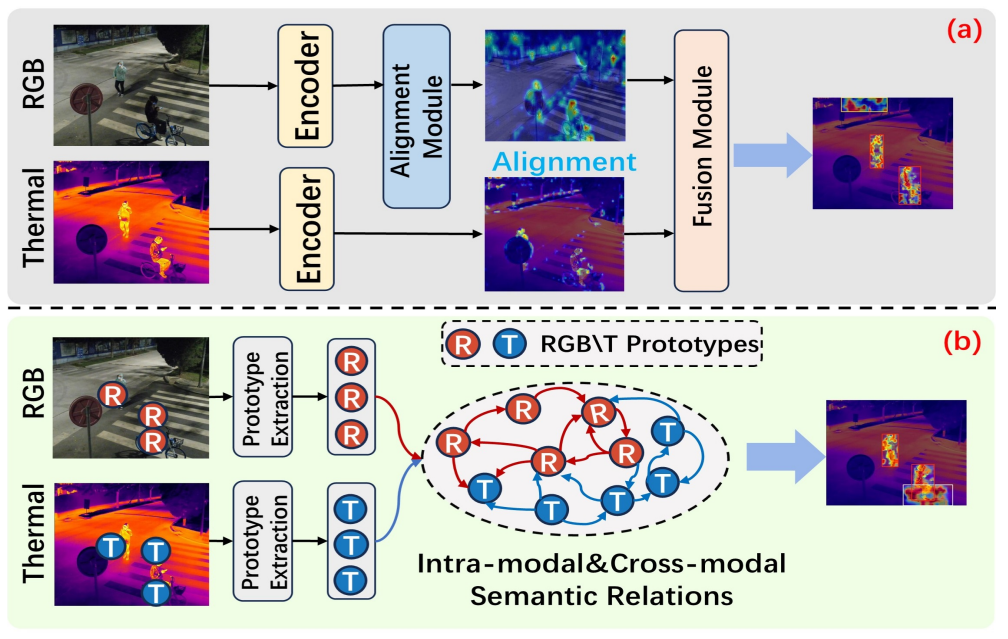
密集全分辨率交互 vs. prototype级别的交互
告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026
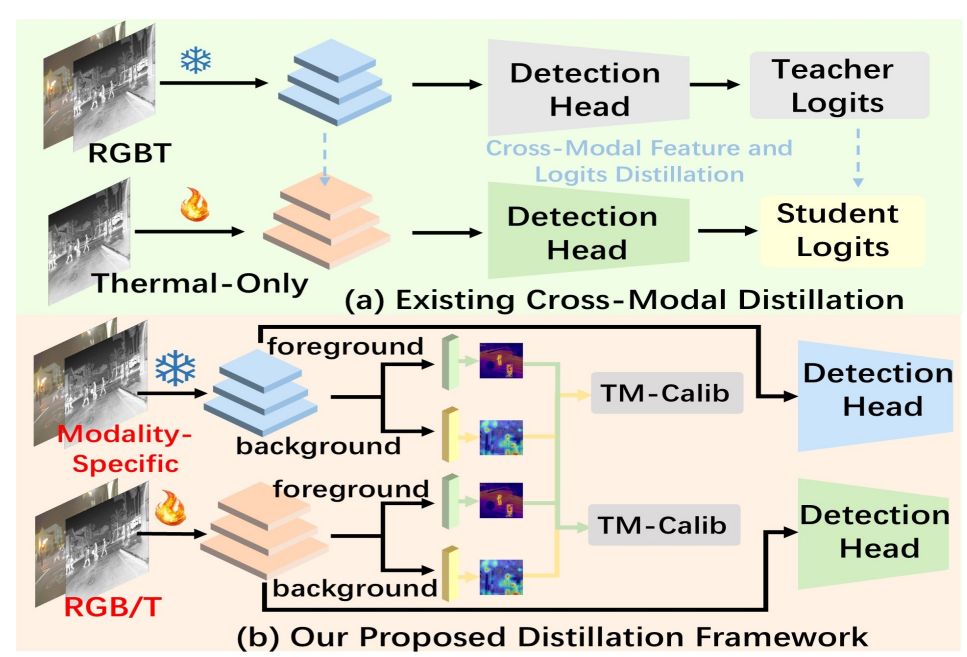
融合之后教师蒸馏 vs. TM-Calib 融合前校准


01.
为什么全分辨率融合容易把背景噪声一并带进去?


目标区域一般只占据特征图中很小的一块。如果RGB和Thermal在H×W的空间中直接密集地交互,大量的无关背景也会参与到信息传播当中来,并且还会产生一种不稳定性的跨模态干扰。论文认为现有的密集交互更善于进行“广泛融合”,但是缺乏对于目标信息相关部分的选择性聚合。


02.
论文把该问题分为了哪两部分?


TM-Calib:使用RGB-only和Thermal-only教师分别生成目标感知mask,在融合之前加强前景、抑制背景;
ProtoHG-Fusion:把每一个模态都压缩成少数几个语义prototype,在prototype的空间中进行稀疏超图传播。


02
由原来的六个原型,发展成为稀疏超图
PROTOTYPES TO HYPERGRAPH
告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026


告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026
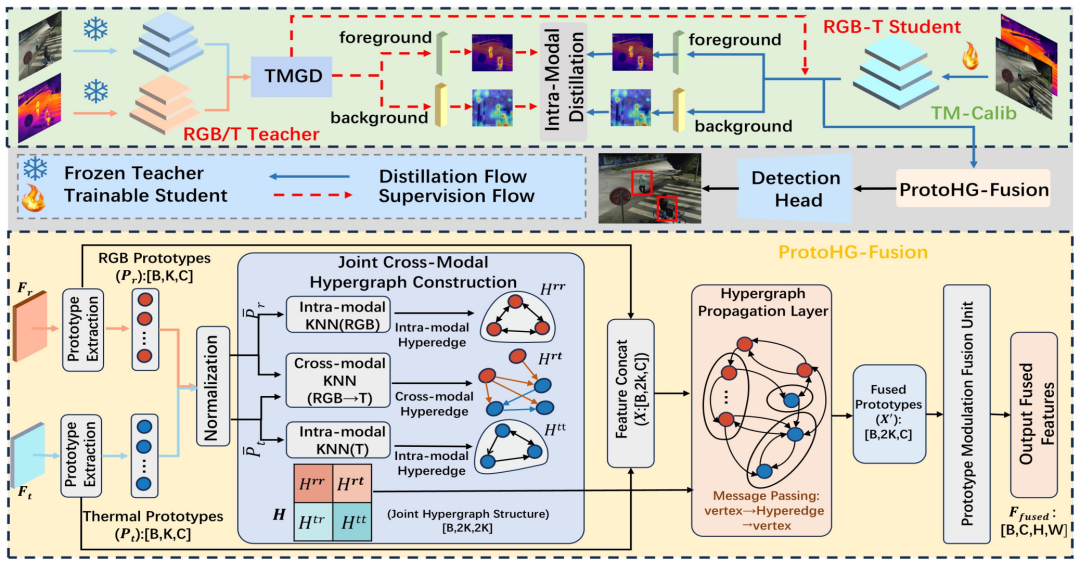
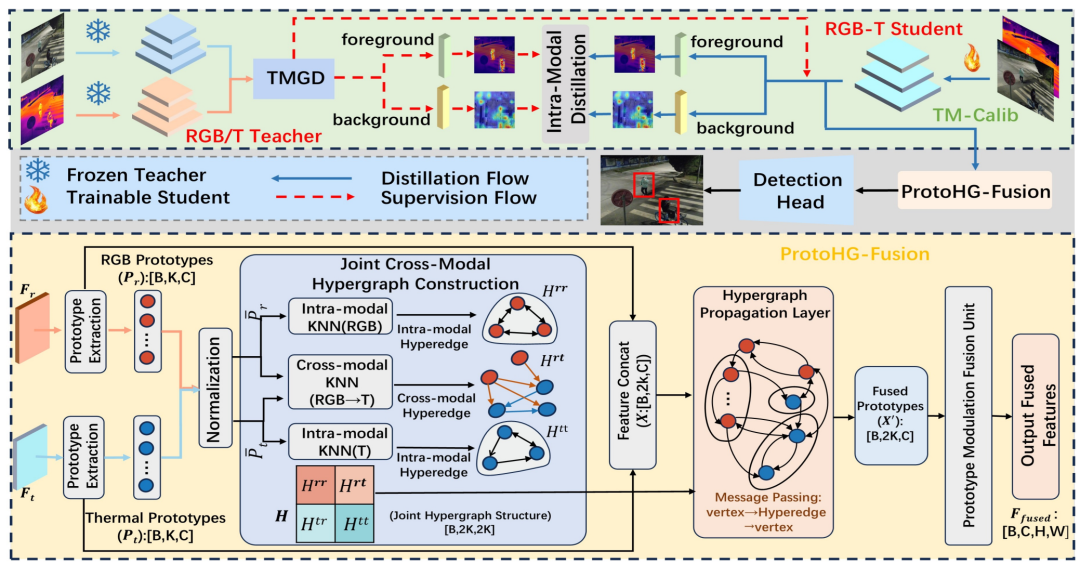
ProtoHGF-Net 的总体结构,TMGD 为教师掩码引导分解


把跨模态交互搬移到较小的
语义空间,才可以有选择地去传播


方法细究


ProtoHG-Fusion:双分支YOLOv8m在提取出各个模态的多尺度特征之后,每个模态默认抽取K=6个语义原型;
关系建模:首先进行模态内的KNN,然后进行RGB↔Thermal跨模态KNN,k_intra=k_cross=3,形成2K×2K联合关系矩阵;
传播方式:沿着“vertex → hyperedge → vertex”的过程进行两步归一化聚合,然后用残差来保留原始语义;
回写特征:原型交互结果生成通道调制参数,最后通过全局 Softmax 门控得到 RGB/Thermal 融合权重。
告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026
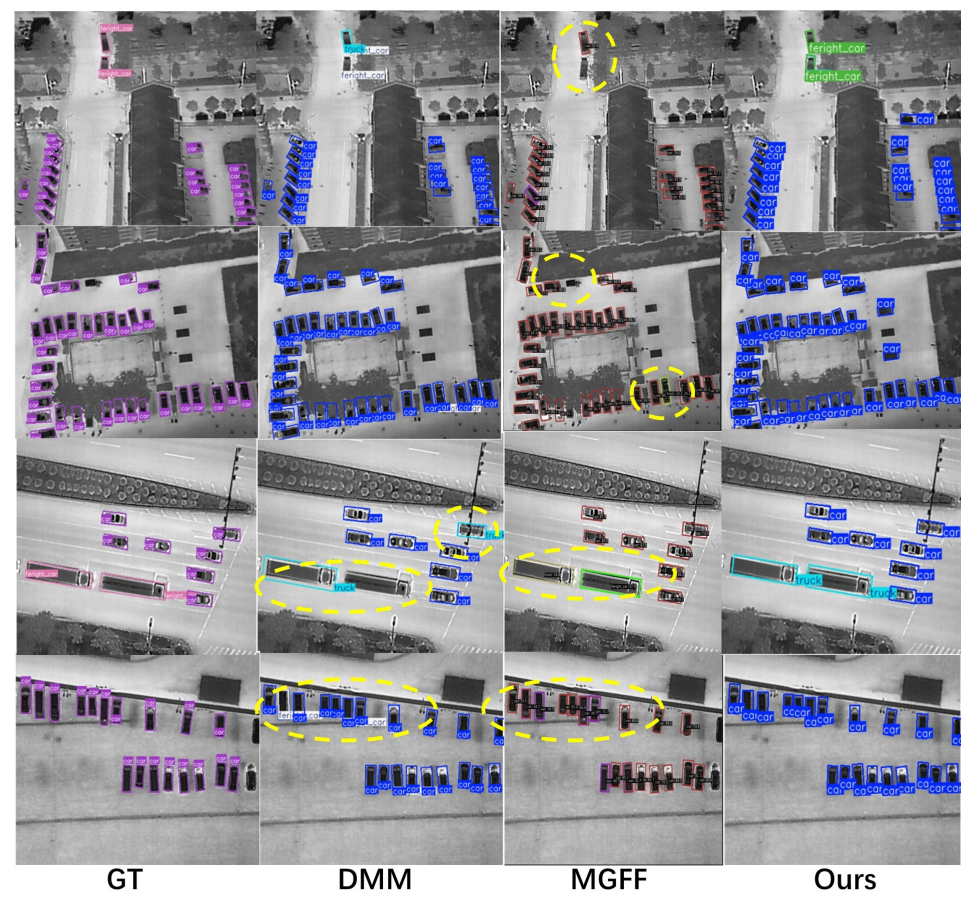
不同的检测结果用黄虚线表示检测错误
告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026
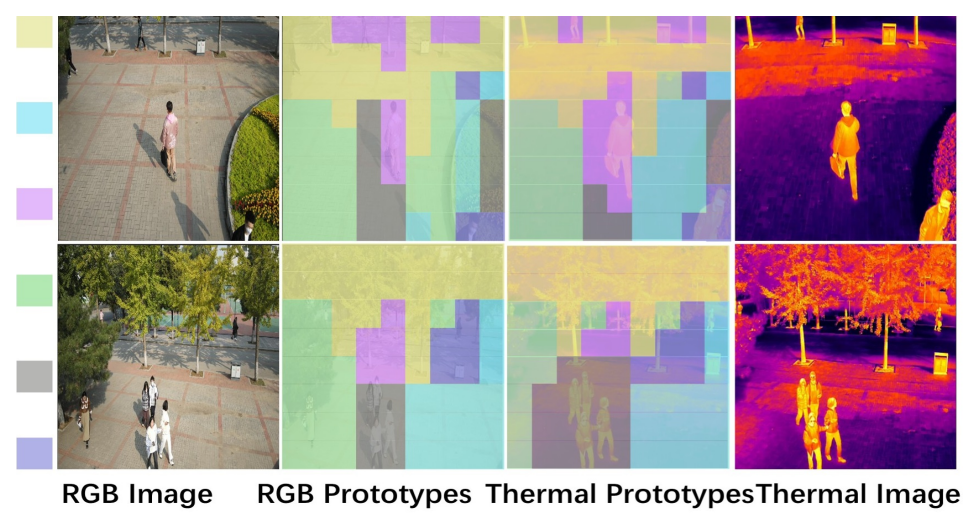
不同的semantic prototype的attention map


ProtoHG-Fusion 如何将像素级融合改为原型级交互?


① 原型提取。使用K个attention map在空间维度上进行Softmax操作,将H×W个位置压缩成K个语义节点。
② 关系矩阵。把RGB和Thermal的2K个原型拼在一起,关系矩阵H同时编码模态内的邻域以及跨模态的对应关系。

③ 回写特征。经过传播之后的 prototype 被展开了 z_m,生成了通道级 γ_m、β_m,对原始特征进行调制,然后用全局门控来选择两种模态的贡献。


TM-Calib 如何防止把背景也蒸馏进去?


首先生成目标感知mask。RGB-only/Thermal-only 教师分别提供通道注意力和空间注意力,在经过轻量级的 1×1 refinement 后得到联合 mask。
再把前景和背景分开。同一个mask同时作用在teacher和student上,把特征分成了foreground/background两部分;然后进行前景对齐、背景抑制以及前景-背景解耦。


告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026
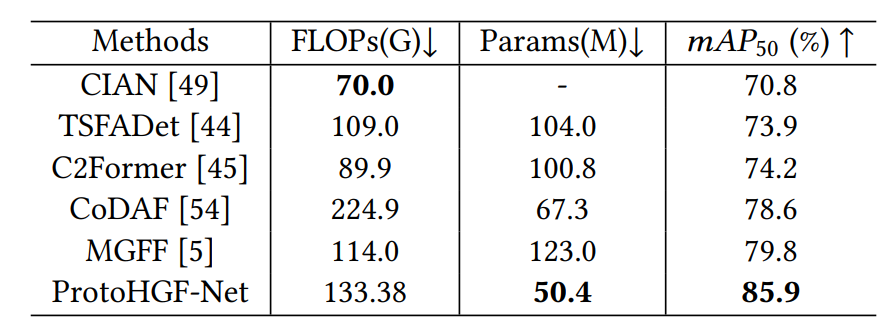
计算量、参数量和mAP50之间的比较


DroneVehicle:85.9% mAP50

相比无人机D(UAVD)的83.0%,提高了2.9个百分点;DVTOD:88.2%,mAP50:88.2%相比于CMX提高了6.6个百分点。
FLIR:79.1% mAP50略低于表格中的LRAF-Net和CMX;但是总的mAP达到了45.1%,比LRAF-Net的42.8%高了2.3个百分点,比CMX的41.4%高了3.7个百分点。
消融验证:DVTOD 同时加入两个模块之后可以达到 88.2/56.1,DroneVehicle 达到 85.9/56.5;硬 0/1 top-k 关系也比 soft-relation 好。

效率:133.38GFLOPS、50.4M参数,在表8对比中得到最高的85.9%mAP50。


总结展望
这篇论文真正改变的是“融合模块有多复杂”,而不再是把交互粒度从H×W个空间位置改为2K个语义节点,并且把背景清理放在融合之前。作者接下来打算把范围扩大到多光谱以及带有时间一致性视频检测上。


END
告别密集交互!ProtoHGF-Net:基于原型超图的RGBT目标检测新范式|ACM MM 2026