


原文作者:公众号“为机器立心”
原文链接:https://mp.weixin.qq.com/s/ZkUNbTfyXY5-zMRpiJxdQg
大语言模型已广泛落地代码生成场景,但模型训练数据包含海量开源漏洞代码,导致其天生会复刻漏洞(如SQL注入、缓冲区溢出、不安全函数调用等)。这类漏洞往往由单个Token/单行代码的局部错误引发,并非整段代码逻辑问题,对工程安全构成严重威胁。
目前主流的代码模型对齐手段(SFT监督微调、RL强化学习)均为序列级粗粒度优化,无法适配代码漏洞“局部触发”的特性,三大硬伤尤为突出:
设计一种细粒度、自驱动、高泛化的训练框架:
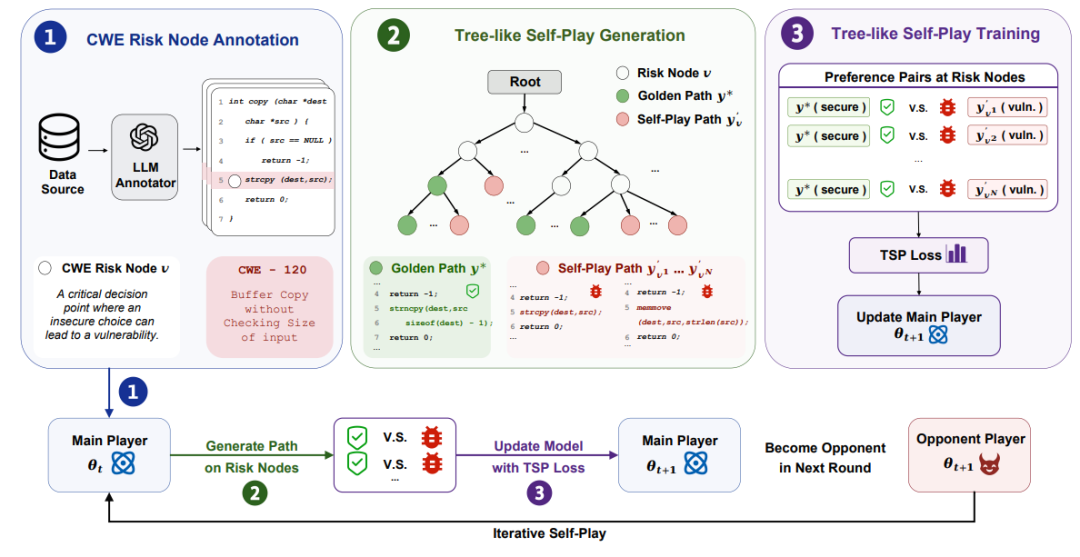
论文提出一系列专属概念,是理解TSP的基础:
TSP 是一套迭代式自我博弈+节点级对比学习的训练范式,整体分为三大流程:风险节点标注、树状自我博弈生成、节点级训练更新,同时配套专属损失函数与迭代机制。
完整训练循环为迭代闭环,每一轮包含3步:
基于开源数据集DiverseVul(包含150类CWE、近20万条C/C++代码),筛选出1353条修复后的安全代码作为基准,规避原始漏洞数据集标签噪声问题。
摒弃人工标注,使用专用标注LLM完成风险节点提取,严格遵循三条规则:
论文先从数学层面论证SFT、RL的不足,再引出TSP优化目标:
TSP将模型拆分为两个角色(同源模型),实现纯自驱动对抗学习,无需外部数据:
对每一条安全代码(黄金路径),遍历其所有风险节点:
优势:正负样本前缀完全一致,仅在风险节点分叉,学习信号高度聚焦,彻底解决传统样本上下文差异大的问题。
TSP放弃全局序列优化,仅对风险节点计算损失,分层聚合所有节点误差:
一轮迭代完整流程:
该机制让模型持续和“过去的自己”博弈,不断修正越来越隐蔽的漏洞,形成渐进式自进化。
论文从梯度角度证明TSP的优越性:
以CodeLlama-7B为例,核心数据如下:
关键结论:
该结论在Qwen2.5-Coder系列模型上完全复现,证明TSP具备模型通用性。
仅使用C/C++安全数据训练模型,在Python/Go/JS/Ruby多语言场景测试:
测试模型对训练集从未出现的漏洞类型的防御能力:
本质区别:SFT是“记忆漏洞补丁”,TSP是“理解安全规则”。
TSP 并非全能,存在明确短板,也是未来研究方向:
总结四大核心创新点:
这篇ICML 2026论文提出的TSP树状自我博弈框架,精准击中了当前代码大模型安全加固的核心痛点:粗粒度优化、数据依赖、泛化薄弱。其核心思想可概括为“让模型在犯错的地方纠正错误”:将代码生成拆解为树状决策节点,定位漏洞触发点,通过模型自我博弈生成漏洞样本,在节点层级做细粒度对比学习。
实验充分证明,TSP在安全通过率、漏洞削减上全面超越SFT、传统RL、普通自我博弈等基线,同时保留模型原有编码能力,且习得可跨语言、跨未知漏洞的通用安全逻辑。尽管在长链路隐式漏洞、动态节点识别上存在局限,但它开辟了“自纠错+细粒度节点对齐”的全新技术路线,是代码大模型安全领域兼具理论创新与工程实用性的优秀工作。
