


来源:智驾具身数字挖掘
原文链接:https://mp.weixin.qq.com/s/x1ybQksLJO4iZONiEmHqQw
作者 | Yuan Gao、Wenting Miao、Mattia Piccinini、Haoyu Wang、Qunying Song、Johannes Betz
机构 | 慕尼黑工业大学 TUM、慕尼黑机器人与机器智能研究所 MIRMI、伦敦大学学院 UCL
论文 | Chat2Scenic: An Iterative RAG-Based Framework for Scenario Generation in Autonomous Driving
版本 | arXiv:2607.14387v1(2026 年 7 月 15 日)/ IEEE IROS 2026
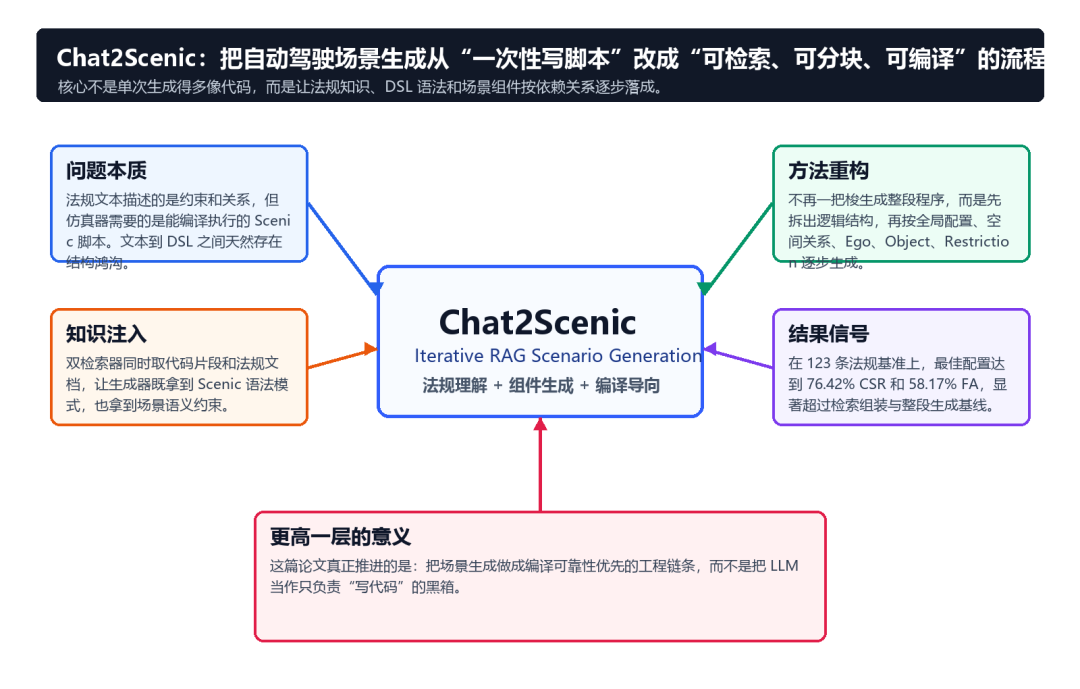
01 这篇论文真正解决的,不是“能不能写代码”,而是“能不能稳定写出可执行场景”
自动驾驶场景生成一直有一个很实际的落差:法规、测试规范和工程师的需求,通常都以自然语言出现;但仿真器真正需要的,却是能编译、能运行、能复用的 DSL 脚本。
如果只从“把文本翻译成代码”这个角度看,这件事像是一个普通的 code generation 任务。但 Chat2Scenic 的判断更到位:场景生成的核心矛盾不是语法表达,而是如何同时兼顾可编译性、可控性和对复杂法规描述的泛化能力。
既有路线大致分成两类:
-
检索组装式方法
:先从库里找现成 DSL 片段,再拼成场景; -
整段生成式方法
:让大模型直接写完整 Scenic 程序。
前者通常更容易编译,但很依赖已有模板库;后者更灵活,却很容易在复杂约束下生成出不能执行的程序。Chat2Scenic 的贡献,就是把这两条路线重构成一条新的中间路线:先把场景拆成可控组件,再让检索增强的生成器按依赖关系逐步落成。
02 资源与开源状态
论文页:https://arxiv.org/abs/2607.14387 DOI:10.48550/arXiv.2607.14387 官方代码仓库:https://github.com/TUM-AVS/chat2scenic 开源状态:截至 2026 年 7 月 17 日,作者提供的 GitHub 仓库链接可访问。
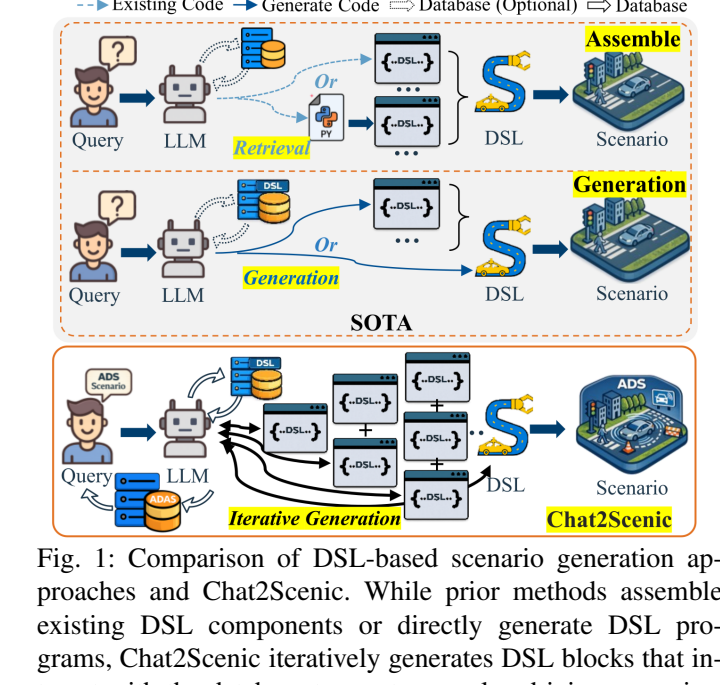 图 1:DSL 场景生成方法对比。既有方法要么组装已有 DSL 组件,要么直接生成完整 DSL 程序;Chat2Scenic 则迭代生成可与数据库交互的 DSL 模块,以构造更复杂的驾驶场景。
03 Chat2Scenic 的方法论变化:把“整段生成”改成“逐块编译”
图 1 几乎已经把本文的中心思想说完了。传统检索组装路线把问题理解成“从库里找现成零件”;整段生成路线把问题理解成“让模型从头写完整程序”。
而 Chat2Scenic 认为,两边都少了一层工程约束:复杂法规场景的生成,本质上是一个有依赖关系的程序构造过程。如果不显式处理依赖,整段生成就容易在后半段失去一致性;如果完全依赖现成模板,检索组装就很难泛化到新场景。
04 系统主线:用户描述先被结构化,再由 RAG 驱动组件生成
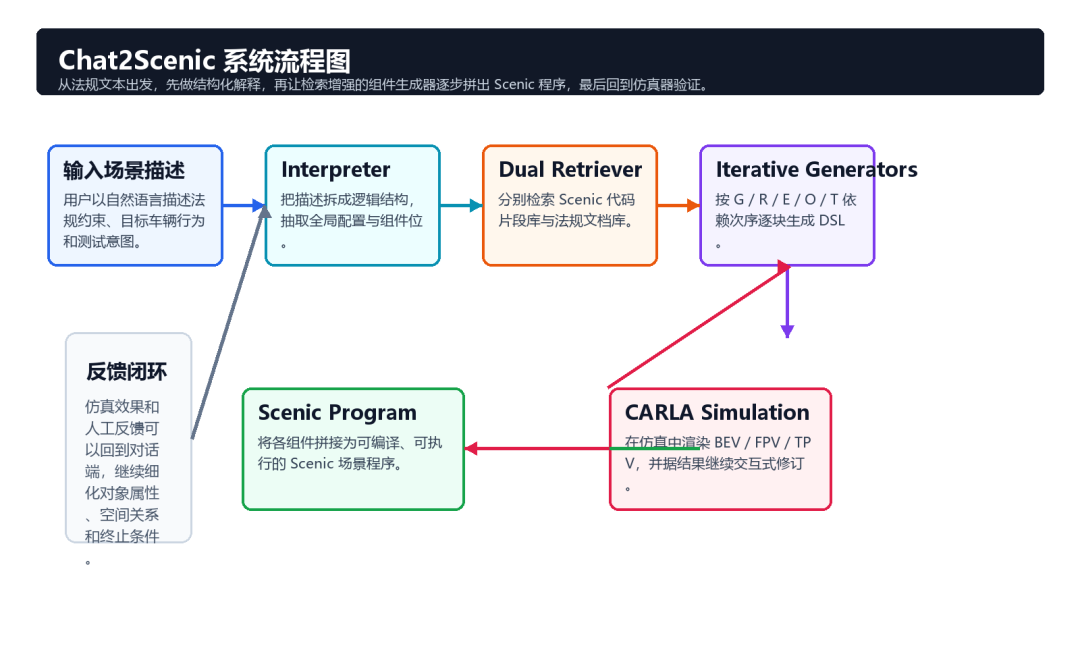
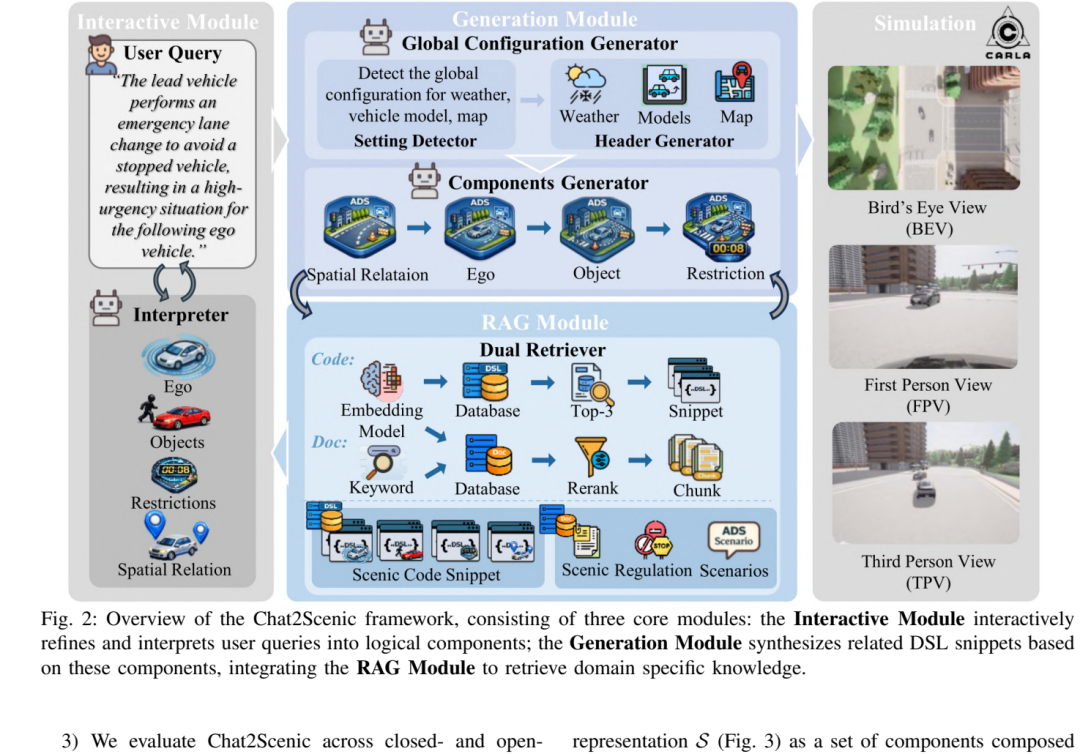 图 2:Chat2Scenic 总体框架,由 Interactive Module、Generation Module 和 RAG Module 三部分组成:前者负责交互式细化与解析用户查询,后两者负责结合领域知识生成 Scenic DSL 场景。
从系统角度看,Chat2Scenic 由三部分组成:
1. Interactive Module:把用户的自然语言请求转成逻辑组件,并支持多轮反馈修订;
2. RAG Module:同时检索 Scenic 代码片段库和法规文档库;
3. Generation Module:按依赖次序生成全局配置和各个 DSL 组件,最终拼成完整 Scenic 程序。
这套设计非常像一个为 DSL 场景生成量身定制的“轻型编译前端”:先做场景语义解析,再做知识补全,最后做逐组件代码合成。相比直接把一大段法规文本扔给 LLM,这种结构化流程能显著减少后续生成时的约束冲突。
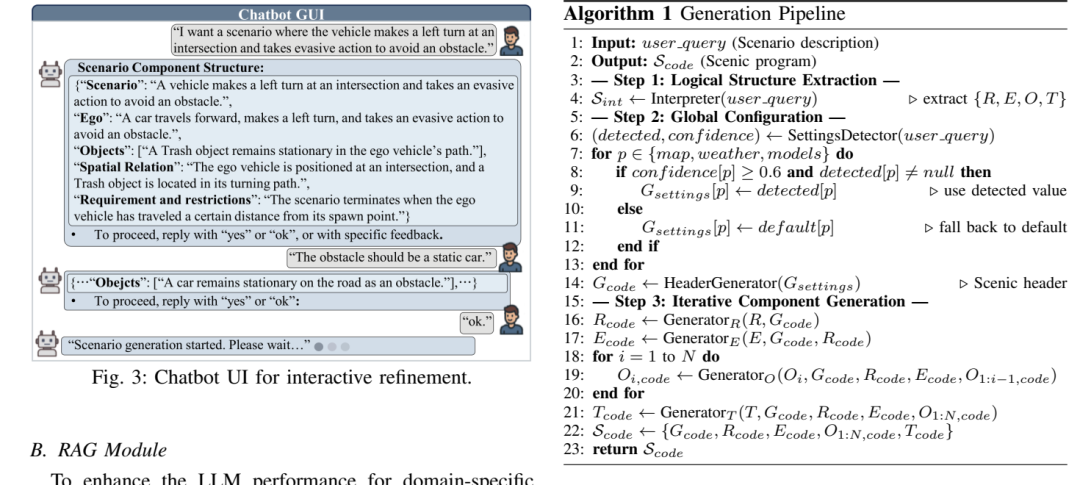 图 3 / 算法 1:用于交互式细化的聊天界面,以及从用户场景描述到 Scenic 程序的生成流程。
05 为什么“交互式 + 组件式”是关键
算法 1 给出了整个生成过程的骨架。系统先从用户描述中抽出场景逻辑结构,再把它表示成全局配置 G 与场景组件 S_int = {R, E, O, T} 的集合:
-
R:Spatial Relation,空间关系与道路拓扑; -
E:Ego,主车行为与参数; -
O:Objects,其他参与体; -
T:Restrictions,终止条件和约束。
之后,生成器不是一次吐出整个 Scenic 程序,而是先生成全局配置,再依次生成 R → E → O → T。每一步都能看到已确定的上下文,因此后续组件不必从零猜测前文到底写了什么。
同时,图 3 里的聊天界面也揭示了另一个现实价值:很多测试场景并不是一条 prompt 就能说清,而是需要随着对象属性、静态障碍、终止条件的补充细化逐轮完善。Chat2Scenic 把这种人工修订当成系统能力的一部分,而不是系统失败后的补丁。
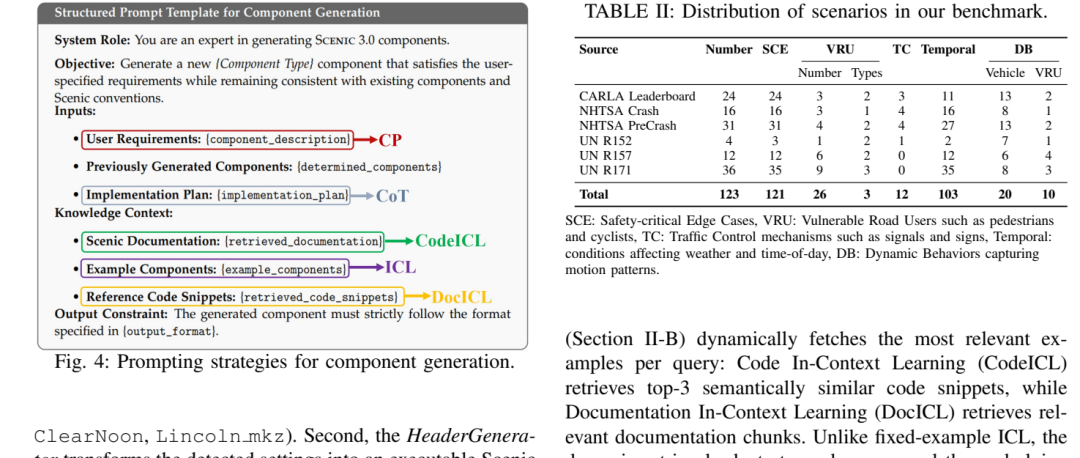 图 4 / 表 2:组件生成的结构化提示策略,以及 123 条基准场景在不同来源和场景类型上的分布。
06 作者并不只是“多试几个 prompt”,而是在系统性地设计生成条件
图 4 左侧展示了作者如何组织组件生成提示。几类提示技术分别扮演不同角色:
-
CP(Contextual Prompting)
:把领域知识、语法约束和层级类型系统显式写进提示; -
CoT(Chain-of-Thought)
:要求模型按理解需求、选类型、定参数、定行为、再验证的顺序推理; -
ICL(In-Context Learning)
:给出少量正确示例; -
CodeICL
:动态检索最相似的 Scenic 代码片段; -
DocICL
:动态检索法规文档片段。
图右的 Table II 则说明,作者不是在玩一个很小的 demo benchmark。他们整理了 123 条场景规范,来源覆盖:CARLA Leaderboard(24 条)、NHTSA Crash/PreCrash(47 条)以及 UN R152 / R157 / R171(52 条)。
这些场景还被按安全关键边缘案例、弱势交通参与者、交通控制、时序条件和动态行为等维度分层。也就是说,作者评价的不是“脚本写得像不像”,而是系统能否覆盖真实法规语境中的多类约束。
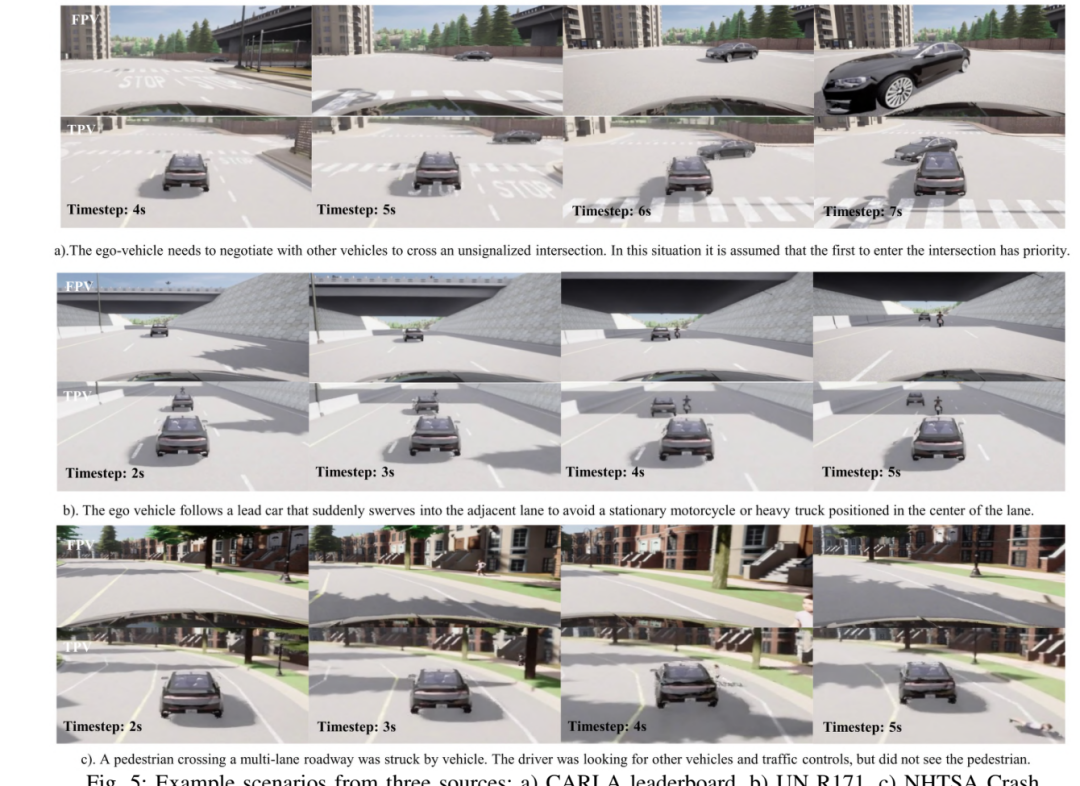 图 5:来自三个来源的示例场景:a) CARLA Leaderboard,b) UN R171,c) NHTSA Crash。
07 这套 benchmark 为什么有意义
图 5 给出的三个例子很能说明问题:无信号交叉口协商通行、前车突然绕开静止障碍物、以及多车道行人碰撞场景。这些都不是一句“让主车向前开”能描述清楚的简单脚本,而是同时涉及道路关系、相对位置、行为时序和终止条件的复合场景。
也正因为这样,作者把框架指标拆成两层:
-
CSR(Compilation Success Rate)
:生成出来的 Scenic 程序能否成功编译执行; -
FA(Framework Accuracy)
:在能执行的前提下,语义层面到底有多贴合原始描述。
这个评价方式很合理。因为对场景生成来说,不能运行的高语义质量脚本其实没有工程价值;能运行但语义偏掉的脚本,同样不能直接用于验证。
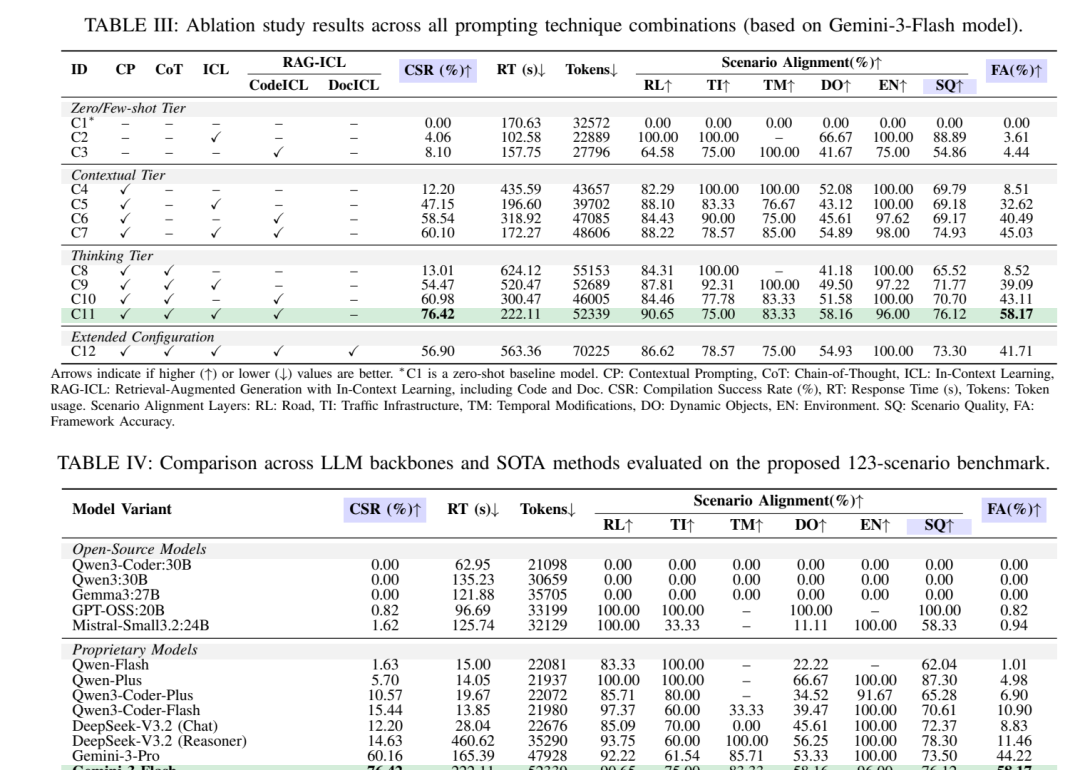 表 3 / 表 4:不同提示技术组合的消融结果,以及不同 LLM 骨干与现有方法在 123 场景基准上的对比结果。
08 主结果怎么读:最强信号不只是“更准”,而是“终于兼顾了可编译性和语义对齐”
先看 Table III 的提示技术消融。作者给出的最优配置 C11 = CP + CoT + ICL + CodeICL,达到了:
CSR = 76.42%SQ = 76.12%FA = 58.17%RT = 222.11s
这组结果的重要性在于,它不是靠某一个单点技巧突然爆出来的,而是沿着“上下文约束 → 推理分解 → 示例补全 → 代码检索”逐级叠加出来的。
具体来看:
零样本基线 C1:CSR 0.00% / FA 0.00%;仅加 CP 的 C4:CSR 12.20% / FA 8.51%;-
CP + ICL的 C5:CSR 47.15% / FA 32.62%; -
CP + CoT + ICL的 C9:CSR 54.47% / FA 39.09%; -
CP + CoT + ICL + CodeICL的 C11:CSR 76.42% / FA 58.17%。
C11 基础上继续加入 DocICL 得到 C12 时,指标反而退回 56.90% CSR / 41.71% FA。这说明对 DSL 程序生成来说,文档知识并不天然优于可执行代码模式,甚至可能引入额外噪声。再看 Table IV 的总对比,Chat2Scenic 的最佳配置在 123 场景基准上显著超过两类公开基线:
-
ChatScene(Retrieval Assemble)
: 30.08% CSR / 11.03% FA; -
NL2Scenic(Retrieval Generation)
: 16.26% CSR / 10.86% FA; -
Chat2Scenic 最佳配置
: 76.42% CSR / 58.17% FA。
和强商用模型相比,Gemini-3-Flash 是本文实验里的最优骨干,优于 Gemini-3-Pro(60.16% CSR / 44.22% FA)以及 DeepSeek-V3.2(Reasoner 模式 14.63% CSR / 11.46% FA)。而表中的开源模型大多接近零编译成功率,也进一步说明:这不是一个靠一般性语言能力就能轻松打穿的任务。
09 这篇论文更高一层的价值:把场景生成从“写程序”推进成“生成编译链条”
Chat2Scenic 的真正价值,在于它重新定义了自动驾驶场景生成任务。过去很多工作默认 LLM 的职责是“根据文本写脚本”;而这篇论文更像是在说:LLM 应该被放进一个带有解释、检索、依赖控制和仿真反馈的生成系统里。
从这个角度看,它提出的不是又一种 Scenic prompt,而是一套更接近工程现实的工作流:
先把场景描述拆成程序结构; 再让检索把代码模式和法规知识补齐; 然后按组件依赖顺序逐步生成; 最后把结果交给编译和仿真去兜底验证。
10 这篇论文的边界也要看清
-
响应时间不短。
最优配置 C11的平均生成时长是222.11秒,明显慢于简单检索组装路线; -
当前仍以文本输入为主。
作者在结论里明确把多模态输入(图像、草图)和 simulation-in-the-loop 反馈列为后续方向; -
文档检索并不总是有效。
DocICL在这套任务里并没有像直觉那样持续增益,说明法规知识如何被组织和注入,仍然是个开放问题; -
最佳结果依赖较强的闭源骨干。
从 Table IV 看,通用开源模型在当前协议下距离可用还有明显差距。
11 结论
Chat2Scenic 最值得记住的判断,有四个:
自动驾驶场景生成的核心难点,不是“能不能把文本写成代码”,而是“能不能稳定生成可编译、可对齐的 Scenic 程序”。
逐组件、按依赖关系迭代生成,比一次性生成整段脚本更适合复杂法规驱动场景。
RAG 在这里最有效的注入对象,不是泛化文档知识,而是和 DSL 真正贴身的代码模式。
这篇论文真正推进的是一条生成编译链条:解释、检索、生成、编译、仿真,而不是单纯的 prompt engineering。
如果把这篇论文压成一句话,它的意义在于:让自动驾驶场景生成第一次更像一个可落地的工程系统,而不只是一个“偶尔能写对 Scenic 程序”的大模型演示。
