


来源:JOJO极智算法
原文链接:https://mp\.weixin\.qq\.com/s/jaTHqU6Ts9BnDGYap2XcHw
具身智能(Embodied AI)的浪潮正在席卷千行百业,而视觉-语言-动作(VLA)模型无疑是当下最受瞩目的“机器大脑”。然而,当VLA模型试图从实验室的简单抓取走向真实世界的复杂应用时,立刻撞上了三堵高墙:硬件形态的异构性(如形形色色的机械手)、人类意图的复杂性(如个性化的驾驶习惯)、以及动态环境的不可测性(如瞬息万变的真实路况)。
针对这三大痛点,本文精选了来自CVPR 2026和ECCV 2026的三篇重磅论文(UniDex、Drive My Way、Uni-World VLA)。它们分别通过“构建统一动作空间”、“长短记忆偏好对齐”以及“预测与规划交替生成”三项突破性技术,从通用控制、个性化交互与闭环世界模型三个维度,共同勾勒出了下一代VLA大模型的进化路线图。
我整理了15篇“灵巧操作+自我中心视觉"相关论文(包括本章3篇论文),供大家学习了解这个方向,找到课题,挖掘创新点。

扫码回复
“灵巧操作+自我中心视觉"
免费领取&进交流群
UniDex: A Robot Foundation Suite for Universal Dexterous Hand Control from Egocentric Human Videos (CVPR 2026)
【亮点速览】
跨设备通用控制:针对目前VLA模型多局限于简单夹爪、难以适配形形色色灵巧手的痛点,提出首个面向多形态异构灵巧手(6-24自由度)的通用基础大模型套件UniDex。
海量人类视频转化:巧妙利用第一人称(Egocentric)人类日常活动视频,通过自动化+人机在环(Human-in-the-loop)重定向技术,将其转化为超过5万条可供机器人学习的3D数据轨迹,打破了真实机器人数据匮乏的瓶颈。
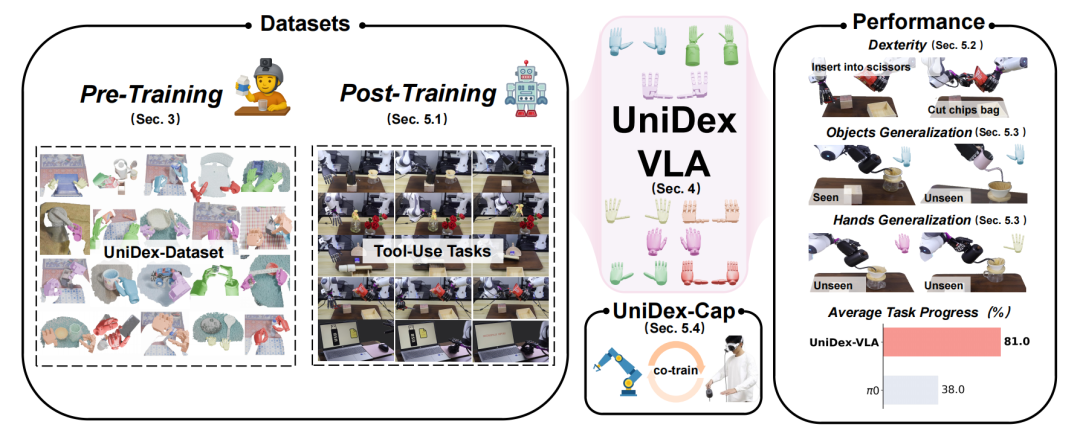
展示了从海量第一人称人类视频中提取并构建数据集,进而在统一的FAAS动作空间下训练3D VLA模型,最终实现对多种异构灵巧手的高效控制与零样本泛化。
【创新点】
功能-驱动器对齐空间(FAAS):提出了一种极具启发性的统一动作空间设计。它不再拘泥于具体的机械结构(URDF),而是按照“功能(如拇指捏合、侧向展开)”将不同灵巧手的驱动器映射到共享坐标系中。这使得跨硬件的技能转移成为可能。
低成本人机协同训练(UniDex-Cap):设计了一套便携式数据采集系统,仅用Apple Vision Pro和RealSense深度相机,就能将人类动作零成本转化为机器人轨迹。研究发现,“2条人类数据≈1条机器人数据”,极大降低了微调成本。
【成果】
惊艳的实机表现:在倒咖啡、扫地、剪塑料袋等5项复杂的长视野工具使用任务中,仅需50条实机演示微调,UniDex-VLA就达到了81%的平均任务进度,远超现有SOTA模型(如仅为38%)。
零样本跨手泛化:得益于FAAS空间和海量预训练,在一个灵巧手(如Inspire)上训练的技能,可以零样本(Zero-shot)迁移到结构完全不同的另一只灵巧手(如Wuji)上并成功执行任务。
Drive My Way: Preference Alignment of Vision-Language-Action Model for Personalized Driving (CVPR 2026)
【亮点速览】
告别“千车一面”:现有的端到端自动驾驶系统往往只追求“安全高效”的通用目标,忽略了人类驾驶员的个体差异。Drive My Way (DMW)提出了首个能同时对齐人类“长期驾驶习惯”与“短期语言指令”的个性化VLA框架。
首个个性化驾驶数据集(PDD):构建了首个包含30位真实人类驾驶员画像、轨迹及交互的多模态个性化驾驶数据集,为研究拟人化自动驾驶提供了数据基石。
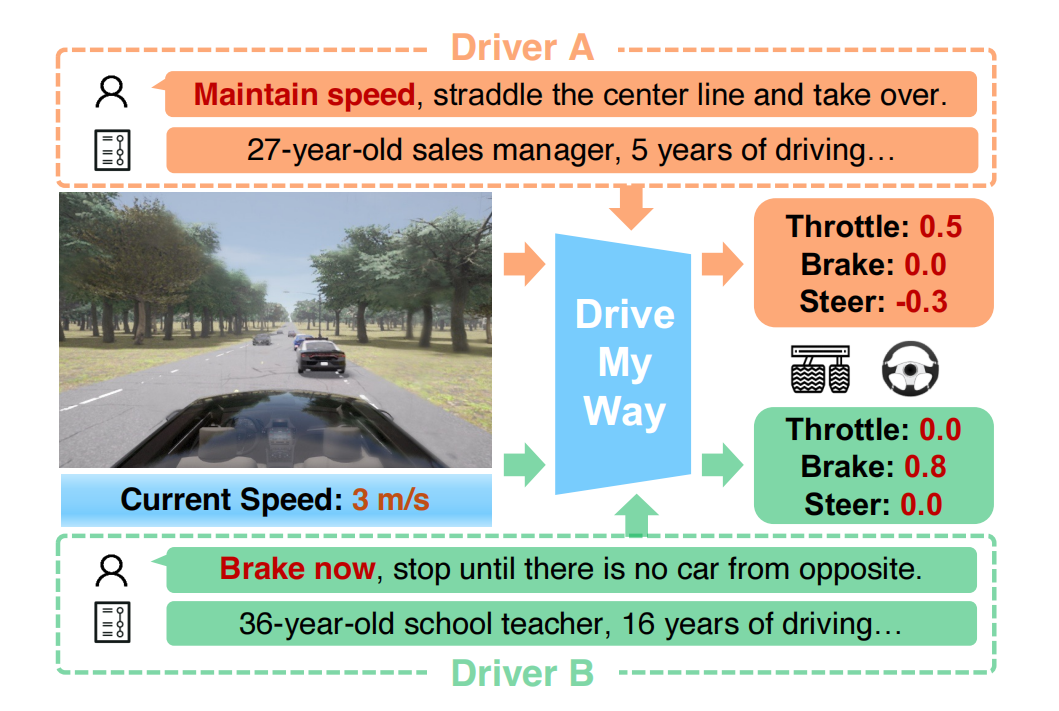
面对相同的行驶场景,模型能够结合长期的驾驶员画像(如年龄、职业、驾龄)与实时的自然语言指令(如“保持车速”或“立即刹车”),自适应地输出符合个人偏好的驾驶控制参数。
【创新点】
长期偏好嵌入(User Embedding):利用对比学习(Contrastive Learning)从驾驶员的历史轨迹和个人画像(如年龄、驾龄、性格)中提取长期偏好特征,将其作为潜在先验注入VLA模型的规划过程中,让AI学会“因人而异”的驾驶风格。
短期语言指令自适应(GRPO微调):面对“我赶时间”或“我晕车”等实时自然语言指令,模型采用组相对策略优化(GRPO)强化学习微调。配合由大语言模型(LLM)生成的动态奖励权重(安全、舒适、效率),让车辆能在复杂的交通交互中做出符合语义语境的即时反应。
【成果】
“听得懂,开得稳”:在Bench2Drive闭环测试中,DMW在面对“激进”指令时能显著提升通行效率(提高18.77%),在面对“保守”指令时能增大安全冗余,且始终保持极高的驾驶安全性。
高度还原个人风格:用户研究表明,DMW生成的驾驶轨迹不仅能被准确归类回对应的真实驾驶员集群,其生成的激进行为与保守行为均具有极高的拟人化辨识度。
Uni-World VLA: Interleaved World Modeling and Planning for Autonomous Driving (ECCV 2026)
【亮点速览】
终结“开环幻觉”:现有的自动驾驶世界模型往往采用“先预测未来几秒画面,再根据画面规划轨迹”的串行模式,导致预测环境与自车动作脱节。Uni-World VLA提出了“交替生成(Interleaved Generation)”的新范式,实现了预测与规划的闭环融合。
深度融合的3D感知:在纯视觉方案中引入单目深度估计先验,通过交叉注意力机制融合几何特征,大幅提升了长视野下场景预测的结构稳定性。

区别于传统的并行处理(a)或“先预测后规划”的开环模式(b),Uni-World VLA提出了交替生成范式(c),让未来画面预测与自车动作规划步步交织,形成了适应动态环境的闭环互动。
【创新点】
预测与规划交替生成(Interleaved Modeling and Planning):在统一的自回归架构中,模型不再一次性吐出所有未来画面,而是“生成一帧画面->规划一步动作->将新动作作为条件->生成下一帧画面”。这种步步为营的反馈机制,使得规划决策能够基于最新预测的动态环境不断微调。
双分支Tokenizer与动态焦点损失:将历史信息解耦为“高分辨率上下文Token”与“低分辨率动态Token”,并引入动态焦点损失(Dynamic Focal Loss),强迫模型将注意力集中在画面中随时间变化的区域(如运动的车辆),而非静止的背景。
【成果】
SOTA级闭环性能:在高保真NAVSIM模拟器中,Uni-World VLA取得了89.4的极高综合驾驶得分(PDMS),在碰撞率(TTC)和通行进度(EP)上均超越了现有的先进世界模型。
极致的视频预测质量:即使在4秒的较长视野下,交替生成策略配合深度特征,依然能生成高度连贯、符合物理直觉的未来视频,避免了传统模型中常见的车辆形变与消失问题。
补齐通用性与个性化短板让模型真正适应物理世界
这三篇论文清晰地展示了视觉-语言-动作(VLA)模型在不同细分方向上的最新探索。UniDex主要解决的是底层硬件的差异问题,通过设计统一的动作映射空间,让同一个模型能够跨越硬件壁垒,直接控制不同构造的机器灵巧手。Drive My Way则把重点放在了人机交互上,让自动驾驶系统不再刻板,而是能够学习不同驾驶员的长期习惯,并能听懂乘客“赶时间”或“求稳”的实时指令来调整开车风格。Uni-World VLA探讨的是模型对动态环境的理解能力,通过让“预测未来画面”和“规划当前动作”交替进行,有效避免了自动驾驶在复杂路况下容易出现的决策脱节问题。整体来看,当前的研究正在努力补齐具身智能在通用性、个性化和环境感知上的短板,让这些智能系统能更好地适应真实的物理世界和人类的实际需求。
原文链接: https://www.leiphone.com/category/private/hGhYzvsXiyZQHjfP.html
