


来源:AI TIME 论道
原文链接:https://mp\.weixin\.qq\.com/s/2z\_HOFRd7K1FgH5\_QD3TXw
本文内容基于公开论文资料整理,相关研究成果版权归原作者及所属机构所有。我们尊重每一位研究者的原创贡献,如有任何建议或权益相关问题,欢迎联系我们,我们将及时沟通处理。
ECCV 2026 Oral
论文题目:CoverPrune: Coverage-Driven Token Pruning for 3D VLMs via Optimal Transport
论文作者:Peng Ling,Yingda Yin,Lingting Zhu,Weikai Chen,Shengju Qian,Zeyu Hu,Xin Wang,Wenming Yang
论文链接:https://arxiv\.org/abs/2608\.13226
项目主页:https://github\.com/Brucess/CoverPrune
1
引言
近年来,3D视觉语言模型(3D VLM)通过将视频、多视角观测或3D表征中的显式几何线索注入视觉token流,展现出强大的空间推理能力。然而,这种设计也带来了"甜蜜的负担":单次输入可能产生数百甚至上千个视觉token,推理过程被注意力机制的二次复杂度和KV Cache的持续膨胀所主导。随着3D VLM走向更丰富的视觉环境,视觉token效率已成为实际部署的关键瓶颈——推理时token剪枝由此成为刚需。
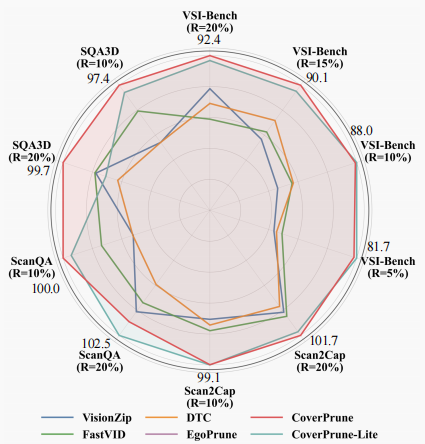
图1|CoverPrune与CoverPrune-Lite在不同token保留率下的跨基准性能表现
图中雷达图的每个维度代表对应基准上所有指标相对于全token基线(100%)的平均性能保持率。可以看到:在通用3D任务(Scan2Cap、ScanQA、SQA3D)上,本方法仅保留10%视觉token即可实现近零性能损失;在推理难度更高的VSI-Bench上,保留15%视觉token仍能维持90%以上的性能。
2
背景与挑战
现有的推理时视觉token剪枝方法主要面向2D图像或视频理解,可分为两大流派:
基于注意力的方法(如VisionZip、SparseVLM):依据浅层注意力质量给token打分,删除低分token。但注意力分数容易被"注意力汇"(attention sink)和依赖提示词的显著性所扭曲;
基于多样性的方法(如DivPrune、FastVID):把特征空间中的相似度视作冗余的代理,删除彼此最相似的token以最大化保留集的分散度。
这两类策略在温和压缩下尚能奏效,但都没有显式地为"保留推理所需的代表性视觉证据"而设计。
问题在3D场景中被急剧放大:在3D视觉-空间推理中,token经常编码重复的多视角观测——它们在特征空间看似"冗余",实则是重建空间关系、维持几何一致性的互补证据。基于多样性的剪枝恰恰会优先删掉那些"与很多token相似"的原型token(原型token按定义就与其所在模式内的众多token相似),导致保留集"看似多样、实则偏向离群点"。多视角对应关系一旦被破坏,对距离、方位等空间关系的推理便会随之崩塌。
由此引出一个根本性问题:3D VLM的token剪枝,到底该优化什么目标?
3
主要贡献
本文的核心洞察是:有效的token剪枝应当"保留覆盖"而非"最大化多样性"——保留的token应集体覆盖原始token集的信息内容,同时自身保持紧凑以支撑高效推理。这一原则天然对应"选择一个紧凑子集、使其对视觉证据的覆盖最大化"的优化问题。主要贡献如下:
全新的剪枝范式:提出免训练、即插即用的CoverPrune框架,将剪枝目标从"最大化token多样性"根本性地转变为"守护视觉证据覆盖",并通过最优传输(OT)优雅地加以形式化;
量身定制的OT方案:为化解OT应用于推理时剪枝的固有难题,提出三项关键设计——全面建模多维token关系的特征-空间-时间(FST)传输代价、优先保障信息量大的token的动态目标容量,以及一个高效的优化算法;
轻量化加速:设计CoverPrune-Lite变体,通过空间结构化的局部匹配近似OT覆盖目标,大幅降低剪枝自身开销,性能损失极小;
SOTA性能:在论文比较的多个3D视觉-空间推理基准与四种代表性免训练剪枝方法中取得最优整体表现,尤其在激进剪枝预算下展现出较强的token鲁棒性。
4
方法
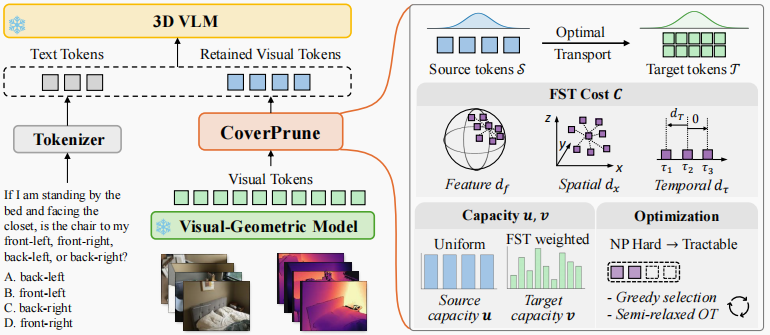
图2|CoverPrune框架总览
(左)CoverPrune作为一个免训练、即插即用的模块,插入在视觉-几何编码器与3D VLM之间,直接对原始视觉token进行剪枝;(右)本文将token剪枝形式化为一个最优传输(OT)问题,以最大化视觉证据覆盖,并引入三项关键设计:(1)特征-空间-时间(FST)代价 C(d_f, d_x, d_τ),从特征相似度、3D空间邻近性、时间一致性三个维度全面建模token间的替代关系;(2)非对称容量分配,依据token信息量为源/目标分配传输质量,稳定大规模传输下的质量分配;(3)可解的优化策略,将本质上NP难的组合子集选择问题转化为可高效近似求解的形式。
问题形式化:把"覆盖"写进最优传输
设输入视频经token化后得到全部N个视觉token T,每个token带有特征嵌入f、可由SfM或几何基础模型估计的3D全局坐标x、以及所在帧的时间戳τ。给定保留率R,目标是选出K=⌈RN⌉个token组成的子集S。
CoverPrune将被保留的token视作"原型",由它们向全部原始token分配"表征质量",并以最优传输代价衡量"覆盖失真":传输代价越小,说明保留集越能忠实地代表原始token集。剪枝即选择使传输代价最小的子集。其中,源容量取均匀分布(原型之间无先验偏好),而目标容量若也取均匀分布则次优——原始token的信息量差异巨大,平均分配会让大量质量流向冗余噪声区域。
FST传输代价:特征×空间×时间
3D空间推理要求信息保真超越纯语义。为此,作者设计了"特征-空间-时间"三域联合的传输代价。三类距离在当前样本内先进行min-max归一化,再按权重组合为最终传输代价:
特征邻近性 d_f = 1 − cos(f_s, f_t):最小化token替代时的语义失真;
3D空间邻近性 d_x = ‖x_s − x_t‖₂:保持几何完整性,支撑物体与关系的准确grounding;并施加非线性映射φ_κ(x)=log(1+κx)/log(1+κ)扩展近场距离的动态范围;
时间一致性 d_τ = ReLU(τ_s − τ_t):单向惩罚"用更晚观测的token去覆盖更早观测的token",使保留集遵循空间证据的真实时序。
三项加权求和构成统一的可替代性度量,引导传输方案沿语义对齐、几何一致、时间连贯的对应关系分配质量。
FST目标容量:谁更"不可替代",谁就值得更多覆盖
目标容量v决定每个原始token值得多少传输质量。设计同样遵循FST准则:越难被其3D局部邻域近似(特征/几何/时间上越独特)的token,携带的独有信息越多,应被优先覆盖。具体地,对每个token计算其与3D空间中n个近邻的平均FST差异作为局部独特性分数,再经单调映射归一化为容量——防止稠密但冗余的区域主导覆盖目标。
优化:半松弛OT + 空间引导贪心选择(SGS)
核心困难在于:经典OT中源支撑集是固定的,而这里 "选哪些token当源"本身就是决策变量——联合选择子集并求解耦合,是NP难的组合问题。
作者的解法分两步:
半松弛OT:将目标侧的等式约束放松为不等式(P⊤1 ≤ v),允许容量闲置。论文引用既有研究指出,在这类松弛Wasserstein目标下,用于子集选择的集合函数可以具有单调次模性,从而可在基数约束下采用带常数因子近似保证的贪心最大化;当松弛约束收紧时,半松弛OT可退回标准OT。需要注意的是,这一理论性质来自论文引用的相关松弛OT研究,不能直接等同为对CoverPrune完整SGS实现本身的独立近似保证;
空间引导贪心选择(SGS):朴素的贪心每一步都要为每个候选token重解一次传输问题,代价过高。SGS利用3D场景的局部性先验——一个token只能有效覆盖3D空间上邻近的token(远处的区域对应不同表面/物体,传输代价天然很高)——把边际代价评估限制在3D近邻内,每步只需解一次半松弛OT、以残差容量加权的局部边际代价选入下一个token,彻底避免全局OT的反复求解。
CoverPrune-Lite:块结构OT近似,复杂度O(N log N)
完整版CoverPrune的迭代式全局传输优化在长视频序列上仍嫌笨重。Lite版进一步榨取空间局部性:
3D感知排序:用Morton码空间填充曲线对所有token排序,排序后相邻的token在3D空间中大概率邻近,无需显式近邻搜索;
容量引导分组:沿Morton序遍历并累积目标容量,每凑满1/K即封组,得到K个"信息质量大致相等"的组——冗余区域单token容量小、组更大,信息密集区域组更细;
组内选原型:每组内选出使组内容量加权传输代价最小的token作为代表。
理论上,Lite等价于把传输方案限制为块对角、局部支撑结构的OT目标(块约束OT),一次分组+一遍局部选择即可完成剪枝,推理时复杂度降至O(N log N)。
5
实验结果
实验设置:在四个主流3D视觉-语言基准上评测——细粒度推理基准ScanQA、SQA3D、Scan2Cap,以及涵盖物体计数、相对距离、相对方向、路线规划、物体尺寸、房间尺寸、绝对距离、外观顺序共八项任务的VSI-Bench;基座模型为GS-Reasoner与VLM-3R(均保持默认配置、均匀32帧采样、坐标由估计器生成而非真值);对比四个SOTA免训练剪枝方法:VisionZip(CVPR25)、FastVID(NeurIPS25)、DTC(CVPR25)、EgoPrune(arXiv25)。
通用3D任务:几乎无损
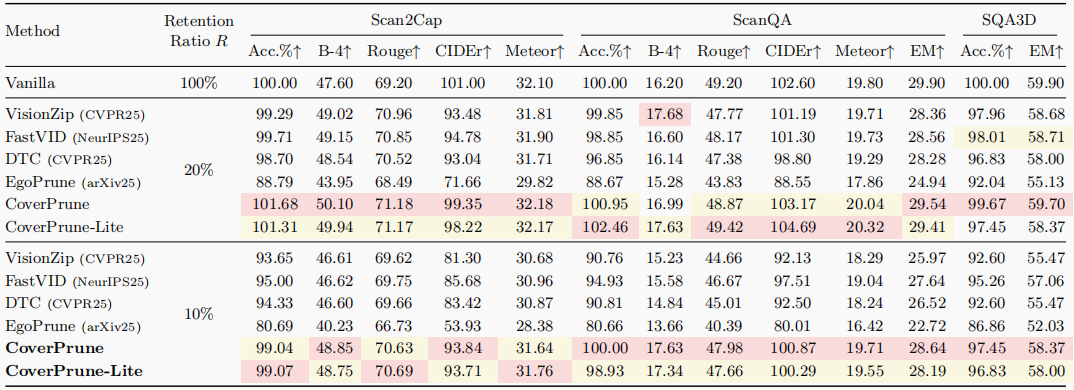
表1|通用3D任务评测结果
基线(Vanilla)结果来自GS-Reasoner,保留率R为剪枝后剩余视觉token的比例,各基准的Acc.%为该基准所有指标相对全token基线的平均性能保持率。在20%和10%保留率下,CoverPrune与CoverPrune-Lite在绝大多数指标上稳居前两名:20%保留率下,两方法在ScanQA上分别取得100.95%与102.46%的相对性能(即超过全token基线),Scan2Cap上的B-4、Rouge以及ScanQA上的CIDEr等多项指标同样不降反升;即便压到10%保留率,Scan2Cap/ScanQA/SQA3D的相对性能仍保持在99.04%/100.00%/97.45%,而EgoPrune等基线已明显塌缩(如Scan2Cap的CIDEr跌至53.93%)。
VSI-Bench空间推理:越激进,优势越大
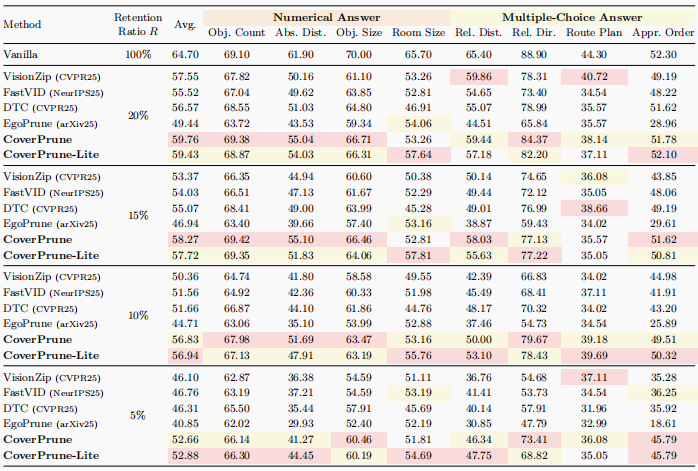
表2|以GS-Reasoner为基座模型在VSI-Bench上的评测结果
每个保留率下各方法保留的token数量保持一致。20%保留率下CoverPrune平均分59.76,保持全token性能(64.70)的92.4%;随着压缩加剧,本方法的优势进一步放大——10%保留率下CoverPrune/Lite平均分56.83/56.94,领先该设置下的DTC(51.66);5%保留率下两变体取得52.66/52.88,相比该设置下最强基线FastVID(46.76)分别高出5.90和6.12分,而EgoPrune已跌至40.85。
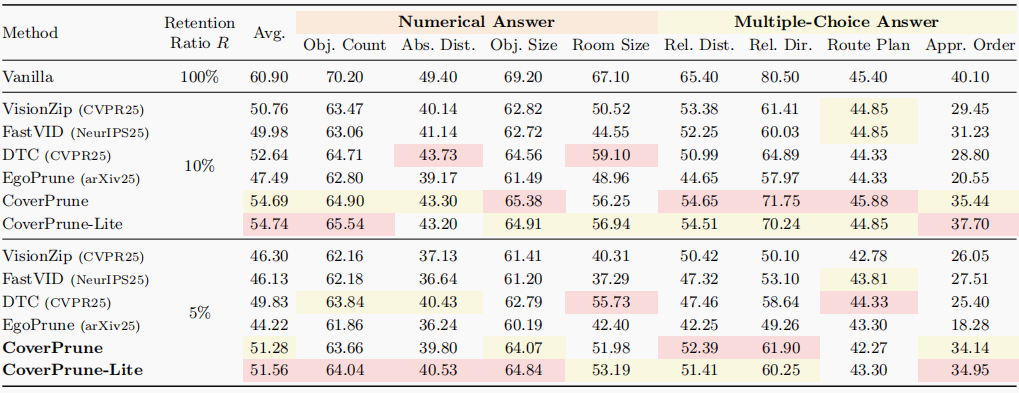
表3|以VLM-3R为基座模型在VSI-Bench上的评测结果
换用基座模型后结论总体一致:CoverPrune与CoverPrune-Lite在平均分和大多数单项任务上均优于论文比较的基线(10%保留率:54.69/54.74 vs DTC 52.64;5%保留率:51.28/51.56 vs DTC 49.83),说明覆盖驱动策略在GS-Reasoner与VLM-3R两个不同基座模型上均表现出一致优势。
值得注意的是两个变体呈现出互补的性能趋势:CoverPrune-Lite在侧重全局布局的Room Size任务上更优(其几何感知排序保留了粗尺度信号),完整版CoverPrune则在细粒度的Relative Direction任务上占优(其完整覆盖优化保留了细粒度的关系对应)——与两者的设计动机高度吻合。
消融与效率分析
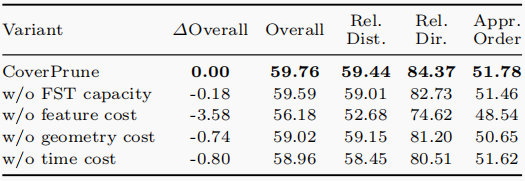
表4|CoverPrune组件消融(VSI-Bench,R=20%,GS-Reasoner基座)
去掉特征代价造成最大退化(Overall下降3.58分,Relative Direction从84.37跌至74.62),证实语义亲和性对固定预算下的覆盖至关重要;去掉几何代价与时间代价分别下降0.74与0.80分,验证3D和时间线索对关系中心型推理的增益;去掉FST容量加权导致轻微但一致的下降,说明合理的传输容量分配同样有益。
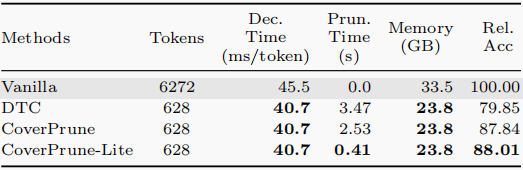
表5|不同剪枝方法的效率对比(VSI-Bench,token数6272→628,即约10%保留率)
所有剪枝方法共享相同的内存占用(33.5GB→23.8GB)与解码延迟(45.5→40.7 ms/token),差距在剪枝自身开销——CoverPrune剪枝耗时2.53s,低于DTC的3.47s;CoverPrune-Lite仅需0.41s(约为DTC的1/8),同时取得最高的相对精度88.01%,显著降低了覆盖式选择的推理前处理开销,也使其更具实时应用潜力。
6
总结与展望
本文将3D VLM的视觉token剪枝重新定义为一个基于最优传输的覆盖最大化问题,跳脱出 diversity 驱动与注意力驱动的主流范式。提出的CoverPrune以免训练、即插即用的方式,融合多域FST传输代价、信息量感知的FST目标容量与高效的SGS求解器;轻量变体CoverPrune-Lite则进一步显著降低剪枝开销。论文报告的大量实验表明,该方法在多个基准、两个基座模型以及所比较的代表性免训练剪枝方法中取得了整体领先表现。
展望未来,作者计划进一步挖掘这一具有最优传输与覆盖优化动机的剪枝范式,并将其适用性拓展至通用VLM,为更广泛的大规模模型部署探索高效、鲁棒的推理加速方案
原文链接: https://www.leiphone.com/category/private/0UyH4AsPYBdQUz5k.html
