


来源:公众号“具身智能之心”
作者丨Jindou Jia 等
编辑丨具身智能之心
本文只做学术分享,如有侵权,联系删文
作者丨Jindou Jia 等
编辑丨具身智能之心
本文只做学术分享,如有侵权,联系删文
过去几年,扩散模型和 Flow Matching 给机器人策略生成带来了范式的转变:模型不再简单回归动作,而是像生成图像一样,一步步从原始噪声生成未来动作。
图像生成从噪声开始,很合理。因为一张图片本来就是“从无到有”地被想象出来。
但机器人不是这样。它一直有本体感知反馈,知道自己刚才怎么动、关节怎么变化、末端执行器往哪里走。也就是说,机器人天然拥有一串连续的历史动作,而这串动作本身就是非常强的物理先验,因为真实世界里的动作不是突然冒出来的,而是沿着上一段动作自然延续下去的。
所以 A2A Flow Matching 最直接的洞察就是:
机器人生成动作,不一定要从随机噪声开始。历史动作本身,就是最好的起点。
该成果已被机器人领域国际顶级学术会议 RSS 2026(Robotics: Science and Systems)录用。
一. 核心思想:从历史动作分布到未来动作分布
1.1 背景和动机
现在很多扩散策略、流匹配策略,本质上走的是这样一条路:
随机噪声 → 未来动作
A2A 则把它改成:
历史动作 → 未来动作
这个变化非常关键,直接改写了机器人策略生成的底层范式。
随机噪声和真实动作之间隔得太远,模型必须一步步把无意义的噪声拉回可执行动作。路径长,迭代多,推理自然慢。但历史动作不一样。它本来就和未来动作相邻,背后还带着机器人运动的惯性、趋势和物理约束。换句话说,历史动作已经站在了一个很接近答案的位置。
所以 A2A 做的不是“从零生成动作”,而是“顺着历史轨迹继续往前推”。
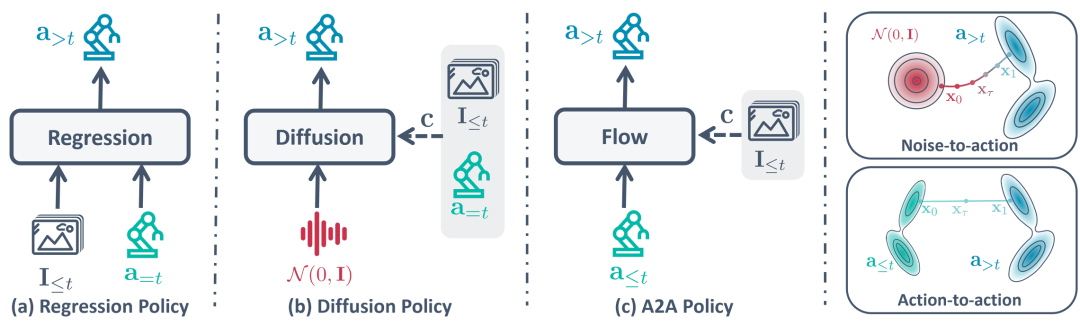
具体来说,A2A 把动作生成重新定义为历史动作分布到未来动作分布的流匹配(Flow Matching)。
关键设计在于:历史动作不是像以往方法那样,简单地和视觉特征拼接在一起作为条件,而是被编码成一个高维潜变量 ,作为流匹配的“起点”。
未来动作则被编码为目标潜变量 。模型学习一个向量场 ,把 沿着最优传输路径“推”到 。
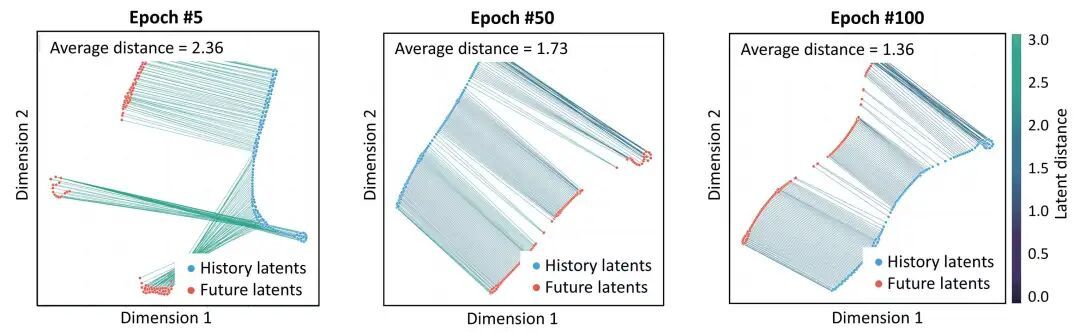
由于相邻动作块在物理上天然相似,嵌入高维潜空间后, 和 的分布距离非常近。这意味着传输路径很短、很直,哪怕只用轻量级的 MLP 架构,单步推理也能完成高质量的映射。
1.2 网络架构
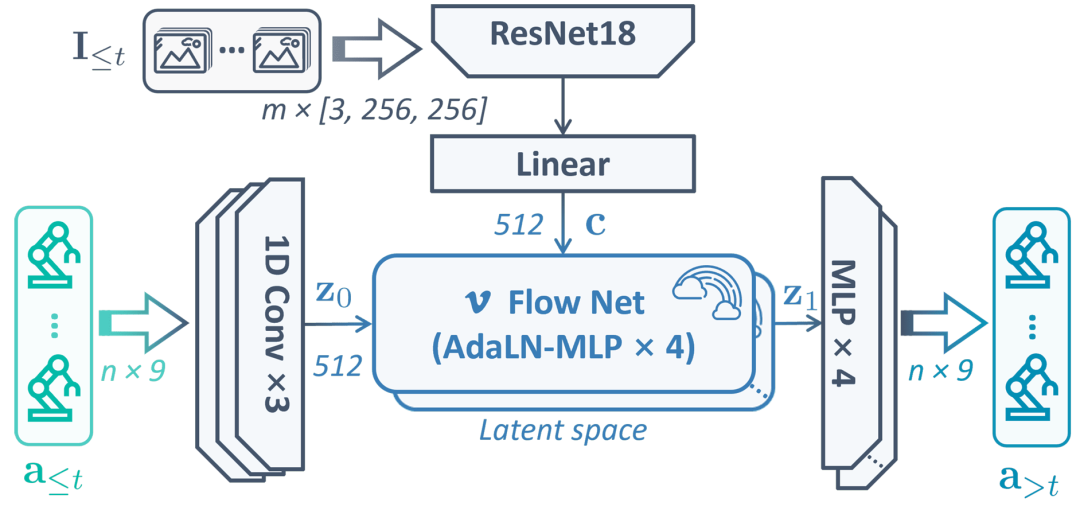
A2A 的整体结构很简洁,把历史动作和未来动作都放进一个高维潜空间里,再在这个潜空间里做 Flow Matching。
具体来看,模型主要分成三条路径:
视觉这一路,历史图像经过 ResNet-18 和线性投影,得到一个全局条件向量。
动作这一路,历史动作序列经过 1D CNN,被编码成潜变量,作为流匹配的起点。
生成这一路,Flow Net 用 4 个 AdaLN-MLP 块预测向量场,最后再通过残差 MLP 解码成未来动作。
1.3 训练目标
为了把历史动作编码的潜空间能变成真实可执行的动作,A2A 设计了三类训练约束:
Flow Matching Loss:负责学习从历史动作潜变量 到未来动作潜变量 的向量场。
Reconstruction Loss:保证动作编码器和解码器能还原动作块,维持潜空间拓扑结构。
Inference Consistency Loss:要求通过 ODE 积分得到的和真实未来动作的编码对齐;同时解码后的动作,也要和真实未来动作对齐。这个损失对于避免潜空间坍缩至关重要,是支撑单步推理的基石。
二. N-A2A:给历史轨迹一点扰动
真实机器人里,传感器会有噪声,执行器会有误差,初始位姿也可能不准,因此历史动作也不是绝对可靠。如果模型过度相信历史动作,一旦历史轨迹有偏差,后面的动作就可能跟着偏。
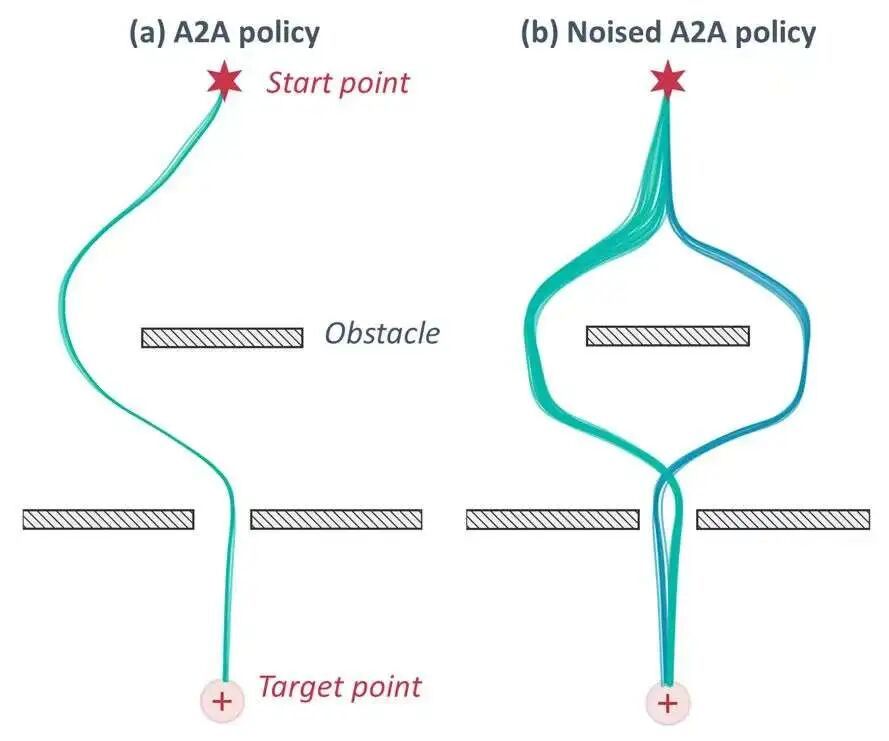
于是作者进一步提出了 N-A2A (Noised A2A)。做法很简单:在历史动作编码之前,注入少量高斯噪声。这能显著提升对初始状态不确定性和动作级扰动的鲁棒性,并且还能保持动作多模态能力。
三. 实验结果
在多项仿真(ManiSkill, RLBench, LIBERO)与真实Franka机器人任务中,A2A展现出了极佳的训练效率、推理速度、以及泛化能力。
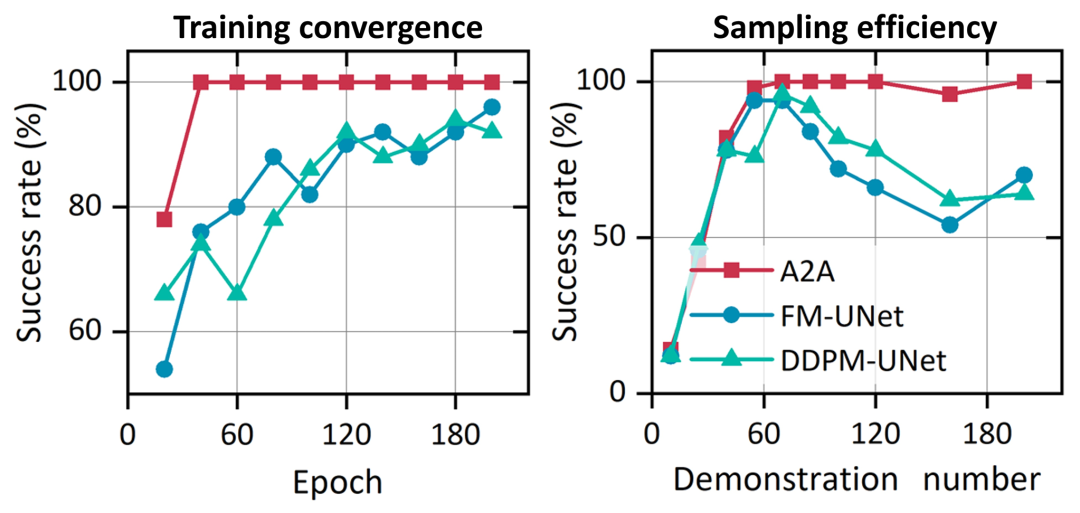
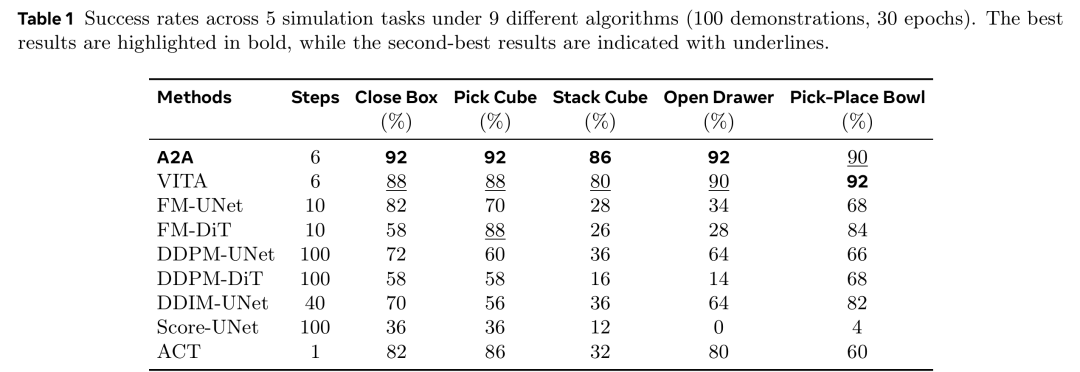
首先训练效率方面,A2A 展现出极快的收敛速度,仅需少量训练轮次即可达到稳定的100%成功率。在5类仿真任务中,其成功率全面领先于8种主流方法,并在有限数据下也能够维持高性能表现。
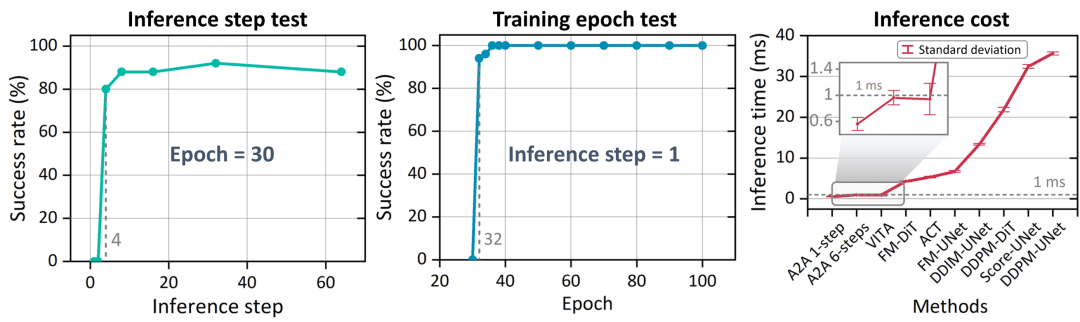
此外,推理速度方面,A2A实现了亚毫秒级的极致推理速度,平均延迟仅约1ms,在单步推理模式下延迟更是低至0.56ms,比传统扩散策略快20倍,比常规流匹配方法(10步)快5倍。
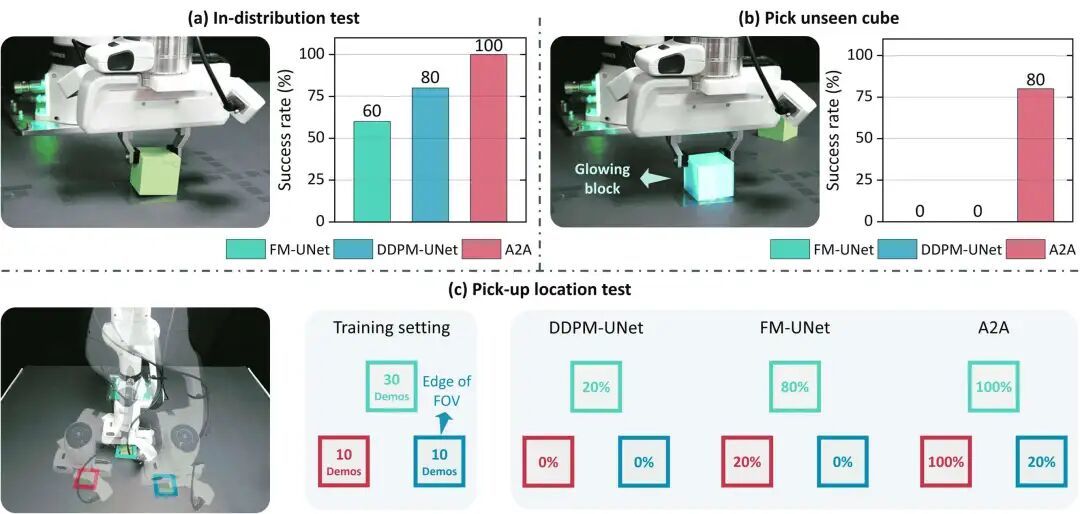
最后,A2A极大提升了视觉泛化性。例如,实验中将抓取木块换成从未见过的发光方块,传统扩散和流匹配策略均会彻底失效,而A2A仍可维持80%的高成功率。
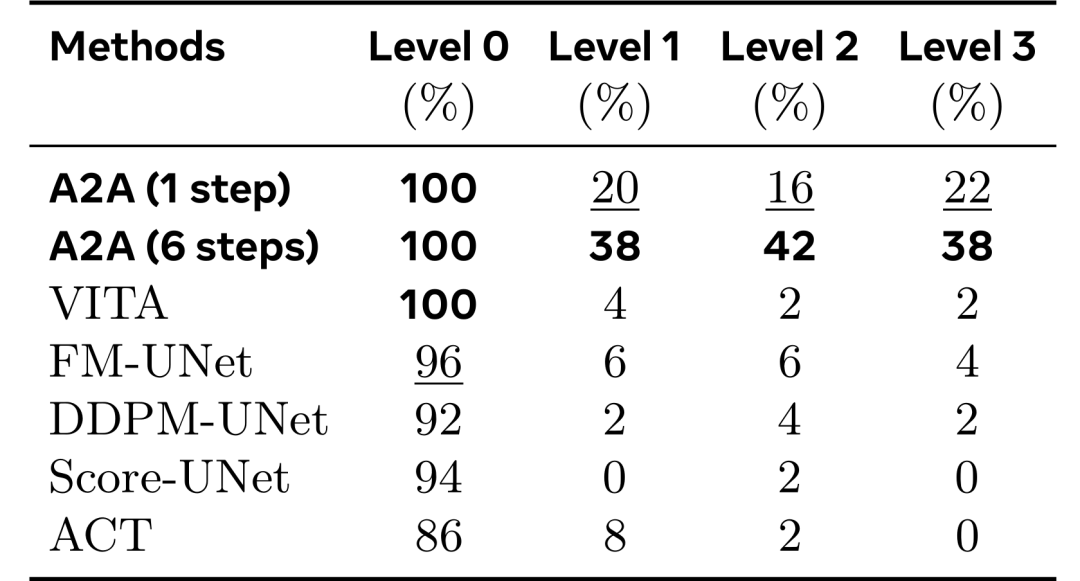
无论是面对场景随机化(Level 1)、灯光扰动(Level 2)还是视角切换(Level 3),A2A 的成功率均领先于现有算法。这归功于A2A的解耦策略,将动作历史作为稳固的先验,减少了对易受干扰视觉特征的依赖。
四. 扩展:不只动作,也可以是视频
作者还把这个思想扩展到了视频预测,提出 Frames-to-Frames Flow Matching。
逻辑是一致的:预测未来帧,也不一定非要从噪声开始。历史帧本身就包含运动趋势和时序信息,用它作为起点,会比随机噪声自然得多。这种高效预测视频的范式也可能为机器人训练提供更低成本的时序先验。
A2A 背后的思想不只适用于机器人动作,而是可能适用于一类更广泛的时序生成问题。只要任务本身有连续性,“历史到未来”就可能比“噪声到目标”更合理。
五. 总结
A2A Flow Matching 最值得关注的是它指出了一个很容易被忽略的问题:既然机器人天然有本体感知和历史动作链,为什么还要每次从噪声里重新找动作?
过去我们习惯把扩散模型、Flow Matching 从图像生成搬到机器人控制里。但机器人不是图像,动作也不是凭空出现的。
所以 A2A 的意义可以概括成一句话:
把机器人策略生成从 Noise-to-Action 推进到 Past Action to Future Action。
如果把历史动作作为生成起点,模型可以获得更低延迟、更强连续性和更好的真实环境适应性。这一步可能会成为未来高频控制、长时序任务和真实机器人部署里,一个非常值得继续挖的方向。
原文链接: https://www.leiphone.com/category/private/tTOFjCFA1yz6am2E.html
