


来源:视觉语言导航
原文链接:https://mp.weixin.qq.com/s/TOVmH9nX8BAu-rH_ec2dbg
✨导读:用文字转述3D空间信息会丢失几何、语义细节,导航效果大打折扣!浙大团队推出SoftNav,直接把3D场景连续特征转为软Token输入VLM,仅17M可训练参数、1200条样本就刷新多导航赛道SOTA,还能零样本落地真实四足机器人。
作者:Yi Wu, Junjie An, Xiao Liu, Yiqun Zhou, Yuechen Wu, Xiaoqing Guan, Shuyang Yu, You Wang, Guang Li 单位:浙江大学,山东大学 论文标题:SoftNav: Injecting 3D Scene Tokens into VLMs for Embodied Navigation 论文链接:https://arxiv.org/abs/2607.14586
?研究背景
目标导向具身导航,简单说就是让机器人在完全陌生的3D环境里,看懂语言指令、自主找到指定物体,目前行业两大主流方案都有明显短板:
纯模块化3D感知路线:(MTU3D、SemExp等) 专门的3D编码器能精准提取环境物体、可探索边界特征,但完全舍弃视觉大模型(VLM)的语言逻辑推理能力,面对全新场景、多模态指令泛化能力很差。 VLM文本中转导航路线:(NavGPT、SG-Nav、SayNav等) 当下最主流的方案:把3D坐标、场景结构图翻译成文字喂给大模型做决策。 这里藏着一个致命表征鸿沟:离散文本无法完整承载3D连续信息,物体几何形态、空间相对位置、语义关联全部丢失,直接导致导航成功率暴跌、行走路径绕远。
过去几乎没有工作定量测算过“文本转译”带来的性能损失,也缺少无损对接3D编码器与VLM的方案;同时现有方法动辄几十万训练样本、海量可调参数,很难部署到实体机器人。 本篇论文通过严格对照消融实验实锤:仅靠文字传递3D信息会产生显著性能衰减,必须搭建一套嵌入层面直接对齐的跨模态融合方案。
?三大核心贡献
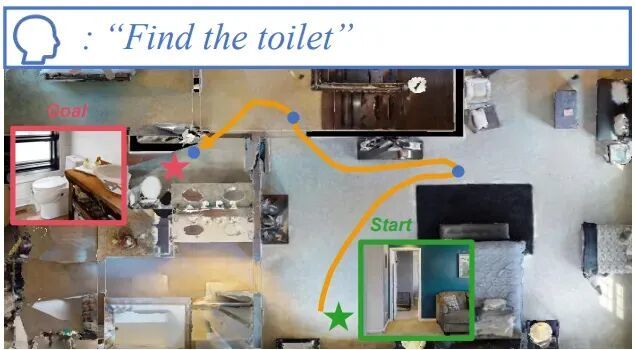
首次量化表征鸿沟问题: 设计对照实验固定3D编码器与VLM不变,仅更换信息传输通道,证实文本序列化会带来统计级显著性能下滑;单纯丰富文字描述、给大模型加LoRA微调,都没法弥补信息丢失带来的差距。 首创3D实体软Token注入框架SoftNav:设计轻量MLP投影器,将专用3D编码器输出的物体/边界连续嵌入转化为软Token,直接注入冻结VLM的隐层空间;3D编码器、视觉大模型全程冻结,仅需约17M可训练参数。 极小训练成本+超强零样本泛化: 只用1200条监督样本完成训练,在HM3D-OVON数据集全面超越历史SOTA;单套训练好的导航策略,无需二次微调就能适配GOAT-Bench、SG3D两大导航基准,还能直接部署Unitree Go2实体四足机器人。
?️完整研究方法
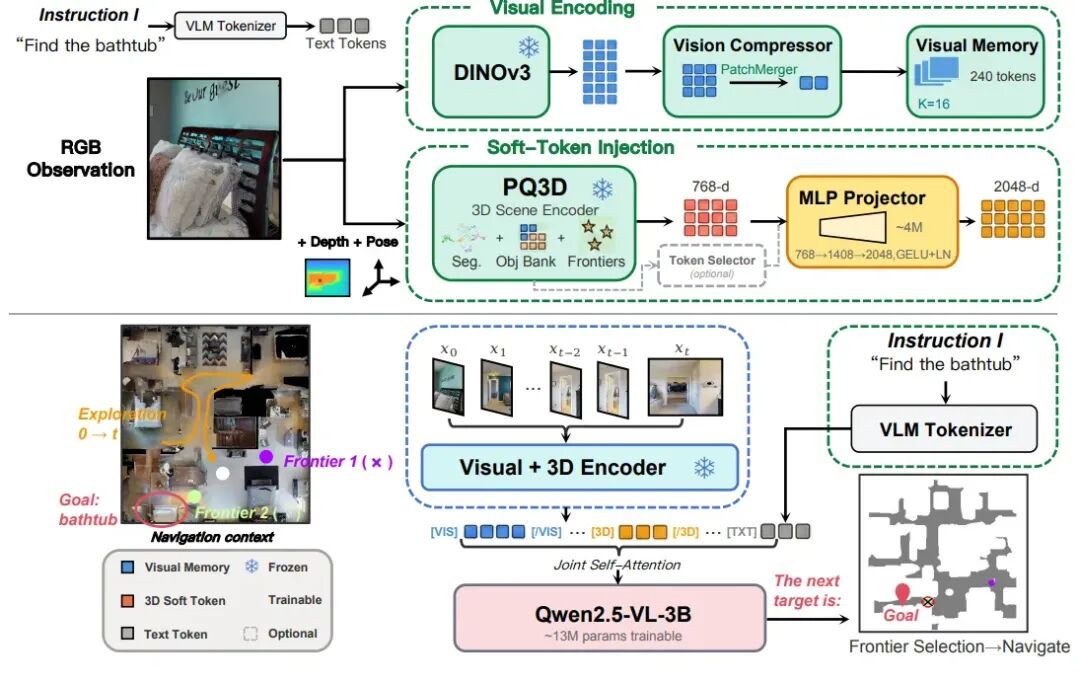
SoftNav整体流水线分为视觉记忆分支、3D场景编码分支、软Token投影注入、边界点决策、轻量化冻结训练5大模块,全流程无需微调预训练大模型与3D感知模型。
1. 双分支并行编码
(1)视觉记忆分支:留存历史观测画面
采用完全冻结的DINOv3提取单帧图像特征,通过PatchMerger压缩模块把画面特征精简为15个视觉Token;设置滑动窗口缓存最近16帧画面,形成长期视觉记忆:
(2)3D场景编码分支:输出完整空间连续特征
使用冻结PQ3D编码器处理RGB-D深度图像流,实时完成增量3D实例分割、物体库更新、可探索边界检测;输出每个物体/探索边界专属768维嵌入,融合几何、语义、空间相对关系三类关键信息。
2. 轻量MLP投影器:一键对齐3D特征与VLM维度
两层MLP搭配GELU激活与层归一化,把768维3D嵌入平滑映射到VLM所需2048维隐空间,中间设置1408维作为渐进扩维缓冲,投影器仅4M参数,推理几乎无延迟:
其中,,单次投影耗时仅0.07ms。
3. 软Token分散注入:无缝融入VLM输入序列
将投影后的3D软Token、视觉记忆Token、文字指令Token拼接为完整输入序列:
内部默认先排列边界Token、后排列物体Token;替换文本模板里的占位符,保证3D特征Token和VLM原生位置编码完美匹配。
4. 边界点决策机制:保证导航目标可达
VLM自回归生成预测目标坐标; 将预测坐标匹配到占用地图上最近、可抵达的边界点,增加距离比例约束,避免机器人选择过远点位浪费步数:
若无可用边界,自动触发原地探索兜底策略,由轨迹追踪器执行局部移动。
5. 轻量化冻结训练:千条样本即可收敛
全程冻结DINOv3视觉编码器、PQ3D、Qwen2.5-VL-3B视觉大模型,仅训练两部分参数:
MLP投影器(4M) VLM注意力、前馈层LoRA适配器(13M,r=8,α=32)
训练集仅1187条从成熟导航系统MTU3D中提取的成功导航片段,损失函数采用坐标字符串自回归交叉熵:
?全面实验验证
1. 实验基础设置
仿真环境:Habitat模拟器,搭载Stretch机器人模型; 三大评测数据集:HM3D-OVON(开放词汇物体导航)、GOAT-Bench(多模态连续目标导航)、SG3D(场景图序列化导航); 核心评价指标: SR(成功率):机器人停止在目标0.25米内即判定成功; SPL(路径加权成功率):数值越高代表行走路径越短、效率越高; 实体机器人测试:Unitree Go2四足机器人+Intel RealSense D435i深度相机,覆盖室内走廊、大厅、户外陌生场景。
2. HM3D-OVON主数据集:大幅刷新SOTA
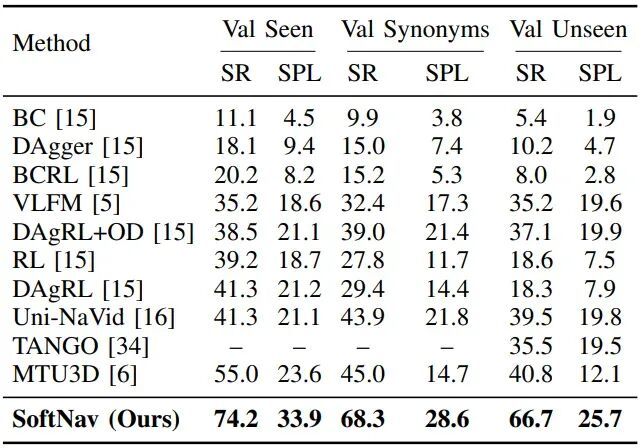 SoftNav在全部3个验证集全面碾压过往最优方案MTU3D,成功率提升19.2~25.9个百分点,路径效率同步登顶。
3. 零样本跨任务泛化:一套模型通吃多导航任务
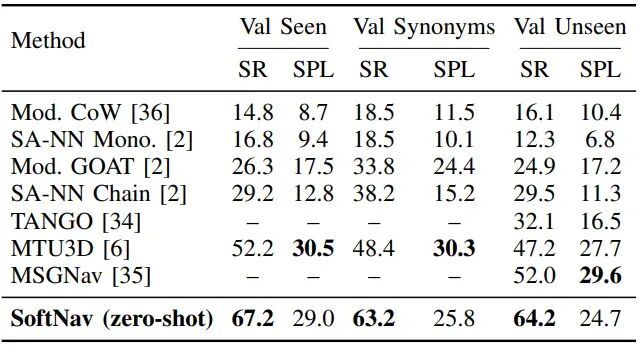
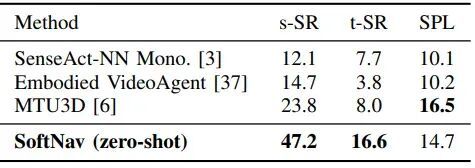
模型仅在OVON数据集完成训练,不做任何微调直接迁移至其他两大基准:
GOAT-Bench多模态导航:val_seen成功率67.2%,远超基线MTU3D的52.2%; SG3D场景图导航:子任务成功率s-SR=47.2%,相比历史最优提升23.4个百分点。
仅SPL指标小幅下降,属于高成功率带来的正常权衡:机器人能找到更多目标,但陌生环境下会走稍长路线。
4. 核心消融实验:实锤文本表征鸿沟
固定3D编码器、VLM、训练数据完全不变,仅更换3D信息传输方式,差距一目了然: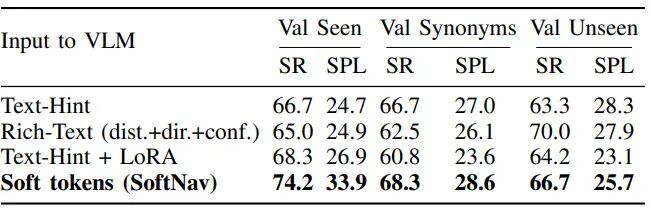 统计检验结果极具说服力:对比文本基线,SoftNav的SPL提升9.2pp(p<0.0001),SR提升7.5pp(p=0.028); UMAP特征可视化直观证明:文本转译会彻底破坏3D嵌入自带的语义聚类结构,而MLP投影后的软Token能完整保留特征聚类关系。
5. 真机部署测试:仿真算法直接落地实体机器人
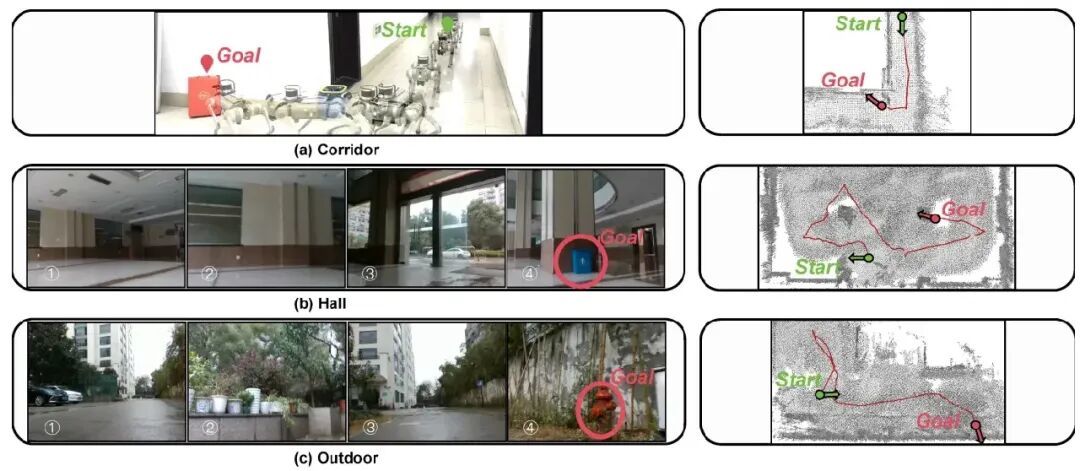
在Unitree Go2四足机器人上完成30组测试(走廊10次、大厅10次、户外10次),整体综合成功率63.3%:
室内走廊:8/10成功 室内大厅:6/10成功 户外场景:5/10成功
户外环境完全脱离训练用的室内场景分布,依旧能稳定完成导航,充分证明SoftNav强大的仿真到真实世界迁移能力。
6. 推理效率分析
单步完整推理耗时约1s(RTX4090显卡):
PQ3D 3D感知:0.45s VLM大模型推理:0.49s MLP软Token投影:仅0.07ms,几乎无额外开销
整套注入架构不绑定特定3D编码器或VLM,后续可自由替换更轻量化模型实现提速。
?全文总结
核心结论
用文本转述3D空间信息存在无法弥补的表征鸿沟,单纯扩充文字描述、微调大模型LoRA都不能彻底解决信息损耗问题; SoftNav通过轻量MLP将3D实体连续特征转为软Token直灌VLM,全程冻结预训练大模型与3D感知模块,仅17M可调参数、千条训练样本就能拿下导航赛道SOTA; 单套训练策略具备跨任务零样本泛化能力,无需适配即可部署真实四足机器人,打通仿真环境到实体机器人的落地链路。
未来优化方向
兼容更多类型3D场景编码器,验证框架通用适配性; 扩充训练数据集,进一步提升陌生环境下的路径规划效率; 优化感知与VLM推理速度,降低单步延迟,满足机器人实时导航需求。
