


来源:数策智合
原文链接:https://mp\.weixin\.qq\.com/s/kEaqXJ5BGpqXjgd1mrT71Q?scene=1
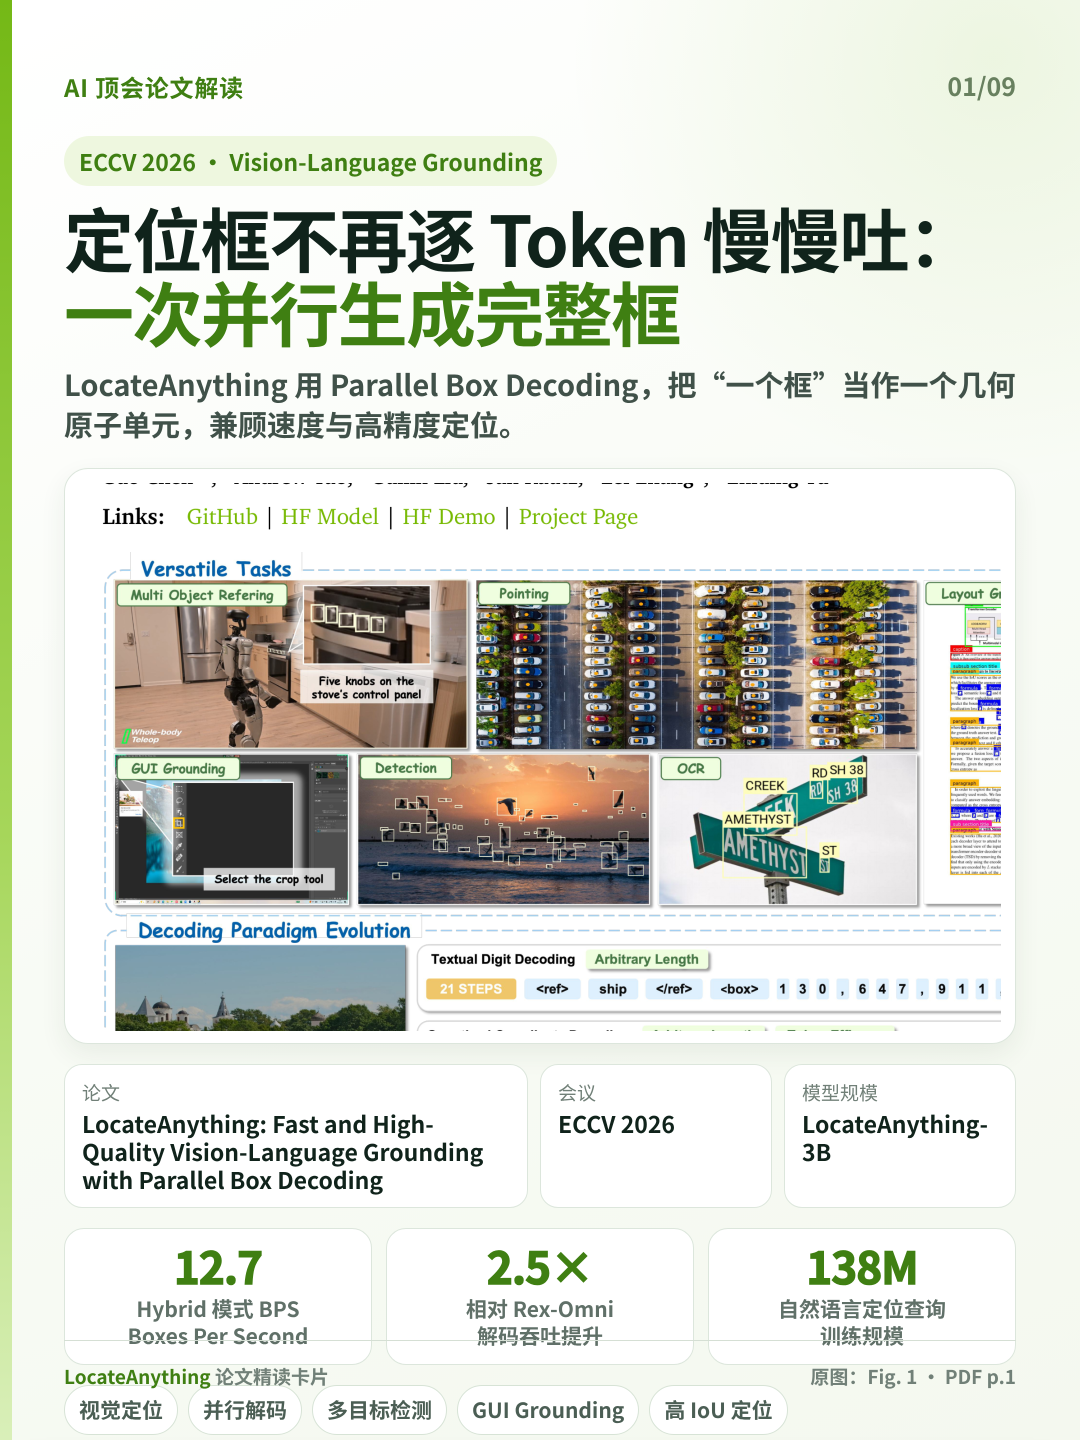
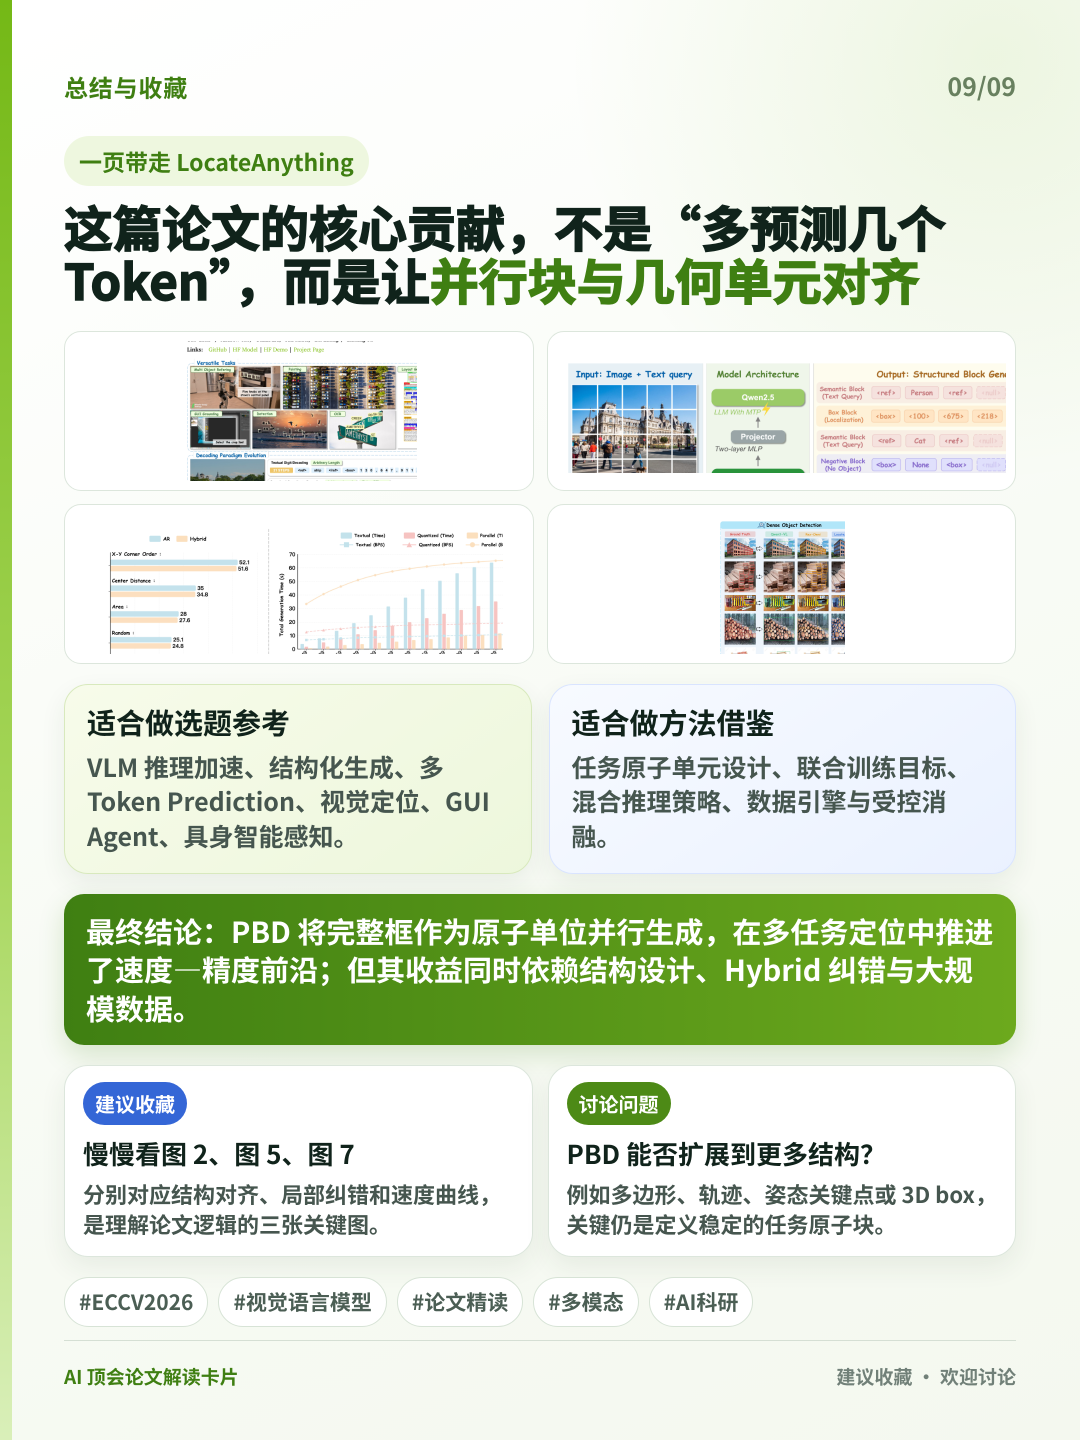
⚡ ECCV 2026 的 LocateAnything 给出了一条更结构化的路线:把完整 bounding box 当成一个几何原子单元,一次并行解码。
? 论文:LocateAnything: Fast and High-Quality Vision-Language Grounding with Parallel Box Decoding ? 会议:ECCV 2026
? 我觉得最值得关注的 5 个点:
01|? 并行的不是任意 Token,而是完整框
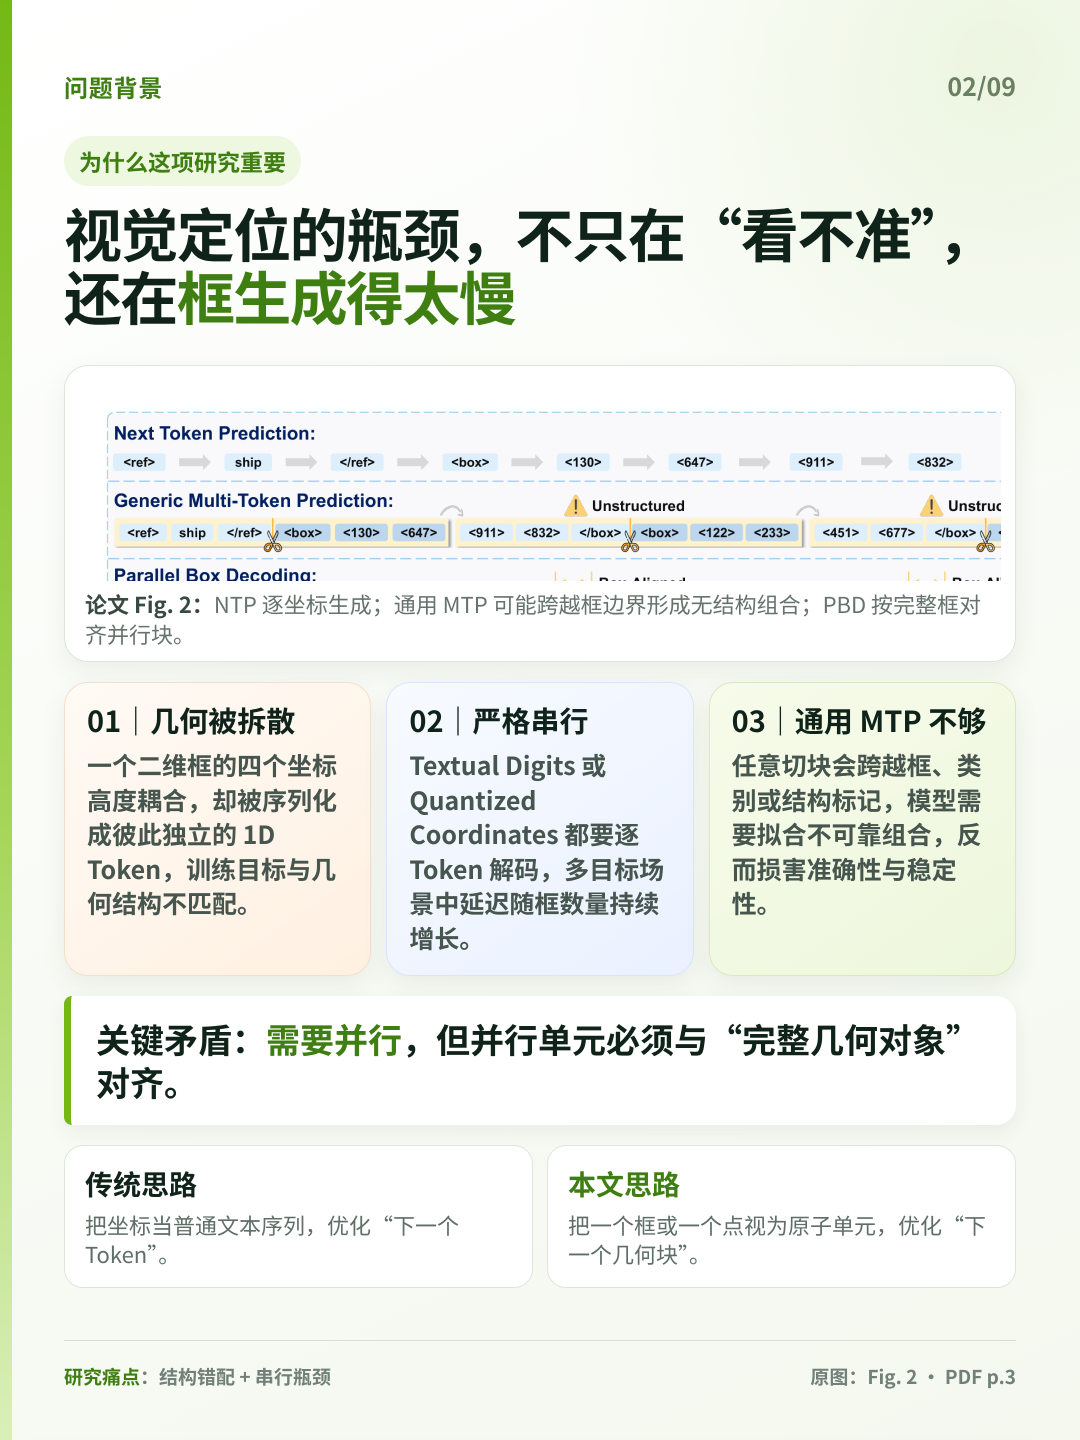
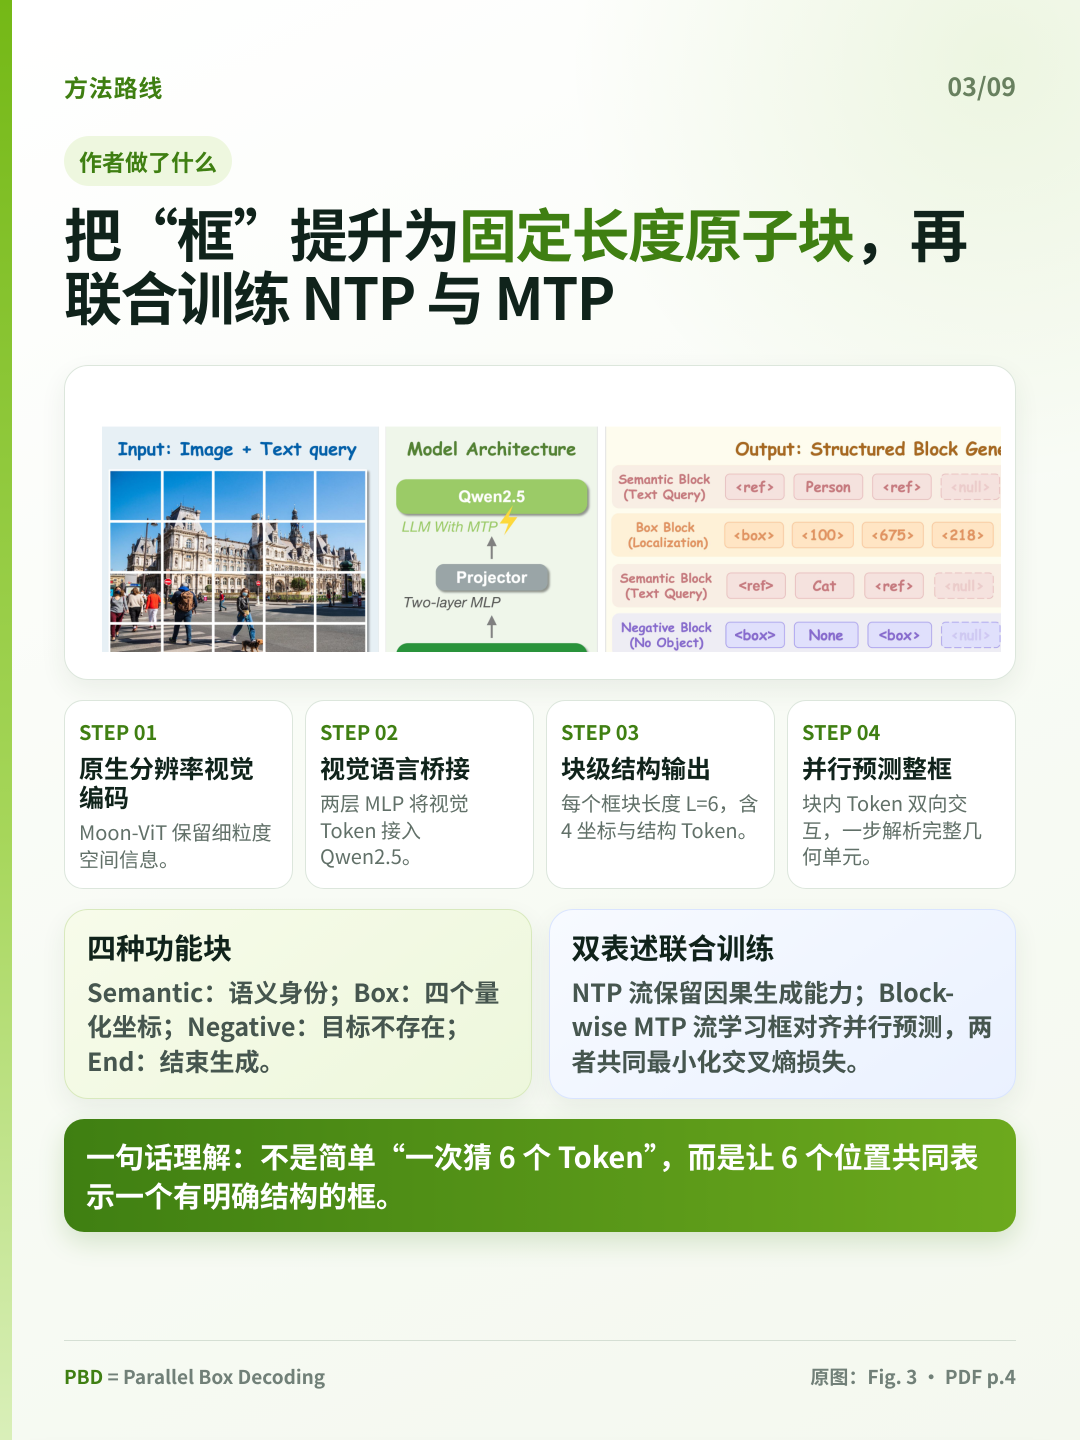
传统 VLM 会把 x1、y1、x2、y2 串行生成;通用 MTP 又可能跨越框边界切块。PBD 让并行块与 box 对齐,块内坐标共同建模。
02|? 速度提升不是靠牺牲全部精度
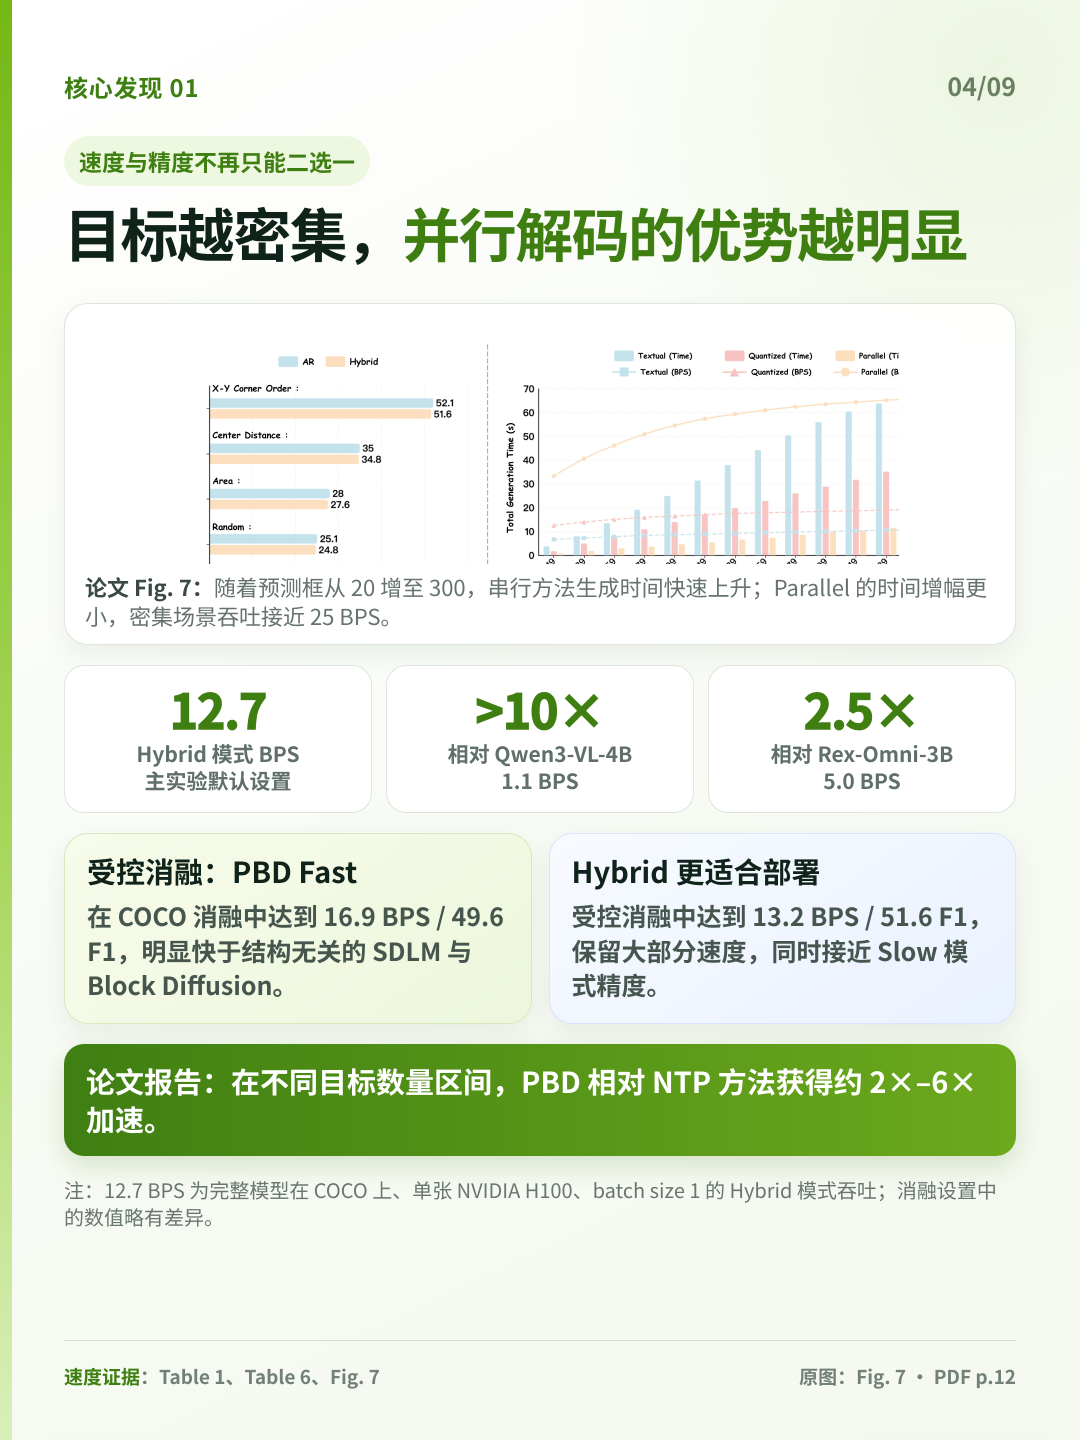
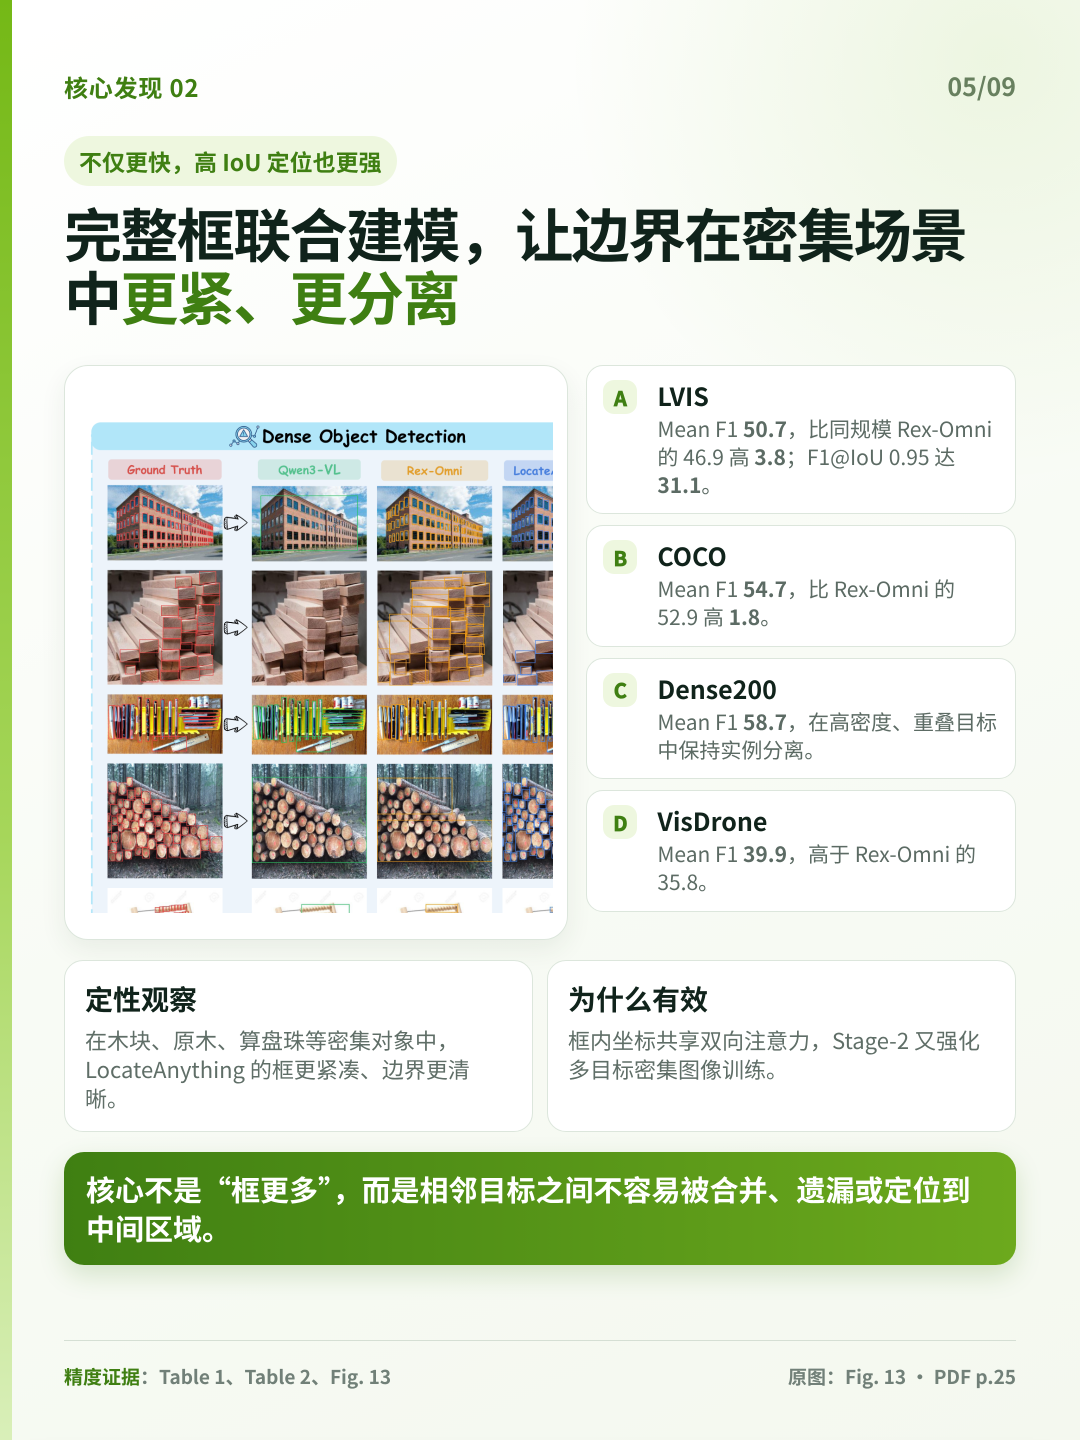
LocateAnything-3B 在默认 Hybrid 模式下达到 12.7 BPS,超过 Qwen3-VL-4B 的 10 倍,并达到 Rex-Omni-3B 的 2.5 倍;LVIS 与 COCO 的 mean F1 也分别提升 3.8 和 1.8。
03|?️ Hybrid Mode 很有工程感
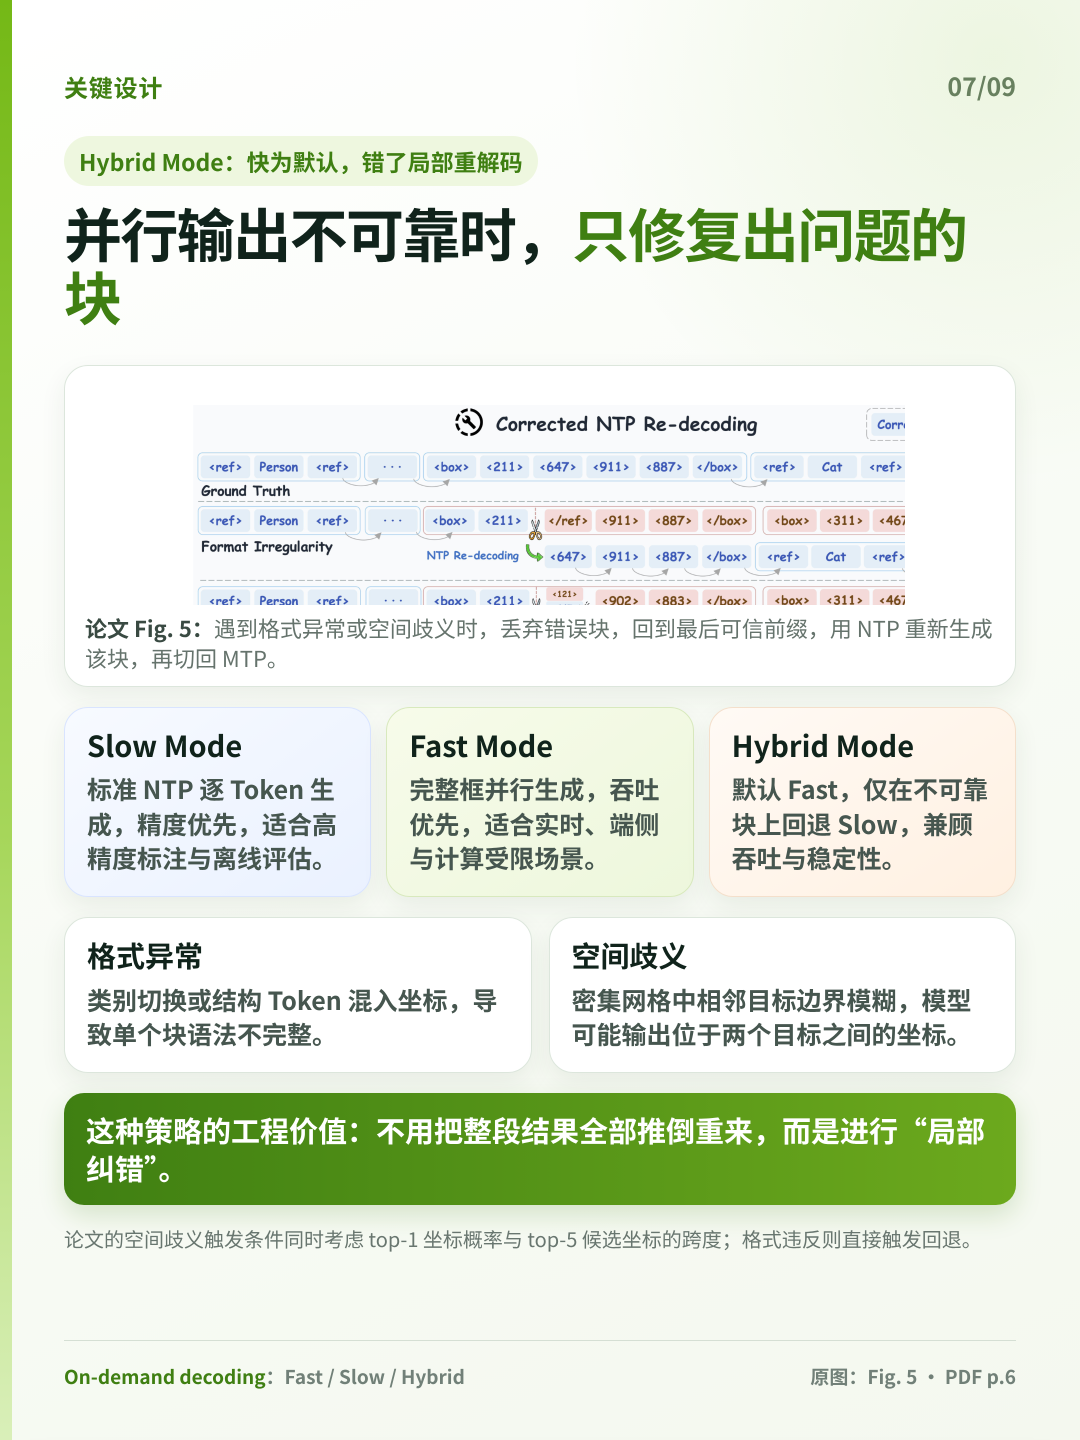
模型默认并行生成;遇到格式异常或空间歧义,只丢弃出问题的块,用 NTP 局部重解码,再切回并行模式,不需要整段重来。
04|? 密集场景更能体现优势
在 Dense200、VisDrone 以及木块、原木、算盘珠等高密度案例中,预测框更紧凑、分离更清晰。随着目标数增加,并行解码的吞吐优势进一步放大。
05|?️ 数据规模同样关键
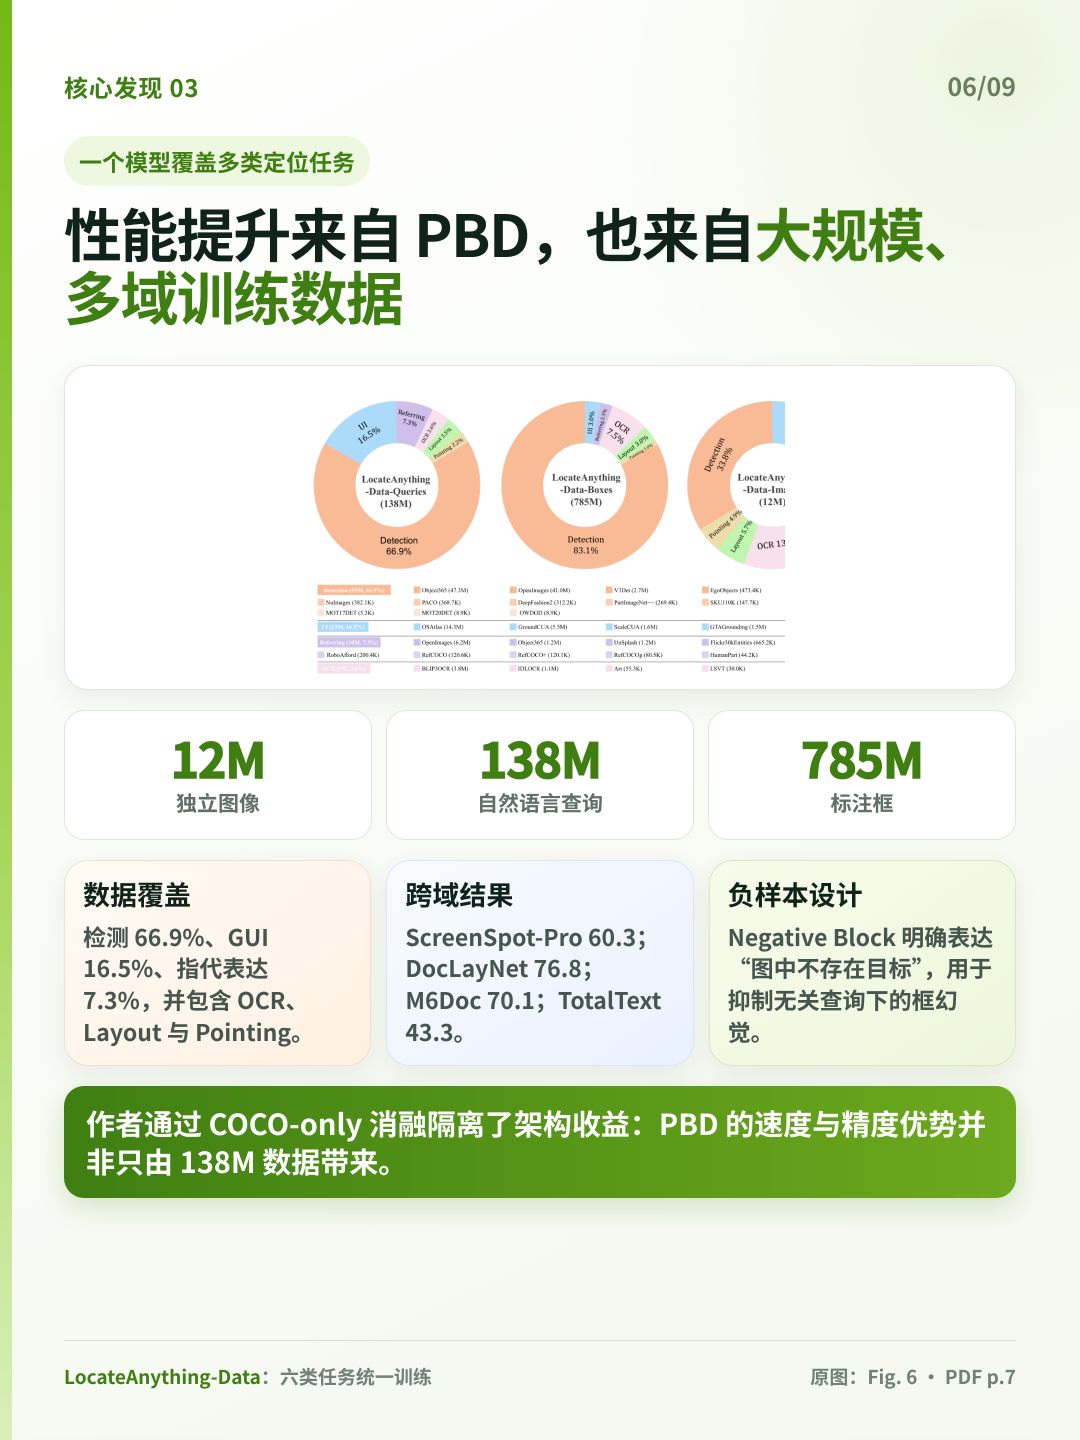
LocateAnything-Data 包含 12M 图像、138M 自然语言查询和 785M 标注框,覆盖检测、GUI、指代表达、OCR、Layout 与 Pointing 六类任务。
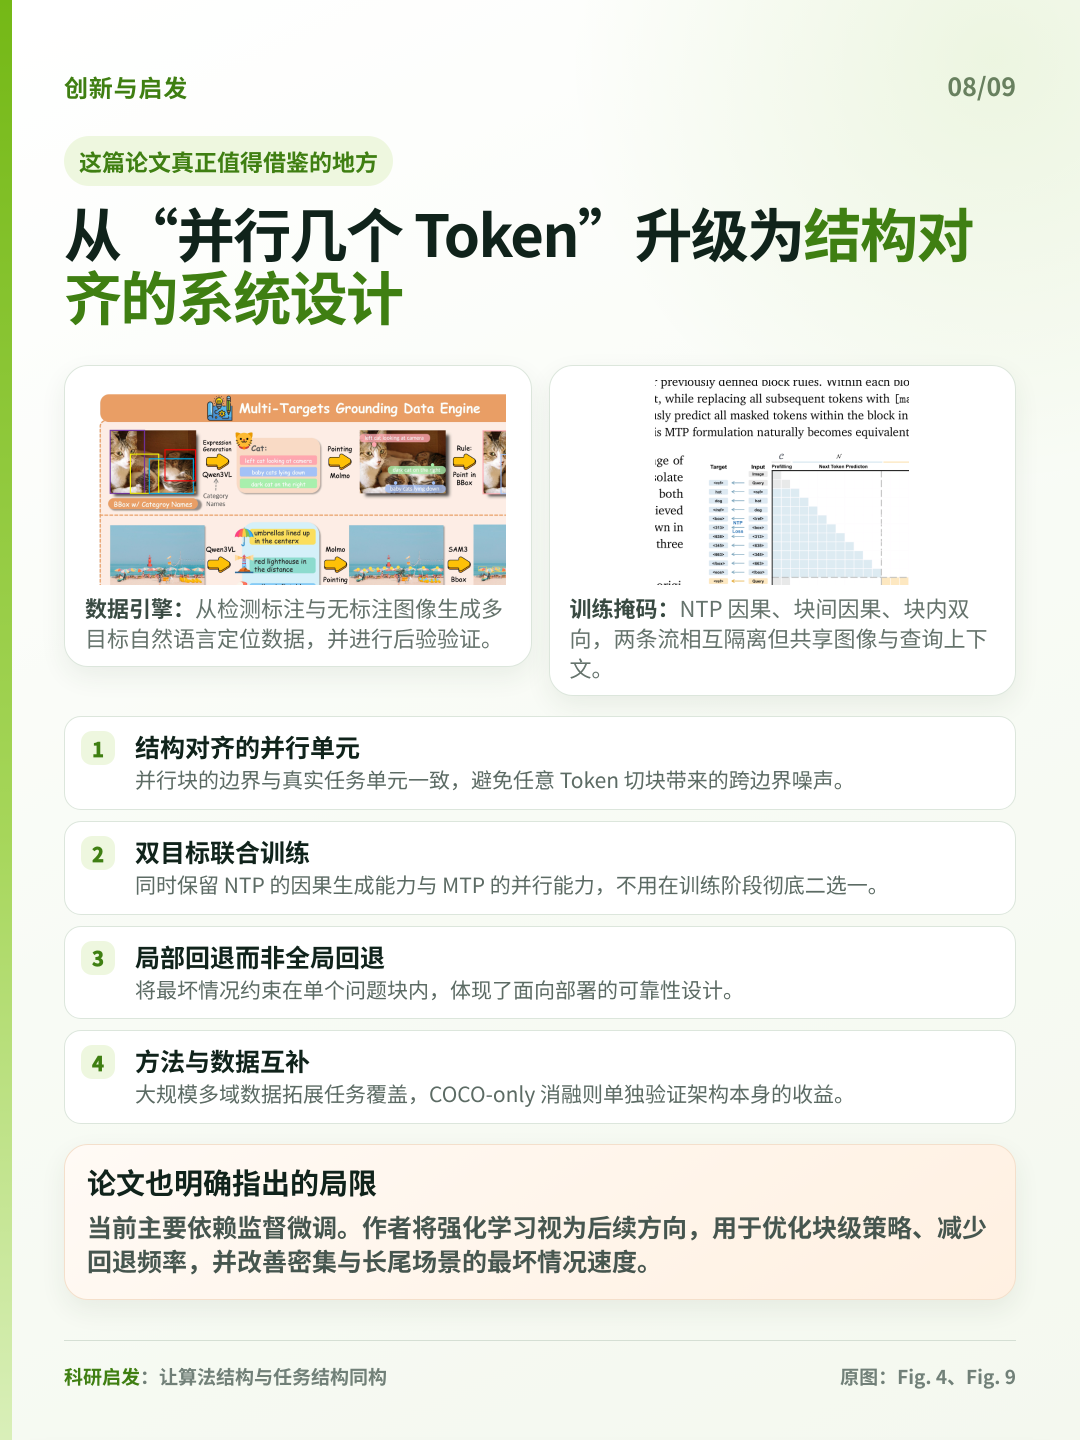
? 这篇论文最有启发性的地方,不是“同时猜更多 Token”,而是先找到任务真正的结构单元,再围绕它设计训练目标、注意力和回退策略。
? 你觉得这种 box-aligned block 思路,下一步最适合扩展到关键点、轨迹,还是 3D box?
#ECCV2026 #视觉语言模型 #多模态 #论文精读 #目标检测 #视觉定位 #GUIAgent
原文链接: https://www.leiphone.com/category/private/NgUdEaWCHhct0LsW.html
