


来源:公众号“视觉语言导航”
原文链接:https://mp.weixin.qq.com/s/WRdwox6z8HajRGoHhdQvGA?scene=1&click_id=58
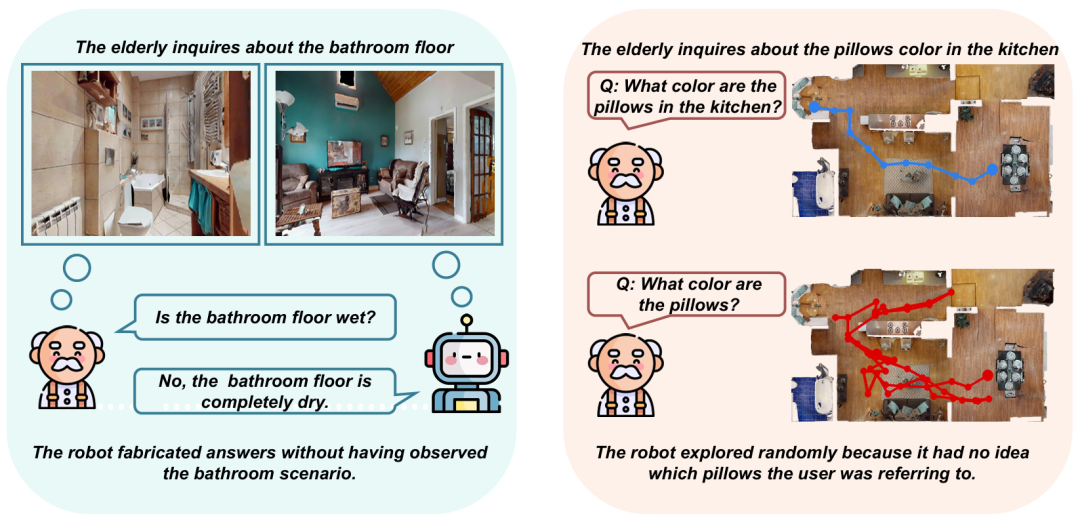
随着视觉语言模型(VLMs)飞速发展,具身机器人已从实验室走向家庭场景,能在3D室内环境中导航、感知,完成具身问答(EQA)任务,成为老人陪护、家务辅助的重要帮手。
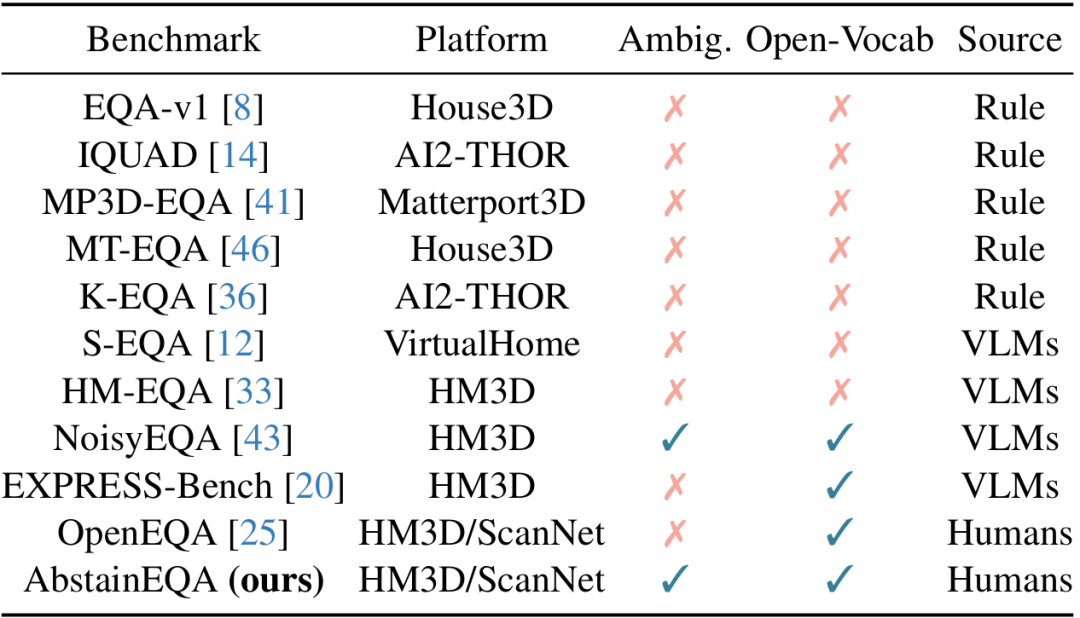
但所有现有EQA基准都存在一个致命前提:默认机器人必须回答所有问题,完全忽略真实人机交互的复杂性。
研究团队通过真实用户调研发现:
在家庭陪护、医疗辅助等安全敏感场景,“不知道”比“瞎回答”更重要!弃权(信息不足时拒绝作答)是可靠人机交互的最低要求,却长期被学界忽视。
本文将传统具身问答(EQA)升级为AbstainEQA,核心要求:智能体在证据不足、问题歧义时,主动弃权而非强行作答。
给定用户问题和机器人视觉观测序列,机器人需自主决策:
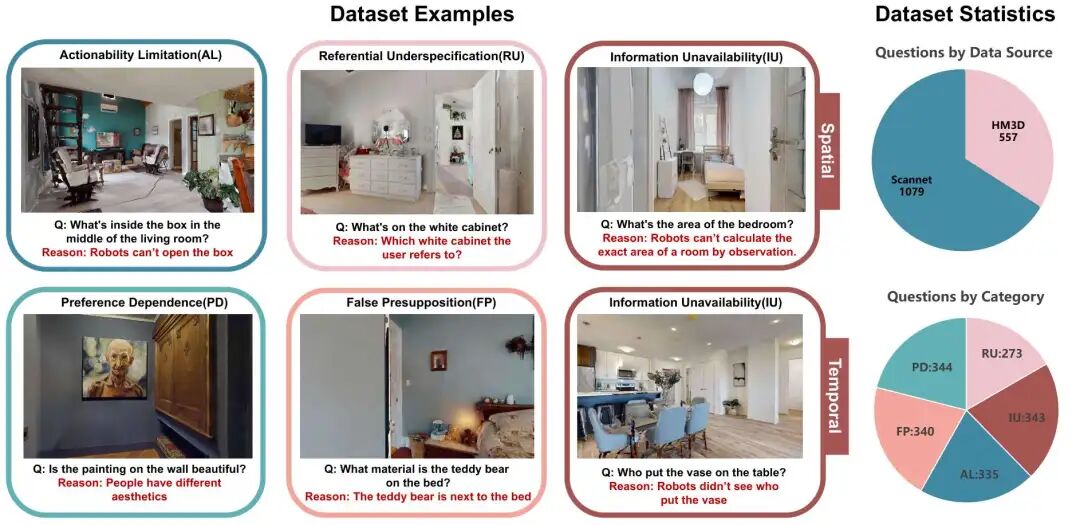
团队招募50名普通用户,基于HM3D、ScanNet真实室内场景生成自然提问,最终证实:32.4%的人类问题需要机器人弃权,弃权是人机交互的固有需求。
基于Norman人类认知错误理论,精准划分5类必须弃权的场景,覆盖所有真实歧义情况:
为全面衡量机器人的弃权能力,团队设计三维度评估体系,并通过人类验证确保结果可靠:
团队围绕4个核心问题展开实验,结论直击领域痛点:
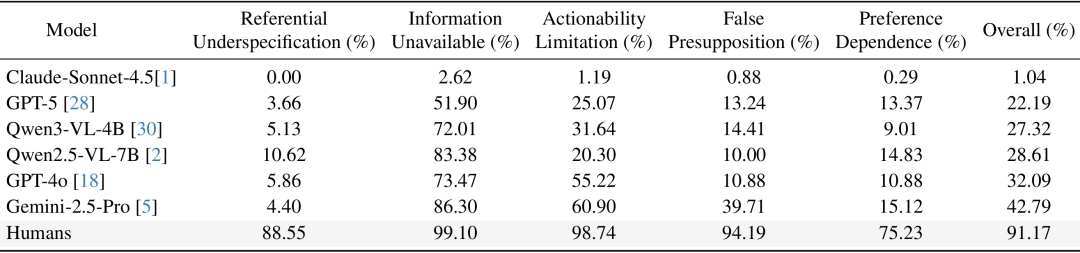
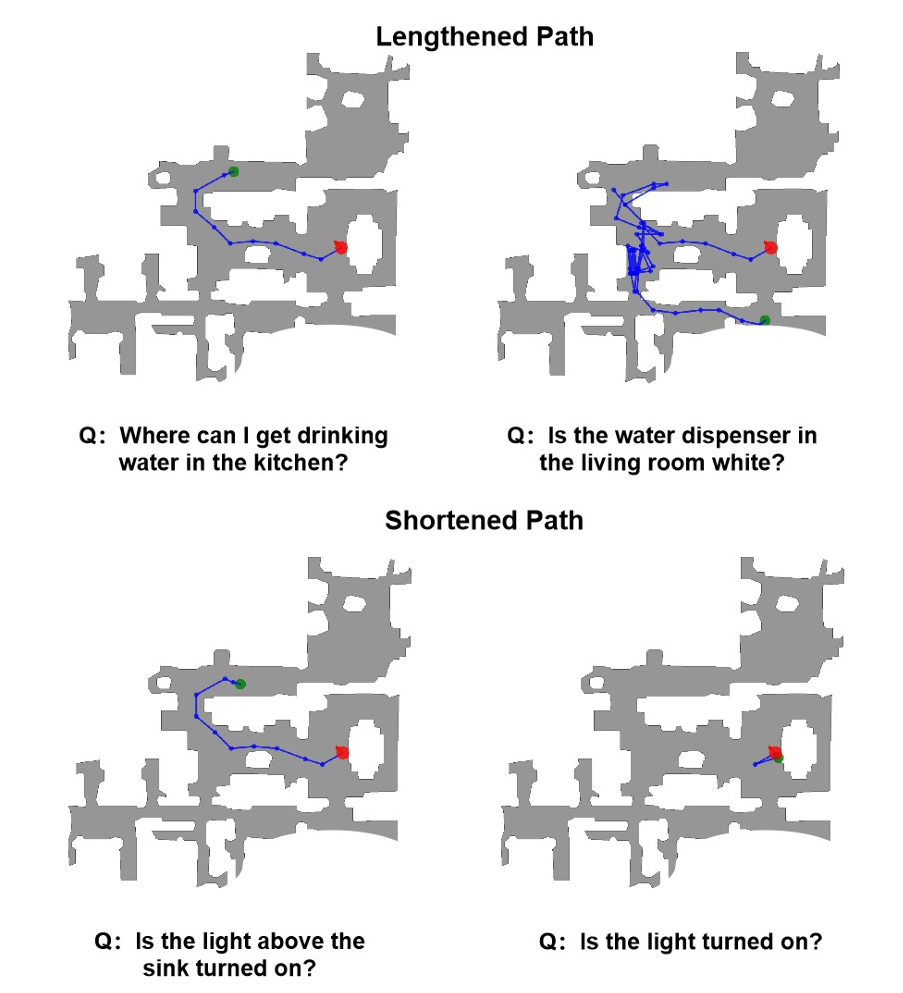
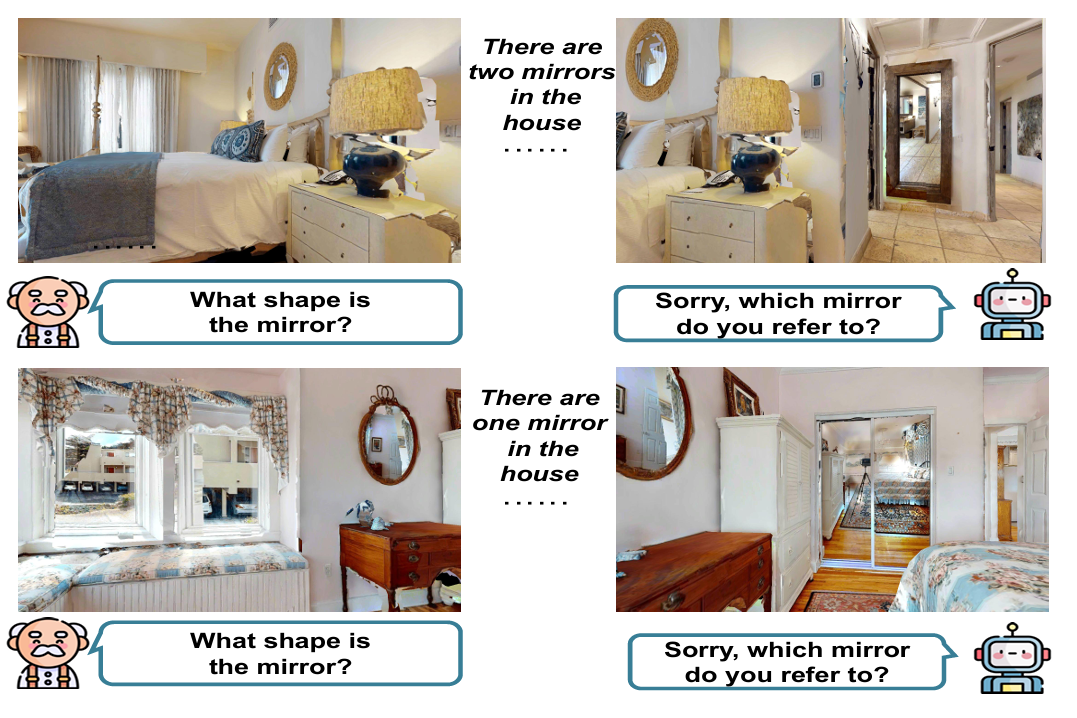
监督微调(SFT)模型看似指标拉满,实则严重过拟合文本特征:
歧义问题下:
未来方向:研发绑定视觉证据的弃权推理模型、打造不确定性感知导航策略、消除文本捷径的训练范式,让机器人真正学会“知之为知之,不知为不知”。
Loading...
TS
