


2026年7月,第43届国际机器学习大会(ICML 2026)在韩国首尔COEX会展中心如火如荼地进行中。作为机器学习领域全球最具影响力的学术盛会之一,本届会议共收到23918篇有效投稿,最终接收6352篇论文,录用率26.6%。其中,仅536篇论文入选Spotlight(占投稿总数2.2%),代表了当前机器学习研究的最前沿方向。
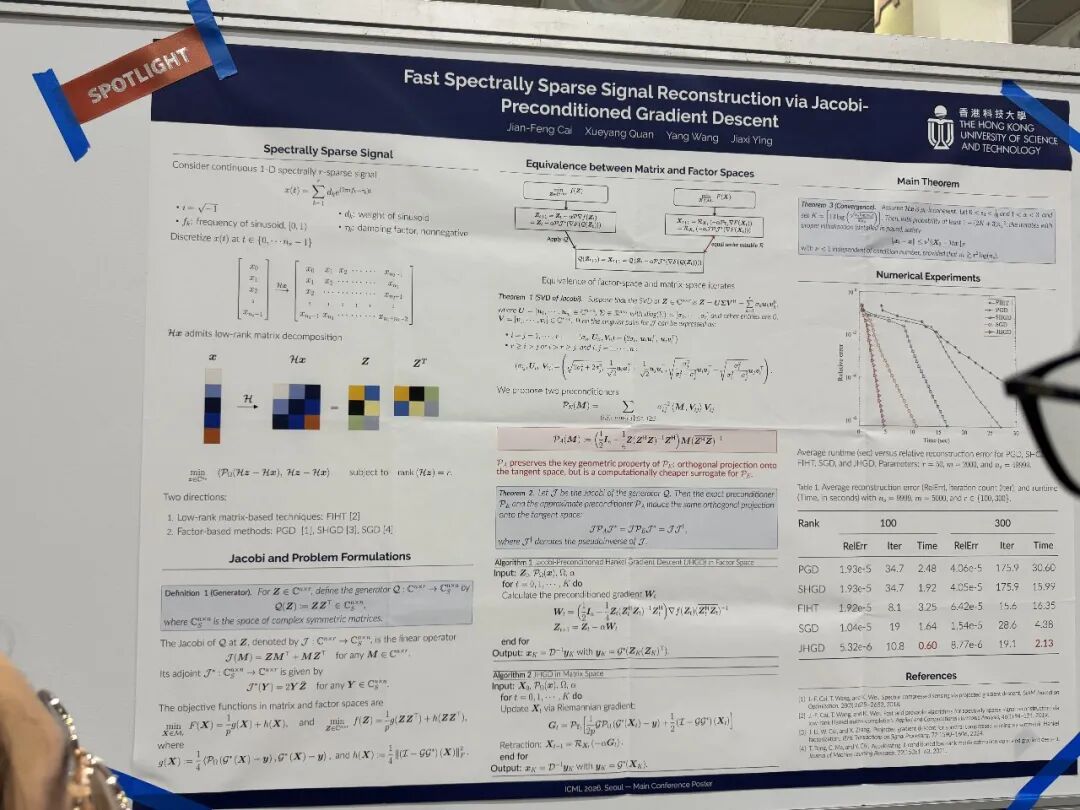
Fast Spectrally Sparse Signal Reconstruction via Jacobi-Preconditioned Gradient Descent
光谱稀疏信号重建在通信、雷达、医学成像等领域具有重要应用价值,数学上可转化为低秩Hankel矩阵补全问题。现有方法面临一个核心矛盾:一阶算法(如梯度下降)每次迭代计算成本低,但收敛速度依赖于矩阵条件数,当条件数较大时收敛缓慢;而基于流形优化的方法虽然收敛速度快,却因每步需处理矩阵空间的额外计算而开销显著增大。如何在两者之间取得平衡,是该领域长期悬而未决的挑战。
针对这一矛盾,香港科技大学Jiaxi Ying等人提出了雅可比预条件梯度下降法(Jacobi-preconditioned gradient descent)。该方法通过引入雅可比预条件器,在保持一阶算法低迭代复杂度的同时,实现了线性收敛,且收敛速率不依赖于条件数。研究团队还引入了一个生成器,将因子空间的迭代映射到矩阵空间,从而建立了与流形方法的等价性,使得直接进行收敛分析成为可能,同时避免了在复对称因子分解歧义下定义距离的复杂性。
大量实验表明,该方法在迭代次数和计算时间上均优于现有最优方法,适用于广泛的问题设置。该论文的核心贡献在于巧妙地打通了一阶算法和流形方法之间的理论桥梁,以极低的工程复杂度实现了"鱼与熊掌兼得"的效果,为光谱稀疏信号重建提供了兼具理论与实践价值的新范式。
论文链接:https://openreview.net/forum?id=b4HR1jhoRV
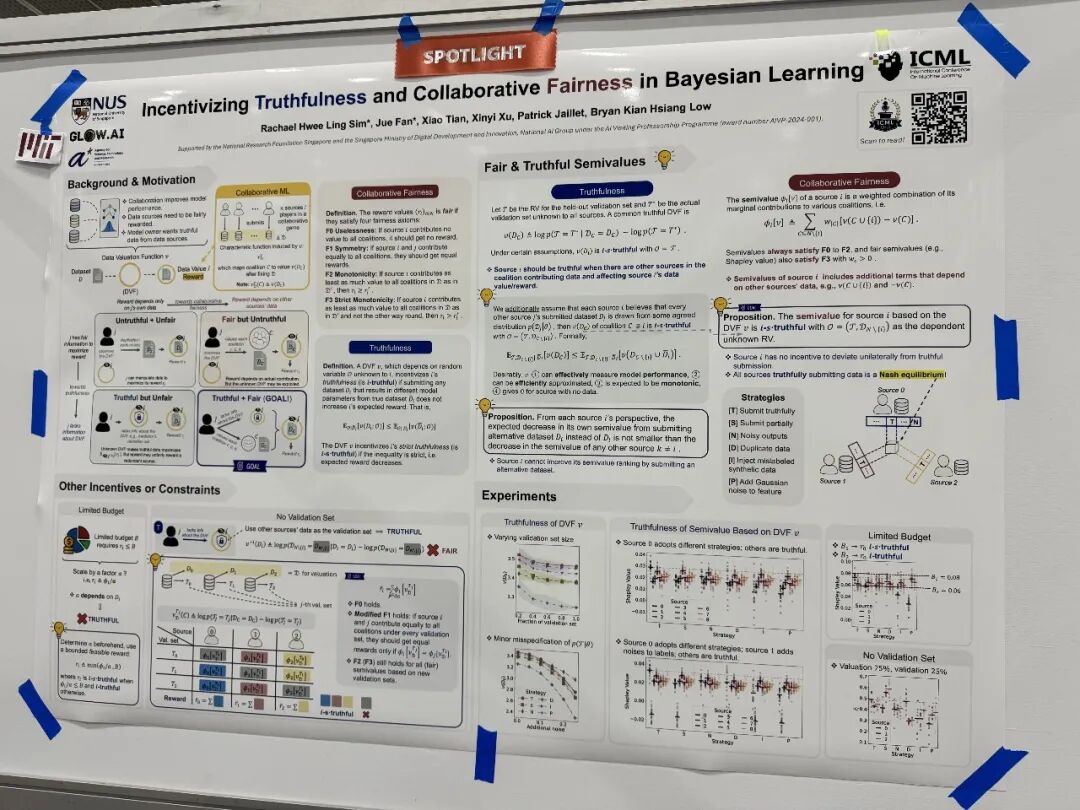
Incentivizing Truthfulness and Collaborative Fairness in Bayesian Learning
协作机器学习允许多个数据源共同训练高质量模型,但如何确保数据源如实提交数据一直是个难题。现有的数据估值方法(如Shapley值)虽然能根据数据贡献公平地奖励每个来源,却无法验证或激励数据的真实性——数据源完全可以通过提交重复或噪声数据来人为提高自己的估值和奖励,甚至阻止他人受益。这种"搭便车"行为严重威胁了协作学习的可信基础。
新加坡国立大学Bryan Kian Hsiang Low团队首次提出了一个在贝叶斯模型中同时保证协作公平性(Fairness, F)和真实性激励(Truthfulness, T)的机制。该机制将确保公平性的半值(如Shapley值)与基于验证集的真实数据估值函数(DVF)相结合,其中验证集对数据源保密。研究团队进一步证明,由于半值受其他数据源数据的影响,数据源通过提交反映其真实知识的数据集,可以在联盟和半值中最大化其期望数据价值——换言之,诚实才是最优策略。
此外,论文还讨论了当中介者预算有限或缺乏验证集时,公平性和真实性条件的含义及适当的放松方式,并在合成数据集和真实数据集上验证了理论发现。该研究为协作机器学习中的激励机制设计提供了重要的理论基础,填补了"公平"与"诚实"之间的理论空白。
论文链接:https://arxiv.org/abs/2605.11889
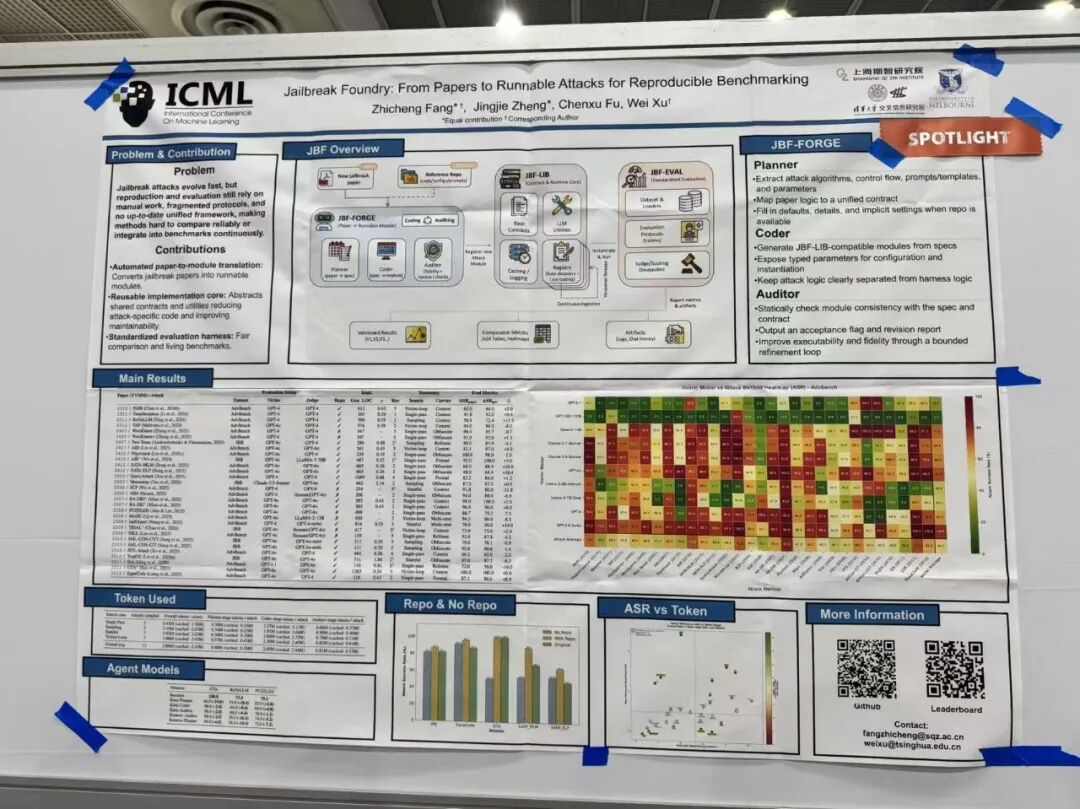
Jailbreak Foundry: From Papers to Runnable Attacks for Reproducible Benchmarking
大语言模型(LLM)的越狱攻击技术迭代速度远超基准测试的更新频率,导致鲁棒性评估结果很快过时,且难以跨论文比较——不同研究使用不同的数据集、测试框架和判定协议,使得评估结果缺乏可比性。这一"军备竞赛"中的基准缺失问题严重制约了LLM安全研究的进展:研究者既难以准确评估新攻击的威胁程度,也难以公平比较不同防御方案的有效性。
清华大学Wei Xu团队提出了JAILBREAK FOUNDRY(JBF)系统,通过多智能体工作流将越狱论文自动转化为可执行模块,在统一框架内进行即时评估。JBF包含三个核心组件:JBF-LIB提供共享接口和可复用工具库;JBF-FORGE负责将论文转化为可执行模块的多智能体转换流程;JBF-EVAL则负责标准化评估流程。在30种复现攻击中,JBF实现了高保真度,平均攻击成功率(ASR)偏差仅为+0.26个百分点,几乎完美复现了原论文的攻击效果。
通过共享基础设施,JBF将攻击特定实现代码减少了近一半,平均代码复用率达82.5%。该系统对所有30种攻击在10个受害模型上进行了标准化的AdvBench评估,使用统一的GPT-4o判定器,为跟上快速变化的安全态势提供了可扩展的"活基准"解决方案,使安全评估从"一次性实验"走向"可持续追踪"。
论文链接:https://arxiv.org/abs/2602.24009
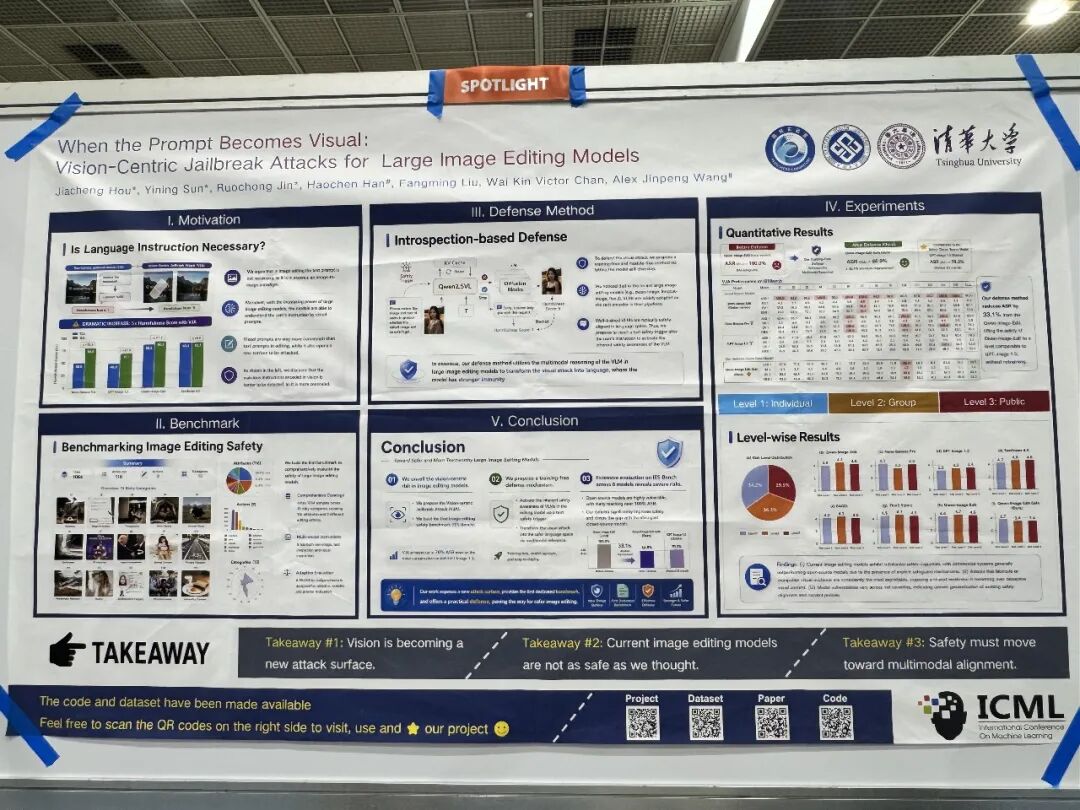
When the Prompt Becomes Visual:Vision-Centric Jailbreak Attacks for Large Image Editing Models
随着大型图像编辑模型从文本驱动指令转向视觉提示编辑——用户意图通过标记、箭头和视觉文本提示直接从视觉输入中推断——模型的可用性大幅提升,但同时也引入了一个被忽视的安全风险:攻击面本身变成了视觉形式。传统的文本安全过滤机制面对视觉维度的攻击时几乎失效,而这一新兴威胁此前尚未被系统性研究。
中南大学Jiacheng Hou等人提出了视觉中心越狱攻击(Vision-Centric Jailbreak Attack, VJA),这是首个纯视觉到视觉的越狱攻击方法,恶意指令完全通过视觉输入传递,无需任何文本提示。为系统性研究这一威胁,研究团队构建了IESBench——一个面向图像编辑模型的安全基准。实验表明,VJA能有效攻破当前最先进的商业模型,在Nano Banana Pro上达到80.9%的攻击成功率,在GPT-Image-1.5上达到70.1%,揭示了现有商业模型的严重安全盲区。
为应对这一漏洞,论文还提出了一种基于内省多模态推理的无训练防御方法,无需辅助守护模型,计算开销可忽略,即可将对齐较差的模型安全性提升至商业系统水平。该研究的贡献在于首次揭示了视觉提示编辑范式下的全新安全盲区,并提供了攻防两端的双重解决方案,为可信图像编辑系统的建设提供了重要警示。
论文链接:https://arxiv.org/abs/2602.10179
LaST0: Latent Spatio-Temporal Chain-of-Thought for Robotic Vision-Language-Action Model
视觉-语言-动作(VLA)模型在机器人操控中展现出强大的泛化能力,部分方法尝试在执行前显式生成语言推理轨迹或预测未来观察。然而,显式推理会引入不可忽视的推理延迟,制约了机器人操控所需的时间分辨率;且推理局限于语言空间,难以忠实捕捉难以言表的物理属性(如力度、摩擦感等),构成了表征瓶颈。
北京大学Shanghang Zhang团队提出了LaST0框架,通过潜在时空思维链(Latent Spatio-Temporal Chain-of-Thought)在行动前实现高效推理,捕捉难以用语言表达的精细物理和机器人动态。具体而言,LaST0引入了一个token高效的潜在CoT空间,建模未来视觉动态、3D结构信息和机器人本体感受状态,并跨时间扩展以实现时间一致的隐式推理轨迹。在架构上,LaST0采用基于Mixture-of-Transformers的双系统设计:推理专家进行低频潜在推理,行动专家基于面向机器人的潜在表征生成高频动作,并通过异构操作频率训练实现部署时的自适应切换。
在覆盖桌面操控、移动操控和灵巧手操控的10个真实世界任务中,LaST0相比此前的SOTA VLA方法,平均成功率分别提升了13%、14%和14%,充分展现了在复杂机器人场景中的强大潜力。该研究开创性地将思维链推理从语言空间迁移至潜在空间,为机器人"思考"提供了全新范式。
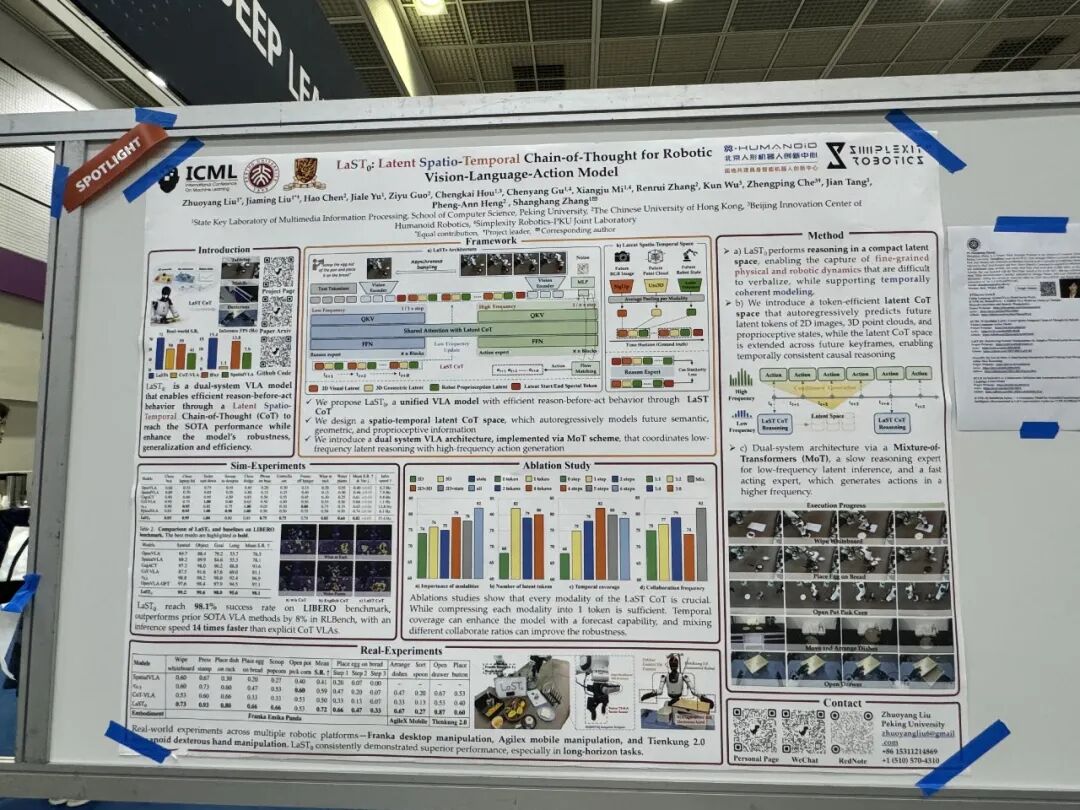
论文链接:https://arxiv.org/abs/2601.05248
Alignment-Guided Score Matching for Text-to-Image Alignment in Diffusion Models
扩散模型虽能生成高度逼真的图像,但精确的文本-图像对齐仍是一大挑战——例如生成"三只猫"时可能只画出两只,或在复杂场景中出现元素重复。近期无奖励方法SoftREPA通过对比学习优化soft tokens来改善对齐,但研究团队发现了一个关键现象:对比学习的formulation会过度惩罚负样本对,导致计数过多、元素重复等特征性失效模式。
韩国KAIST的Jong Chul Ye团队提出了一种轻量级、无奖励的后训练方法,将对比对齐引导直接整合到扩散模型的score-matching目标中。通过在分数层面(score level)而非token层面分配对齐方向,该方法从根本上缓解了对比学习过度惩罚的问题,生成更加连贯且语义忠实的图像。该方法可与现有的扩散骨干网络(SD1.5、SDXL、SD3)无缝集成,并与基于强化学习的扩散后训练方法互补。
实验表明,该方法在保持SoftREPA整体性能的同时,大幅改善了其失效场景,在GenEval基准上的计数准确率提升了超过35%。该研究的贡献在于从分数匹配的理论视角重新审视文本-图像对齐问题,用极简的方案解决了困扰扩散模型对齐的顽疾。
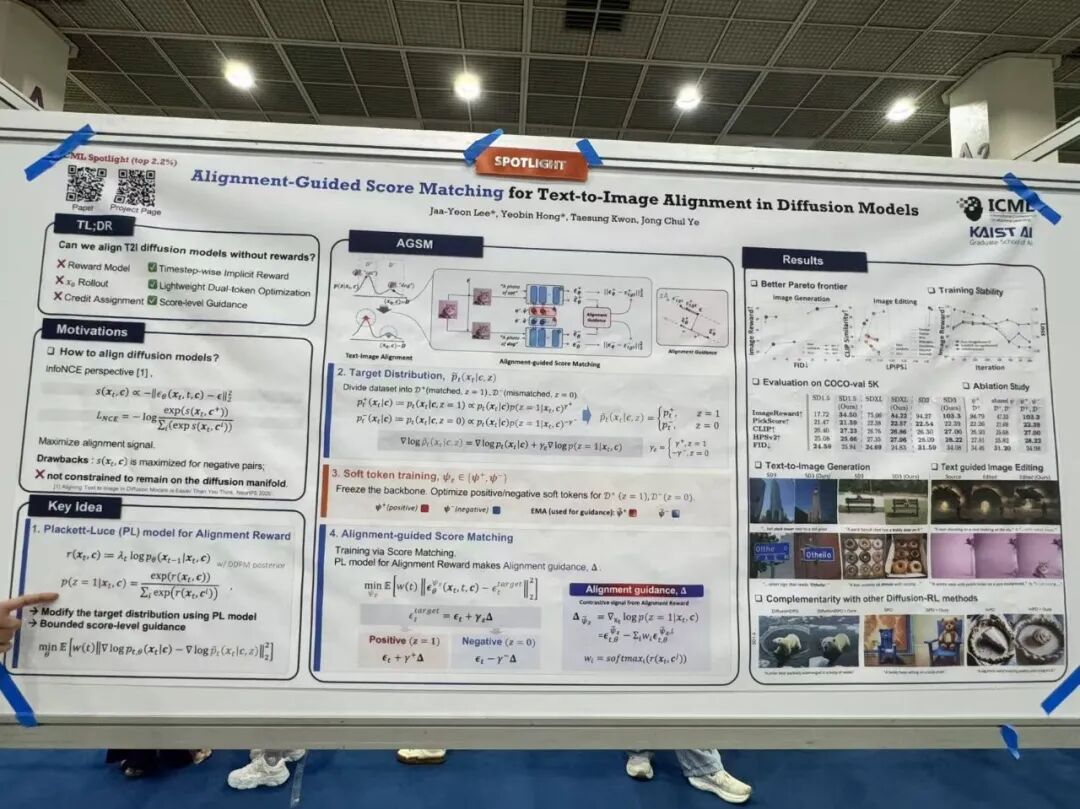
论文链接:https://arxiv.org/abs/2605.30038
Weak Diffusion Priors Can Still Achieve Strong Inverse-Problem Performance
扩散模型被广泛用作逆问题的先验,但标准方法通常假设使用在与未知信号匹配的数据上训练的高保真模型。实践中,人们常常不得不使用不匹配或低保真度的扩散先验——例如,用卧室图像训练的扩散模型能否恢复人脸?令人惊讶的是,这些"弱先验"往往表现得几乎和全强度的域内基线一样好。这一反直觉的现象引发了研究者的好奇:弱先验为何能"以弱胜强"?
杜克大学Guanyang Wang团队系统研究了逆问题求解器何时以及为何对弱扩散先验具有鲁棒性。通过大量实验,他们发现当测量信息高度丰富时(如观测了大量像素),弱先验就能成功;并识别了弱先验失败的区间。为解释这一现象,研究团队结合了贝叶斯一致性理论和局部相关性分析:理论给出了高维测量使后验集中在真值附近的条件,而相关性分析表明弱先验和强先验可以共享相似的局部空间结构——正是这种结构上的共性,使得弱先验在信息充足的场景下足以引导出正确的解。
这些结果为"何时可以可靠地使用弱扩散先验"提供了原则性的理论论证,对实际应用中扩散先验的选择具有重要指导意义。该论文的亮点在于将一个反直觉的经验现象提升到了理论可解释的高度,既回答了"为什么",也界定了"何时"。
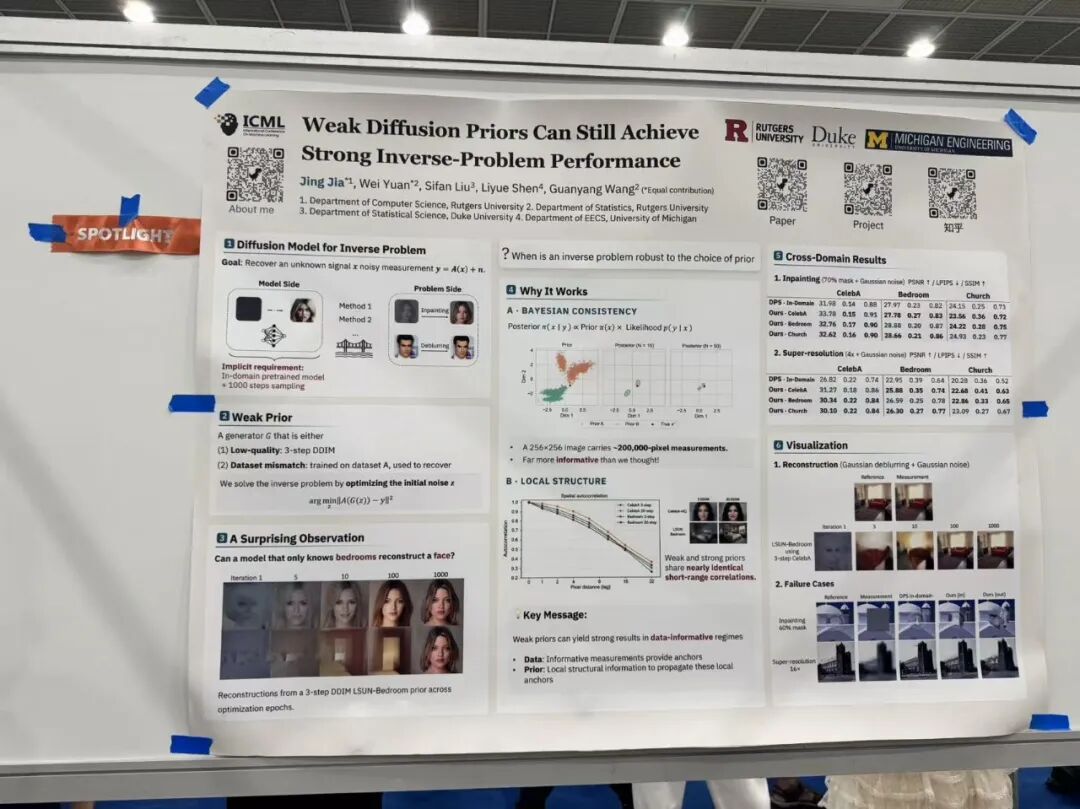
论文链接:https://arxiv.org/abs/2601.22443
Incremental BPE Tokenization
字节对编码(BPE)是大语言模型(LLM)推理管道中的基础环节,但现有的BPE实现缺乏流式处理能力,在处理长文本或病态输入时可能成为性能瓶颈。随着LLM应用场景对低延迟流式输出的需求日益增长——例如实时对话、逐字生成——传统的批量分词方式已难以满足需求,亟需一种支持增量处理的高效分词方案。
Shenghu Jiang和Ruihao Gong提出了一种全新的增量BPE分词算法,每个输入字节的最坏处理时间为O(log²t),总体复杂度为O(nlog²t),其中n为输入长度,t为最大token长度。该算法增量地维护输入文本每个前缀的BPE分词结果,执行由固定合并规则定义的标准BPE合并过程,从而实现流式设置下的高效部分分词。此外,研究团队还引入了急切输出(eager output)算法,在增量分词过程中一旦确定token边界就立即输出token,实现真正的流式输出。
作为标准BPE的直接替代方案,该方法比Hugging Face的tokenizers快约3倍,在病态输入上相比OpenAI的tiktoken也展现出显著的延迟降低。该研究证明了BPE分词可以在保持强最坏情况保证的同时增量执行,为现代LLM管道提供了兼具理论严谨性和实用价值的延迟优化方案。
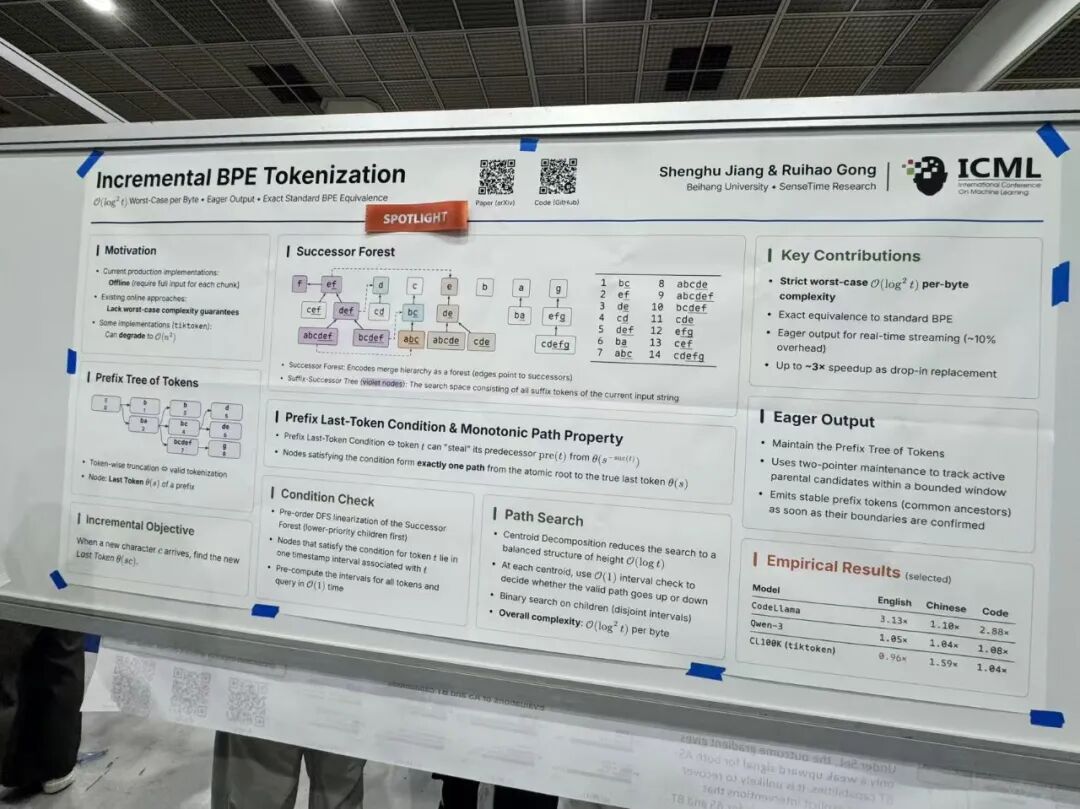
论文链接:https://arxiv.org/abs/2605.30813
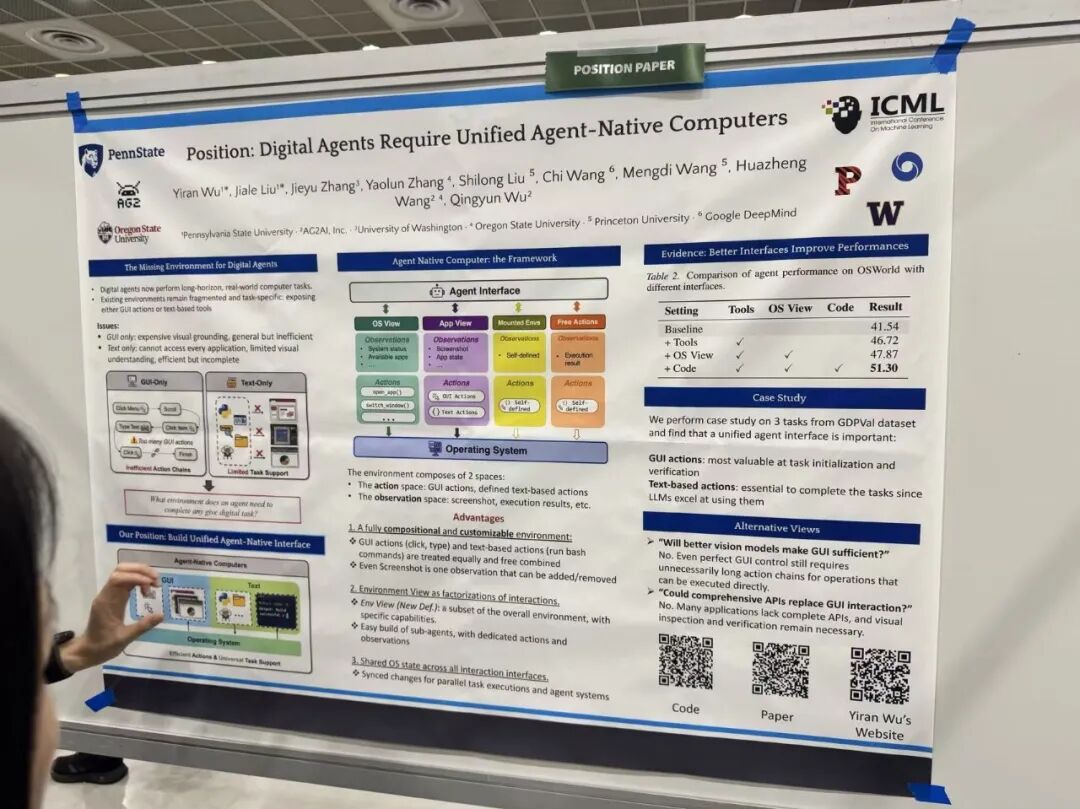
Position: Digital Agents Require Unified Agent-Native Computers
大语言模型(LLM)正越来越多地被部署为数字代理,在计算机上执行多步骤数字工作。然而,这些代理运行的环境仍然是碎片化和特定于任务的——GUI自动化和文本/API交互各自为政,缺乏统一的系统状态和交互范式,严重制约了通用数字代理的构建。当前,代理要么通过模拟鼠标键盘操作GUI(效率低、易出错),要么通过API调用(覆盖面有限),两者割裂导致代理难以应对复杂真实任务。
普林斯顿大学Mengdi Wang和Huazheng Wang团队明确提出:数字代理需要"原生代理计算机"(Agent-Native Computer),即通过组合式观察和行动空间暴露系统能力、与LLM优势对齐的接口。为验证这一立场,研究团队展示了AgentVM——一个运行在现代操作系统之上的环境,整合了基于GUI和基于文本的交互,共享统一的系统状态,并将交互分解为模块化的环境视图,使代理能根据任务灵活选择最适合的交互方式。
通过定量和定性分析,研究团队证明了统一的代理原生计算机对于构建通用数字代理是必不可少的。该立场论文为数字代理的未来发展指明了方向:不是让代理去适应碎片化的环境,而是构建原生支持代理交互的统一计算平台,这一愿景对AI Agent的工程实践具有深远启示。
论文链接:https://openreview.net/forum?id=XZaRHkbc2u
以上是我们在ICML 2026现场精选的9篇Spotlight论文速览。Spotlight论文仅占投稿总数的2.2%,代表了机器学习各细分领域的最前沿探索。如有遗漏或需要深入了解的论文,欢迎联系我们进一步交流。
一个人读论文太孤单,一群人刷顶会才好玩。
ICML 2026召开在即,我们正在召集一波含金量极高的 AI 研究者。群内主打实时论文跟踪与硬核技术探讨,拒绝灌水。
? 进群传送门:扫码进群或添加微信Vin_Vivid,备注:论文群 + 关注的 AI 方向。
搞科研/搞技术,信息差很重要。
来,一起快人一步!
上车,带你看遍全球 AI 顶会精华
可独家畅览:
专家演讲PPT
大会报告全文
热门论文解读
学术新星访谈
扫描上方二维码
或点击「阅读原文」关注专区。
