


来源:公众号|深度学习研究生
✨导读:多模态假新闻越来越像真的,因为图像、文字和常识可以被分别篡改。很多检测方法依赖特定伪造类型和大量标注数据,一旦遇到新型 manipulation 就容易失效。CORE 把问题重新定义为“冲突检测”:假新闻的核心往往是图文之间、图像内部、文字描述和世界知识之间存在不一致。论文构建了 1.4 万条 Conflict Attribution Corpus,并让多模态大模型学习显式冲突归因和推理,从而在少样本甚至零样本设置下适应新型伪造。
• 作者: Jinjie Shen; Yaxiong Wang; Yujiao Wu; Lechao Cheng; Tianrui Hui; Nan Pu; Zhihui Li; Zhun Zhong
• 单位: Hefei University of Technology; Wuhan University; Lab for Intelligence and visiON (LION); CSIRO; University of Science and Technology of China
• 论文标题: CORE: Conflict-Oriented Reasoning for General Multimodal Manipulation Detection
• 论文链接: https://arxiv\.org/pdf/2606\.03066v1
• 发表信息: ICML 2026
• 代码链接: https://github\.com/shen8424/CORE
• 数据集链接: https://github\.com/shen8424/CORE
多模态假新闻不再只是改一张图或写一段假文案。生成式 AI 可以同时制造图片、改写标题、替换人物身份、嫁接场景、伪造事件背景。对检测系统来说,难点不只是识别“有没有 P 图”,而是判断图像、文本和常识是否共同讲了一个可信故事。
已有方法通常会针对某一类 manipulation 训练检测器。例如,有的方法专门看图像篡改痕迹,有的方法专门建模图文不匹配,有的方法依赖大规模同类型伪造数据。它们在已知伪造类型上可能有效,但面对新类型时,很容易出现泛化断层。
CORE 的出发点是:不管伪造方式怎么变,许多假新闻都会留下“冲突”。这个冲突可能来自图像和文字不一致,也可能来自文字与世界知识不一致,还可能来自图像中的物理或语义关系不合理。与其追着每种新伪造设计新检测器,不如训练模型识别更底层的冲突结构。
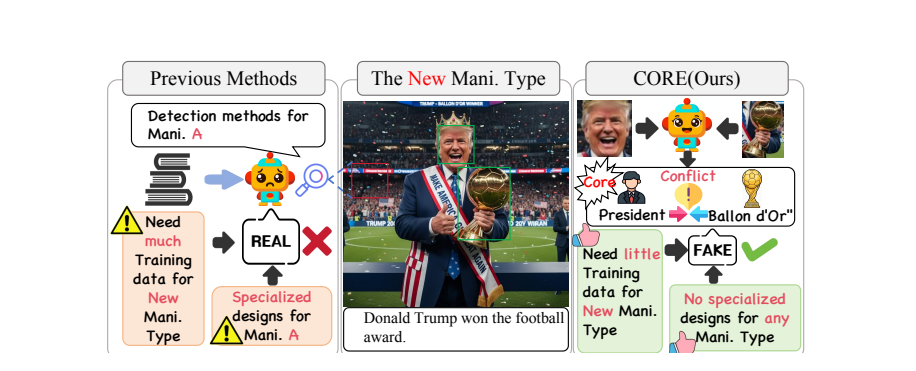
图1:CORE 的核心动机是从特定 manipulation 检测转向通用冲突推理。旧方法需要大量特定类型训练数据,而 CORE 试图用少量新类型样本快速适应。
CORE 的贡献可以从三个层面理解。
第一,论文提出了一个面向泛化的检测范式:把多模态 manipulation detection 建模为 conflict-oriented reasoning。模型不只是输出 real/fake,还要学习冲突因素和冲突来源。
第二,论文构建了 Conflict Attribution Corpus,简称 CAC。这个数据集包含 1.4 万个样本,每个样本不仅有图文对,还标注了冲突因素和冲突来源,为模型提供显式冲突监督。
第三,论文设计了 CORE 框架,让多模态大模型经历三个阶段:先做跨模态对齐,再做冲突感知预训练,最后用极少新类型样本快速适应。
如果一张图里是 A 人物,文字说的是 B 人物,这是明显的图文冲突。但现实中的多模态假新闻往往更隐蔽。例如,图片本身可能是真的,文字也语法通顺,但它把真实人物放进了错误事件;或者图片和标题都能对上,却和常识、时间线、地点背景冲突。
论文把冲突来源拆成三类:
1.Image conflict: 图像内容本身或视觉证据存在问题。
2.Caption conflict: 文本描述和视觉内容不匹配。
3.World knowledge conflict: 图文表面可对齐,但与真实世界知识冲突。
这也是 CORE 和普通图文匹配模型的区别。它不是只问“图文相似吗”,而是进一步问“它们共同表达的事件是否和可验证事实一致”。
论文还做了一个有意思的观察:多模态大模型本身拥有大量世界知识,但在检测任务中未必会主动调用这些知识形成清晰边界。换句话说,模型“知道”特朗普是美国总统,也可能“知道”金球奖属于足球语境,但它不一定能自动把这些知识组织成检测 fake news 的概念边界。CORE 试图把这种隐含知识转成显式冲突推理能力。
CAC 的构建从 SAMM 的 10 万个图文对出发。论文使用 Google Search API 补充背景知识,再引入 GPT-4o、Gemini2.5-Pro 和 Qwen3-VL-Plus 组成专家池,生成并交叉验证冲突理由。
最终每条样本包含四类信息:图像 I、文本 T、冲突因素 C,以及冲突来源 S。它不只是告诉模型“这是假的”,还告诉模型“为什么假”和“冲突从哪里来”。
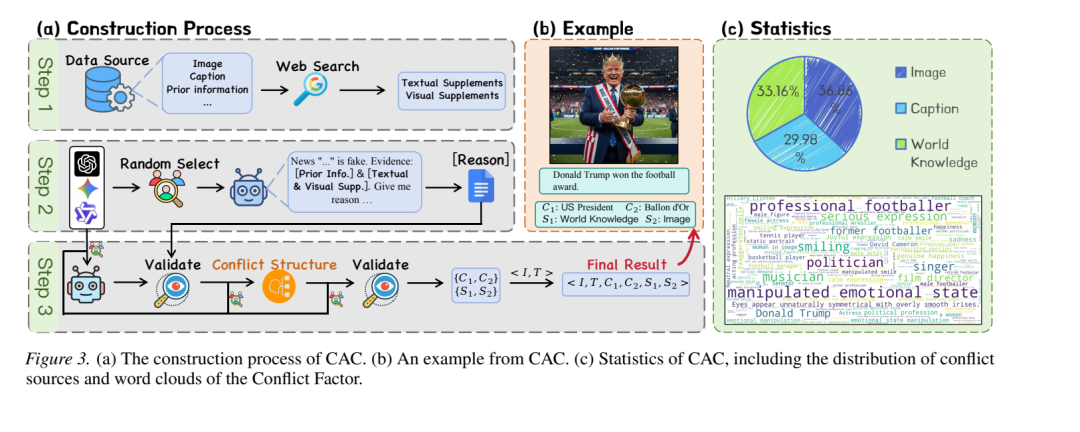
图2:CAC 的构建流程包括数据源、网络检索、专家模型生成冲突理由、交叉验证和结构化标注。统计上,冲突来源覆盖图像、caption 与世界知识三类。
从统计分布看,CAC 中冲突来源并不集中在单一模态:image 约 36.86%,caption 约 29.98%,world knowledge 约 33.16%。这个分布很重要,因为真实假新闻也不是只在某一个位置出错。模型必须学会跨模态、跨知识源检查,而不是把检测退化成图像分类或文本分类。
CORE 基于多模态大模型构建,论文实验中使用 Qwen2.5VL-3B 和 Gemma3-4B 作为主要 backbone,并使用 LoRA 进行训练。整体训练流程分为三个阶段。
第一阶段是 MBPT,也就是 multimodal bridge pre-training。它用 5 万条 FineHARD 样本训练 Cross-modal Aligner,让图像特征和语言模型空间更好对齐。这个阶段解决的是“视觉信息能不能被语言模型稳定读到”。
第二阶段是 CPT,也就是 conflict perception training。模型在 CAC 上学习冲突表示,使用 conflict-aware contrastive loss 和 conflict reasoning loss。一方面,模型要把有相似冲突结构的样本拉近,把冲突不同的样本拉远;另一方面,它要能用语言解释冲突。
第三阶段是 rapid adaptation。面对新 manipulation 类型时,模型只需要少量样本,甚至可以零样本,用简单指令“Is the news real or fake?” 适配新任务。
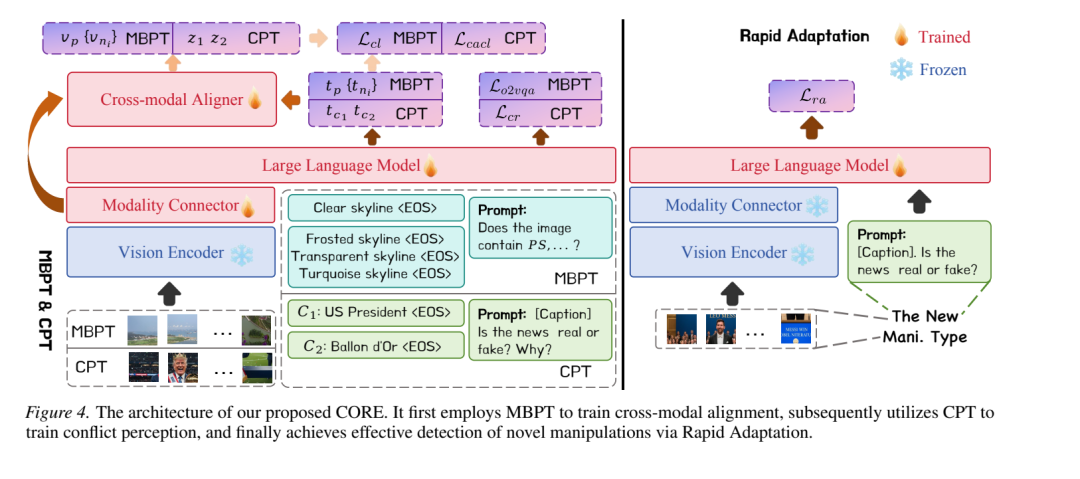
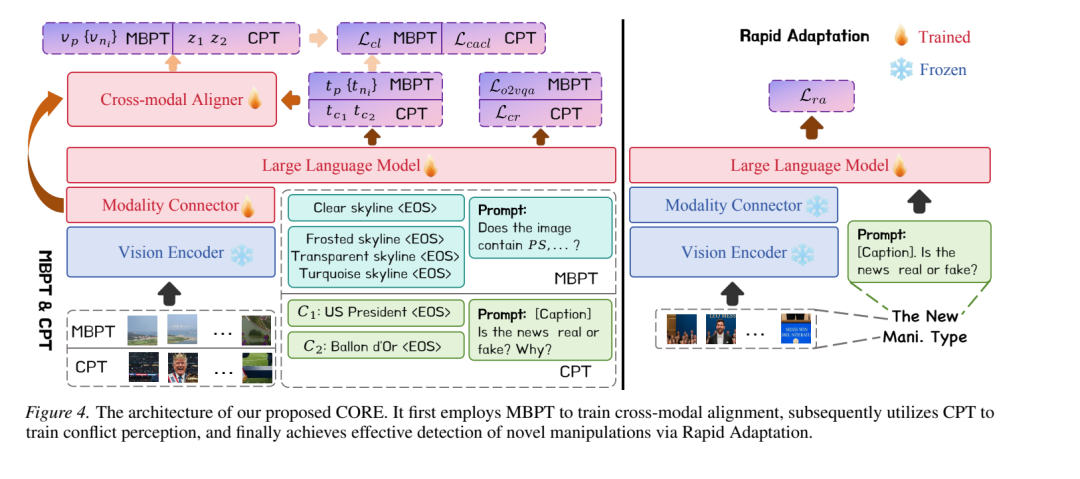
图3:CORE 框架先训练跨模态对齐,再通过 CAC 学习冲突感知表示和冲突推理,最后用少量新类型样本完成 rapid adaptation。
这种流程的关键不是把所有伪造类型都穷举出来,而是让模型在新任务中复用“冲突推理”这一底层能力。新伪造可以变化,但冲突结构仍然可被识别。
论文在 DGM4、MDSM、MMFakeBench 和 NewsCLIPpings 上做少样本实验。每个数据集只给 100、200、500、750 个样本,MMFakeBench 对应 100、200、300、350 个样本。
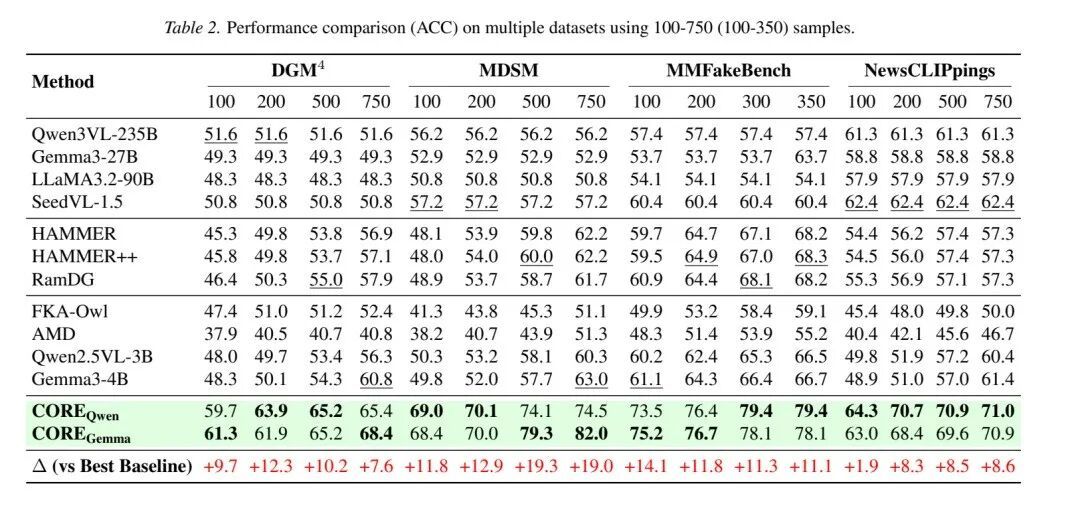
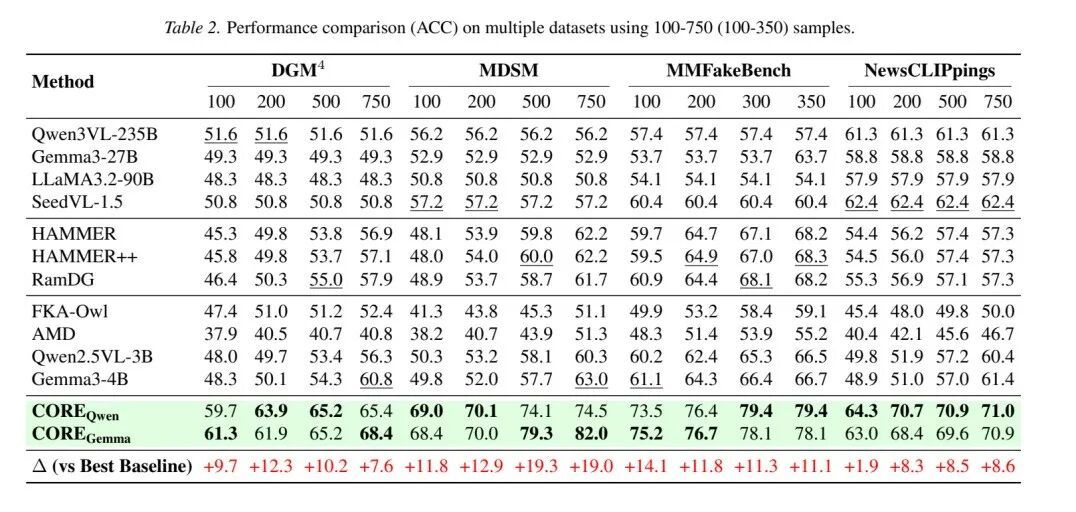
图4:CORE 在多个少样本设置下超过 Qwen3VL、Gemma、SeedVL、HAMMER、RamDG、FKA-Owl 等 baseline,尤其在样本数很少时提升明显。
结果非常直接。以 CORE_Qwen 为例:
1.在 DGM4 上,从 100 到 750 样本,准确率从 59.7 提升到 65.4。
2.在 MDSM 上,从 69.0 提升到 74.5。
3.在 MMFakeBench 上,从 73.5 提升到 79.4。
4.在 NewsCLIPpings 上,从 64.3 提升到 71.0。
CORE_Gemma 同样稳定,尤其在 MDSM 的 750 样本设置下达到 82.0,在 MMFakeBench 上也保持 78.1 左右的高水平。
论文汇总指出,CORE_Qwen 和 CORE_Gemma 分别比第二强 baseline 平均高 9.94% 和 10.50%。这说明冲突预训练带来的不是某个数据集上的偶然提升,而是跨数据集、跨 backbone 的泛化收益。
少样本之外,CORE 还评估了零样本表现和关键模块消融。
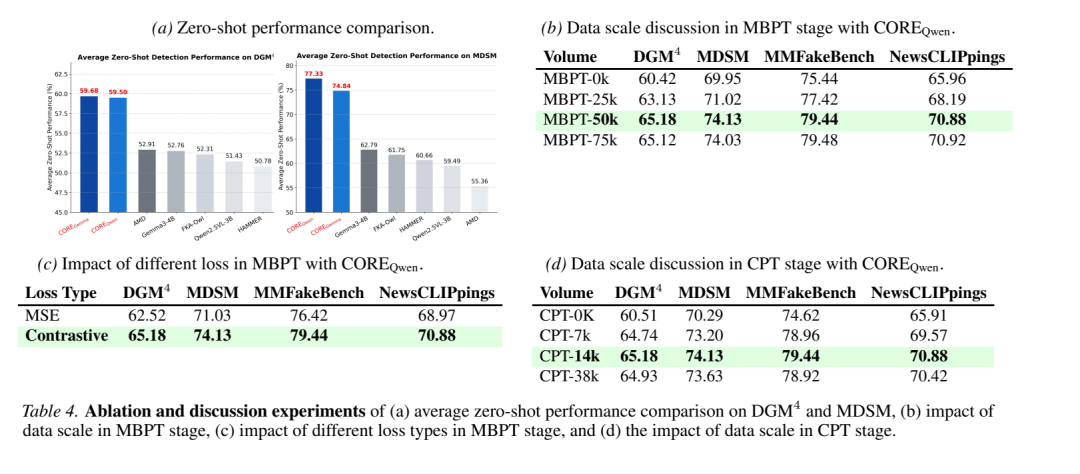
图5:CORE 的消融显示,MBPT 数据规模、CPT 数据规模和 contrastive loss 都会影响最终泛化。50k MBPT 与 14k CAC 基本形成较好平衡。
零样本设置下,CORE_Qwen 和 CORE_Gemma 也能超过多种 baseline。尤其在 MDSM 上,它们相对第二强方法有超过 14% 和 12% 的提升。这说明 CORE 学到的不是“记住某个数据集标签”,而是能迁移到未见 manipulation 类型的冲突判断能力。
消融实验进一步解释了提升来源:
1.MBPT 很重要。 不做 MBPT 时,CORE_Qwen 在四个少样本任务上的平均表现明显下降;从 0k 增加到 50k MBPT 数据带来约 4.47% 的平均提升。
2.Contrastive loss 比 MSE 更有效。 在 MBPT 阶段,用 contrastive loss 比 MSE 平均高约 2.67%,说明结构化区分不同样本关系很有帮助。
3.CPT 的 14k CAC 规模更合适。 不做 CPT 时平均下降约 4.58%;用 7k 样本已经接近完整表现,但 14k 最稳。继续扩到 38k 反而略有下降,说明数据质量和冲突标注一致性比单纯数量更重要。
论文后续还显示,去掉 conflict-aware contrastive loss 会带来很大性能下降,平均约 11.75%。这进一步说明:CORE 的关键不是简单多喂一些 fake news 数据,而是让模型在表示空间里学会区分冲突结构。
第一,泛化检测需要更抽象的监督信号。 如果监督只告诉模型 real/fake,它很容易学到数据集偏差。冲突因素和冲突来源提供了更接近因果解释的信号,让模型知道判假的依据。
第二,世界知识不能只存在于模型参数里。 MLLM 可能拥有知识,但如果任务训练没有要求它调用知识、解释冲突,它未必会在检测时用出来。CORE 的 CPT 阶段把世界知识冲突显式纳入训练目标,这是一个很有启发的设计。
第三,少样本适应比大规模闭集准确率更接近真实场景。 假新闻伪造方式会不断变化。检测系统如果只能在已知类型上刷高分,实际价值有限。CORE 把 rapid adaptation 作为核心设置,更符合新闻安全和内容审核的需求。
第四,解释能力可能本身就是鲁棒性的来源。 当模型被要求说明冲突因素和冲突来源时,它不再只是捕捉表面相关性,而是形成更结构化的判断路径。这可能也是 CORE 在新型 manipulation 上更稳的原因。
CORE 依赖 CAC 提供高质量冲突监督。论文使用多个强模型生成和验证冲突理由,但这种流程仍然可能继承专家模型的偏差。如果背景知识检索不完整,或者专家模型给出的理由存在遗漏,训练出的冲突边界也会受到影响。
另外,世界知识是动态的。人物身份、事件背景、地理政治信息都可能随时间变化。面向真实部署时,检测系统可能还需要接入更新的外部知识库,而不仅仅依赖训练时写入的参数知识。
不过,CORE 提出的方向仍然很有价值:把真假检测从“看痕迹”提升到“找矛盾”,这是通用化多模态安全系统必须迈出的一步。
CORE 的贡献可以总结为四点:
1.将多模态 manipulation detection 重新建模为 conflict-oriented reasoning。
2.构建 1.4 万条 CAC,为冲突因素和冲突来源提供细粒度监督。
3.通过 MBPT、CPT 和 rapid adaptation,让 MLLM 学会跨模态冲突表示和冲突解释。
4.在少样本和零样本新类型检测中显著超过多种 baseline。
对多模态假新闻检测来说,CORE 的意义在于:模型不应该只学习某种伪造痕迹,而应该学习“哪里不一致、为什么不一致、这种不一致是否足以支持 fake 判断”。当伪造技术不断变化时,冲突推理可能比类型分类更可靠。
原文链接: https://www.leiphone.com/category/private/mk6gboBuRuSa6qb0.html
